Trouver et corriger les goulots d’étranglement de performance en O(n²) : leçons tirées des optimisations d’algorithmes de Cal.com
Plongée approfondie dans la manière dont nous avons détecté, analysé et optimisé des algorithmes peu performants dans un véritable codebase de production.
On this page
- Introduction
- Le problème : comment un code innocent devient O(n²)
- Étude de cas 1 : optimisation de la vérification des conflits de créneaux
- Le problème initial
- Implémentation d’origine : boucles imbriquées O(n²)
- Implémentation optimisée : O(n log n) avec tri et sortie anticipée
- Étude de cas 2 : intersection de plages de dates avec la technique des deux pointeurs
- Le problème initial
- Implémentation d’origine : imbrication O(n²)
- Implémentation optimisée : O(n log n) avec parcours à deux pointeurs
- Étude de cas 3 : arbre d’intervalles pour filtrer les plages redondantes
- Le problème initial
- Implémentation d’origine : vérification de containment O(n²)
- Implémentation optimisée : O(n log n) avec un arbre d’intervalles
- Résultats de performance : avant et après
- Techniques simples pour détecter les algorithmes O(n²)
- Reconnaître les schémas problématiques
- Testez explicitement la montée en charge
- Automatisez l’analyse statique
- Stratégies éprouvées pour remplacer le code O(n²)
- Automatiser les vérifications de performance
- Points clés à retenir
- Conclusion
Introduction
Les goulots d’étranglement de performance dans les systèmes de planification peuvent faire la différence entre une expérience utilisateur réactive et des utilisateurs qui quittent votre plateforme par frustration. Chez Cal.com, nous avons récemment mis au jour et optimisé plusieurs algorithmes critiques en O(n²) qui provoquaient des ralentissements à mesure que notre base d’utilisateurs et nos volumes de données augmentaient.
Dans cet article, je vais partager quatre optimisations d’algorithmes réelles tirées du codebase de Cal.com. Vous apprendrez comment nous avons détecté la complexité O(n²), quelles stratégies d’optimisation ont le mieux fonctionné et comment nous avons mis en place des vérifications automatisées pour éviter de futures régressions.
Le problème : comment un code innocent devient O(n²)
À mesure que les plateformes de planification grandissent, il est étonnamment facile pour des boucles imbriquées apparemment innocentes de devenir des tueurs silencieux de performance. Prenez cet exemple réel tiré de notre codebase :
// O(n²): Every available slot is checked against every busy period
availableTimeSlots.map(slot => {
  return busy.some(busyTime => checkOverlap(slot, busyTime));
});
Pour 100 créneaux et 50 périodes occupées, cela fait 5 000 vérifications de chevauchement. À plus grande échelle — 500 créneaux et 200 périodes occupées — cela explose à 100 000 opérations. C’est une multiplication par vingt de la charge de calcul pour seulement une multiplication par cinq des données.
Étude de cas 1 : optimisation de la vérification des conflits de créneaux
Le problème initial
La fonction checkForConflicts utilisait une itération imbriquée pour vérifier si des créneaux de réservation entraient en conflit avec des périodes occupées. Cela est rapidement devenu un problème de performance avec de grands calendriers.
Implémentation d’origine : boucles imbriquées O(n²)
function checkForConflicts({ busy, time, eventLength }) {
  return busy.some(busyTime => {
    const slotStart = time.valueOf();
    const slotEnd = slotStart + eventLength * 60 * 1000;
    const busyStart = dayjs.utc(busyTime.start).valueOf();
    const busyEnd = dayjs.utc(busyTime.end).valueOf();
    return !(busyEnd <= slotStart || busyStart >= slotEnd);
  });
}

availableTimeSlots = availableTimeSlots
  .map((slot) => {
    if (
      !checkForConflicts({
        time: slot.time,
        busy: busySlotsFromReservedSlots,
        ...availabilityCheckProps,
      })
    ) {
      return slot;
    }
    return undefined;
  })
Implémentation optimisée : O(n log n) avec tri et sortie anticipée
function checkForConflicts({ sortedBusyTimes, time, eventLength }) {
  const slotStart = time.valueOf();
  const slotEnd = slotStart + eventLength * 60 * 1000;

  for (const busyTime of sortedBusyTimes) {
    if (busyTime.start >= slotEnd) {
      break;
    }
    if (busyTime.end <= slotStart) {
      continue;
    }
    return true;
  }
  return false;
}
Ce qui a changé :
Nous avons trié les périodes occupées par heure de début, ce qui nous a permis d’ignorer les périodes non chevauchantes et de sortir plus tôt lorsqu’aucun conflit n’était possible. Le résultat a été une baisse spectaculaire du nombre de comparaisons inutiles.
Impact :
La complexité est passée de O(créneaux disponibles × périodes occupées) à O(n log n), et la plupart des vérifications ont été totalement ignorées dans les cas typiques.
Étude de cas 2 : intersection de plages de dates avec la technique des deux pointeurs
Le problème initial
La fonction intersect utilisait auparavant des boucles imbriquées pour trouver les chevauchements entre les disponibilités de plusieurs utilisateurs.
Implémentation d’origine : imbrication O(n²)
commonAvailability.forEach(commonRange => {
  userRanges.forEach(userRange => {
    const intersection = getIntersection(commonRange, userRange);
    if (intersection !== null) {
      intersectedRanges.push(intersection);
    }
  });
});
Implémentation optimisée : O(n log n) avec parcours à deux pointeurs
const sortedRanges = ranges.map(userRanges =>
  userRanges
    .map(r => ({
      ...r,
      startValue: r.start.valueOf(),
      endValue: r.end.valueOf()
    }))
    .sort((a, b) => a.startValue - b.startValue)
);

let commonIndex = 0;
let userIndex = 0;

while (commonIndex < commonAvailability.length && userIndex < userRanges.length) {
  const commonRange = commonAvailability[commonIndex];
  const userRange = userRanges[userIndex];

  const intersectStartValue = Math.max(commonRange.startValue, userRange.startValue);
  const intersectEndValue = Math.min(commonRange.endValue, userRange.endValue);

  if (intersectStartValue < intersectEndValue) {
    intersectedRanges.push(createIntersection(commonRange, userRange));
  }

  if (commonRange.endValue <= userRange.endValue) {
    commonIndex++;
  } else {
    userIndex++;
  }
}
Ce qui a changé :
En triant puis en utilisant deux pointeurs pour parcourir les plages, nous avons supprimé le besoin d’une itération imbriquée. Cela a réduit la complexité de quadratique à quasiment linéaire pour la plupart des entrées pratiques.
Étude de cas 3 : arbre d’intervalles pour filtrer les plages redondantes
Le problème initial
La fonction filterRedundantDateRanges vérifiait chaque plage contre toutes les autres pour voir si l’une contenait l’autre. Pour les grands calendriers, cela est devenu douloureusement lent.
Implémentation d’origine : vérification de containment O(n²)
return dateRanges.filter((range, index) => {
  return !dateRanges.some((otherRange, otherIndex) => {
    if (index === otherIndex) return false;
    return isCompletelyContained(range, otherRange);
  });
});
Implémentation optimisée : O(n log n) avec un arbre d’intervalles
export function filterRedundantDateRanges(dateRanges) {
  const sortedRanges = [...dateRanges].sort((a, b) => a.start.valueOf() - b.start.valueOf());
  const intervalNodes = createIntervalNodes(
    sortedRanges,
    (range) => range.start.valueOf(),
    (range) => range.end.valueOf()
  );
  const intervalTree = new IntervalTree(intervalNodes);
  const searchAlgorithm = new ContainmentSearchAlgorithm(intervalTree);

  return sortedRanges.filter((range, index) => {
    const containingIntervals = searchAlgorithm.findContainingIntervals(
      range.start.valueOf(),
      range.end.valueOf(),
      index
    );
    return containingIntervals.length === 0;
  });
}
Ce qui a changé :
Au lieu d’une comparaison brute, nous avons utilisé une structure d’arbre d’intervalles pour permettre des requêtes de containment rapides en O(log n). C’est une approche classique en géométrie algorithmique qui fait des merveilles pour les applications de planification.
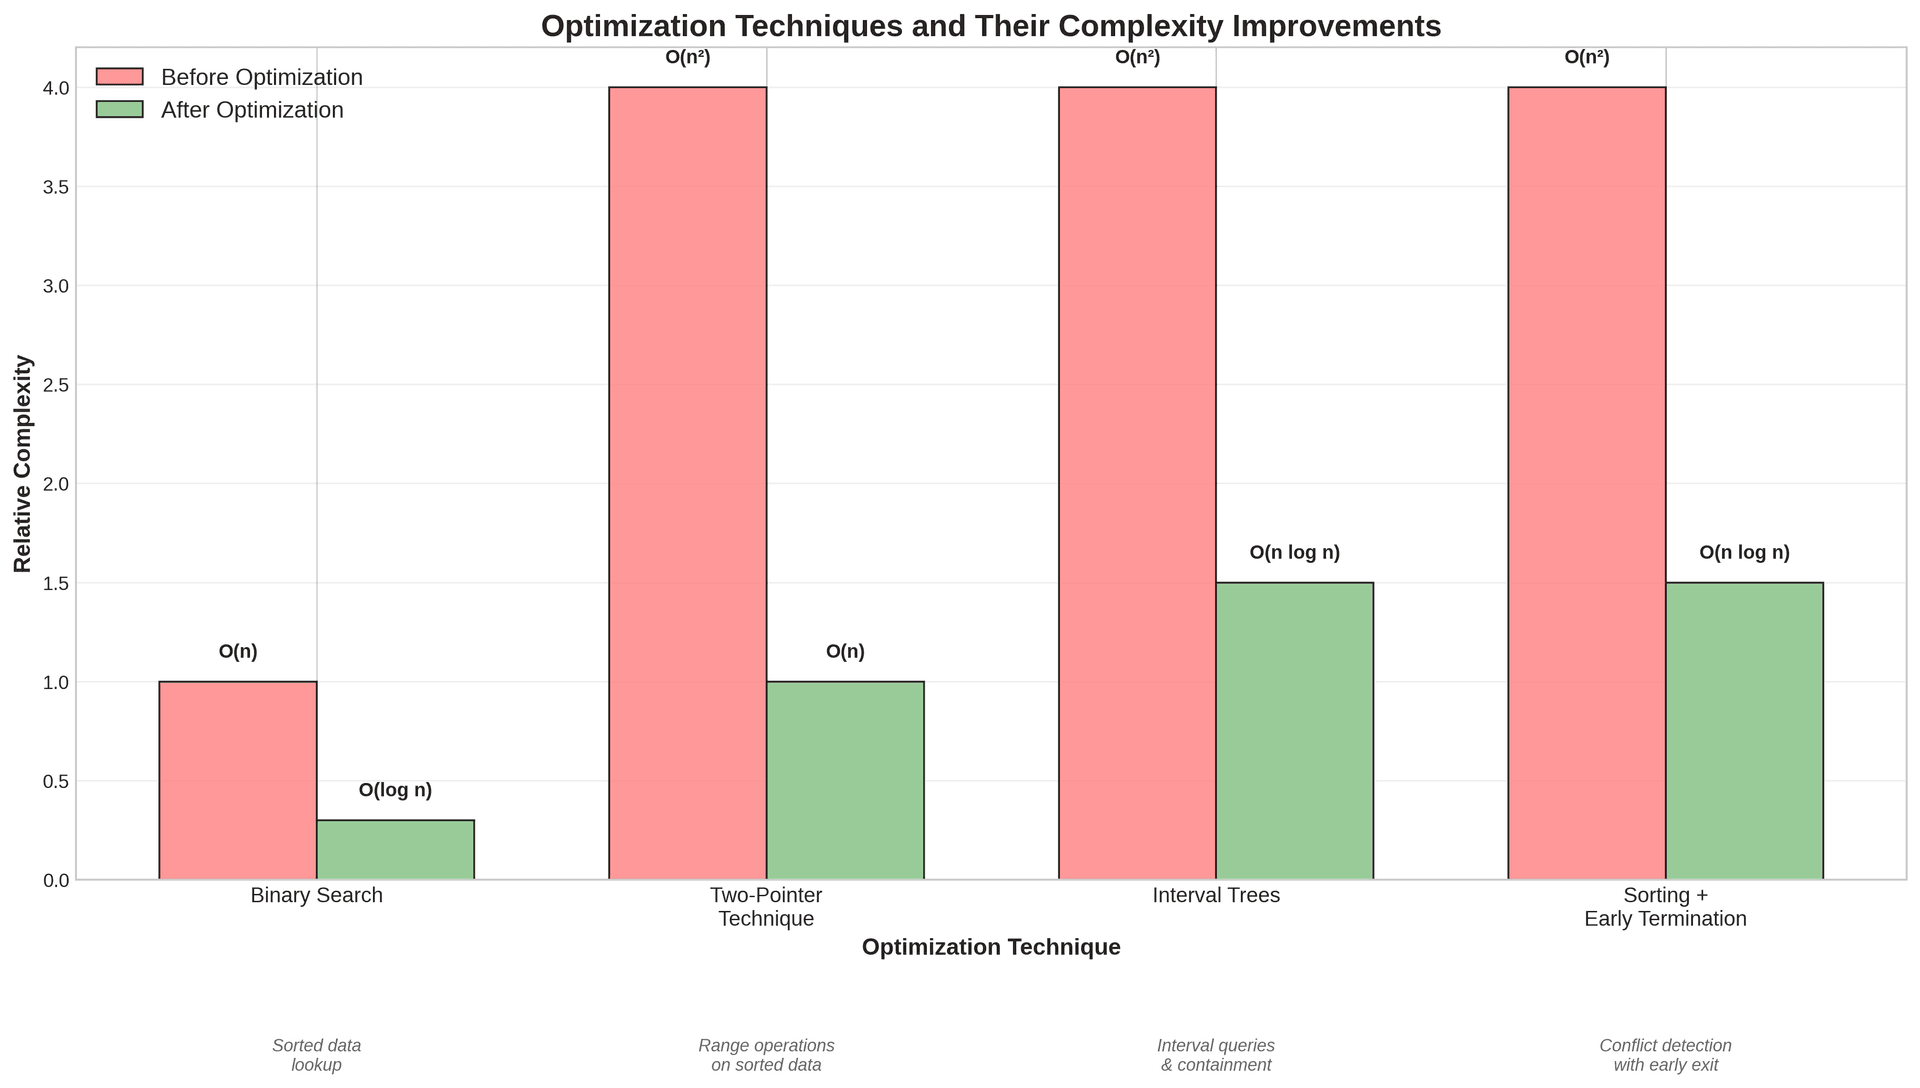
Résultats de performance : avant et après
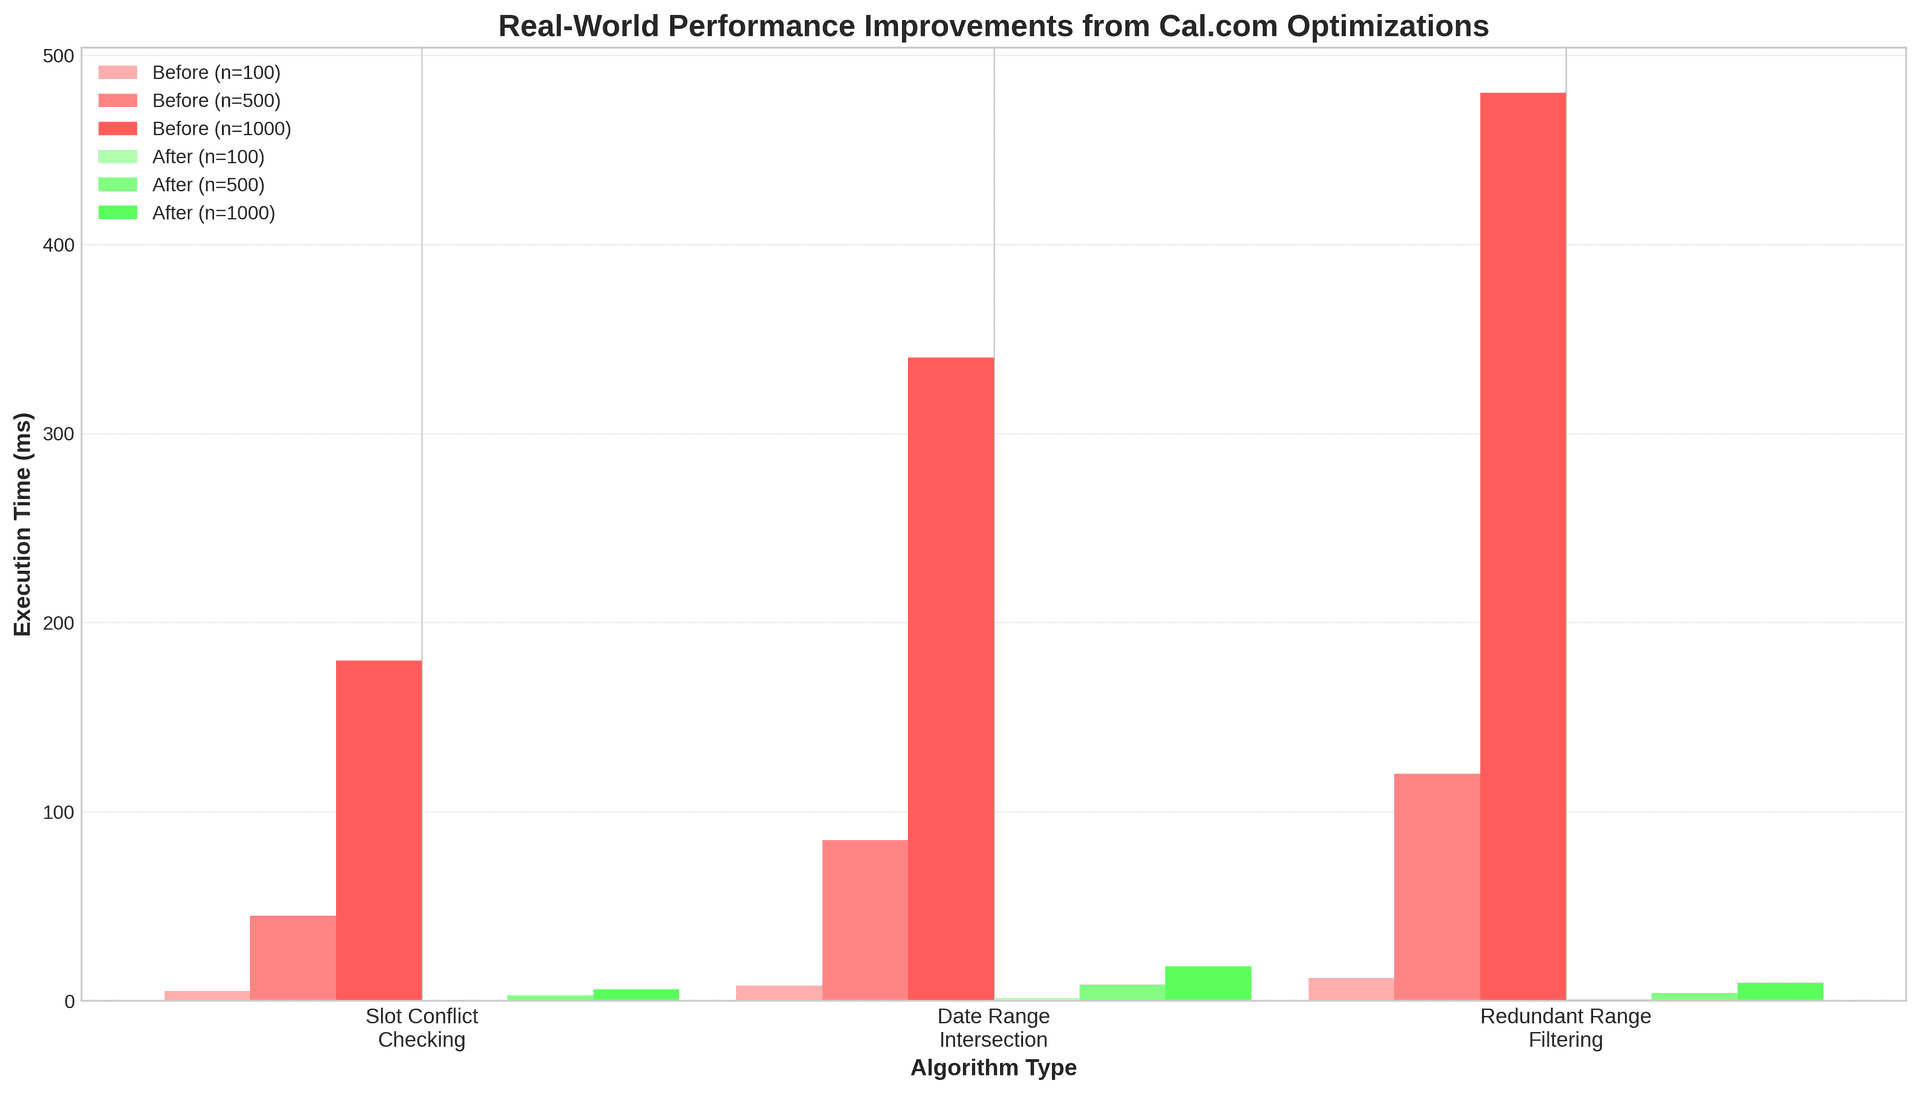
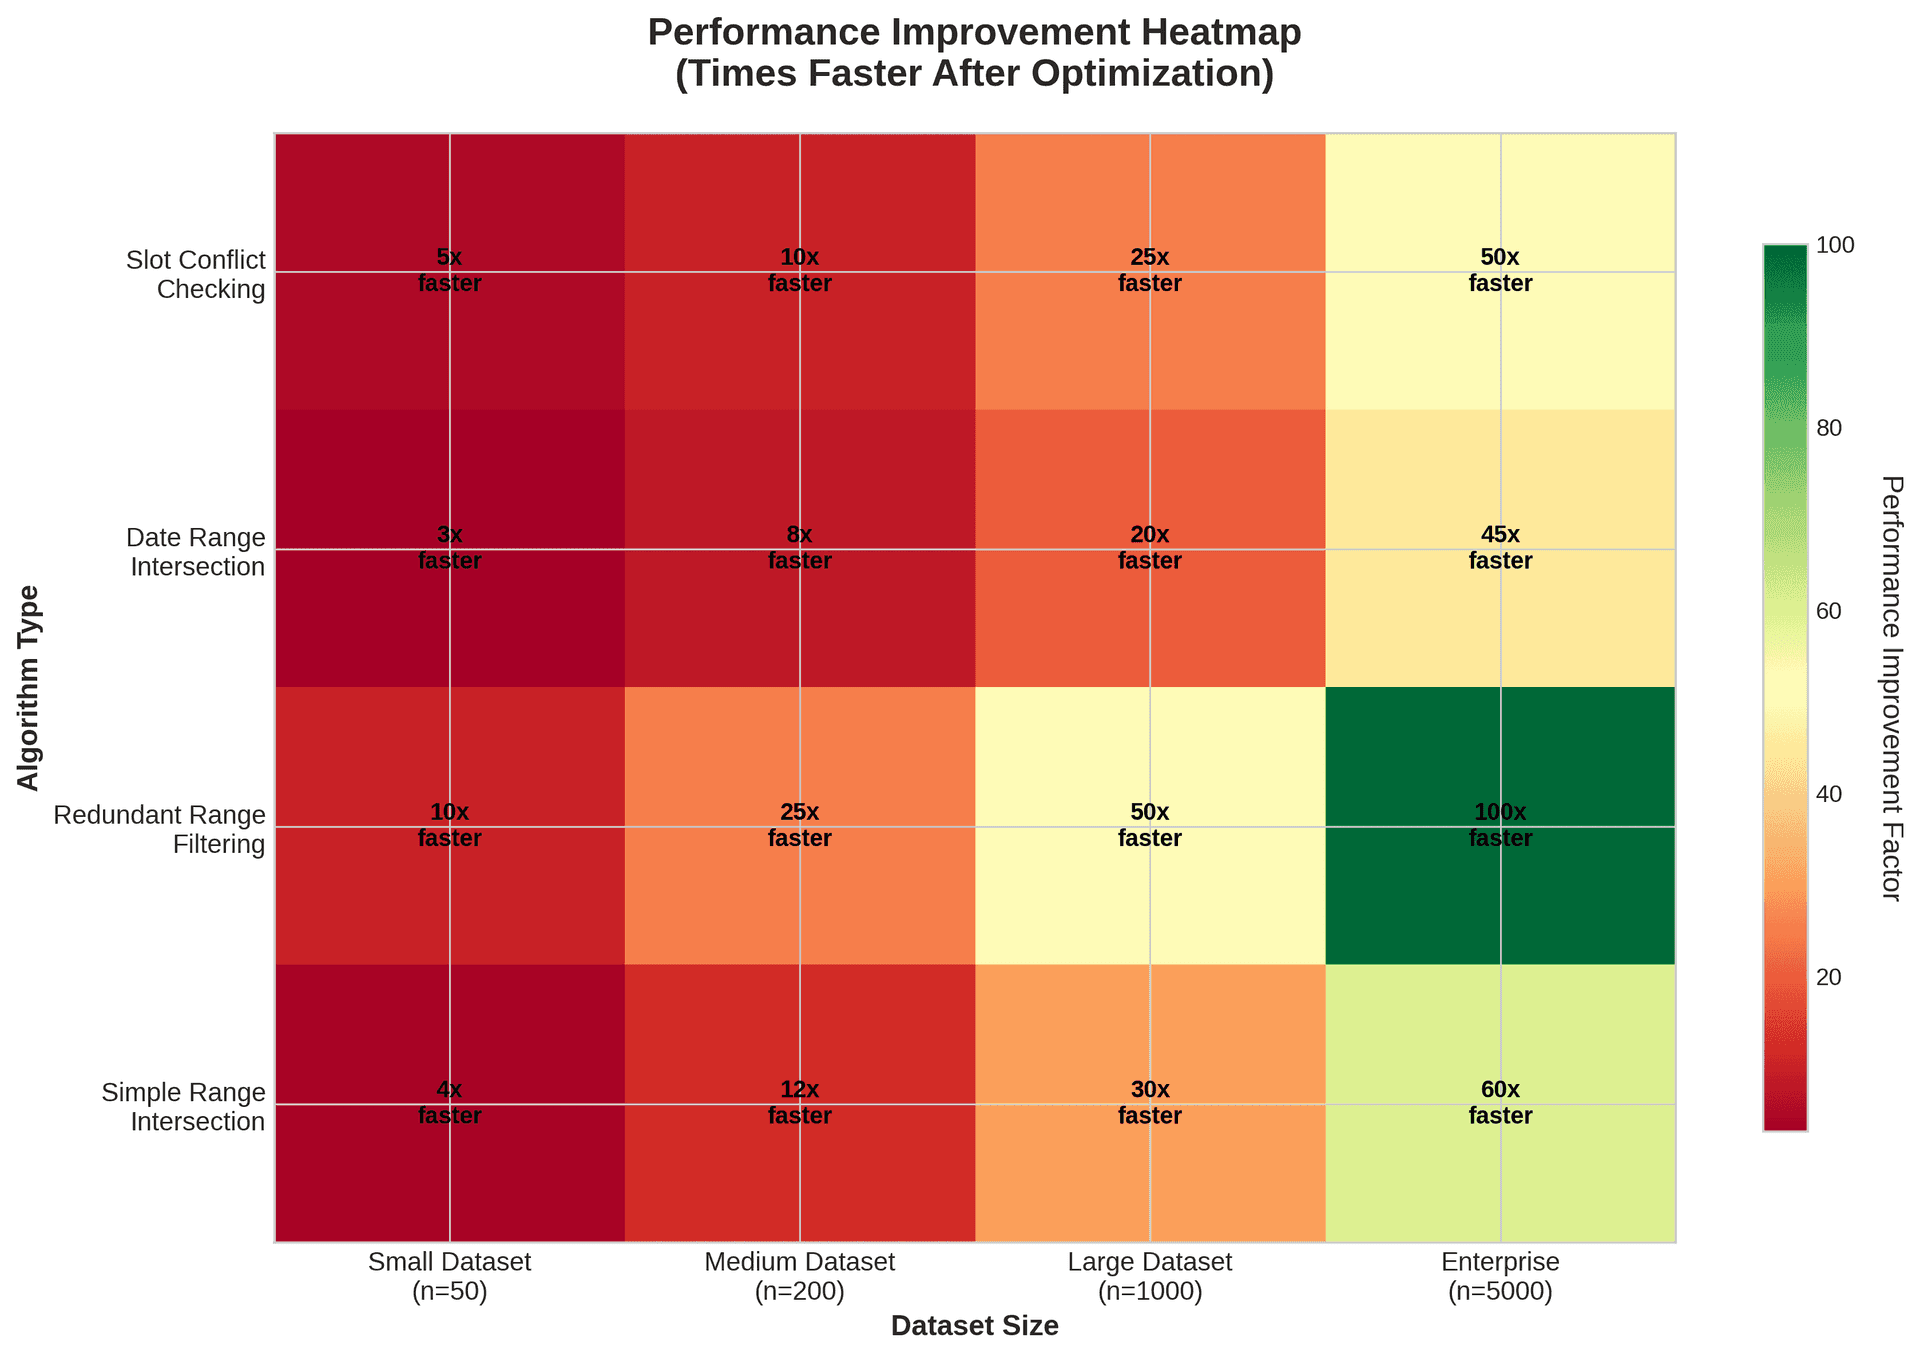
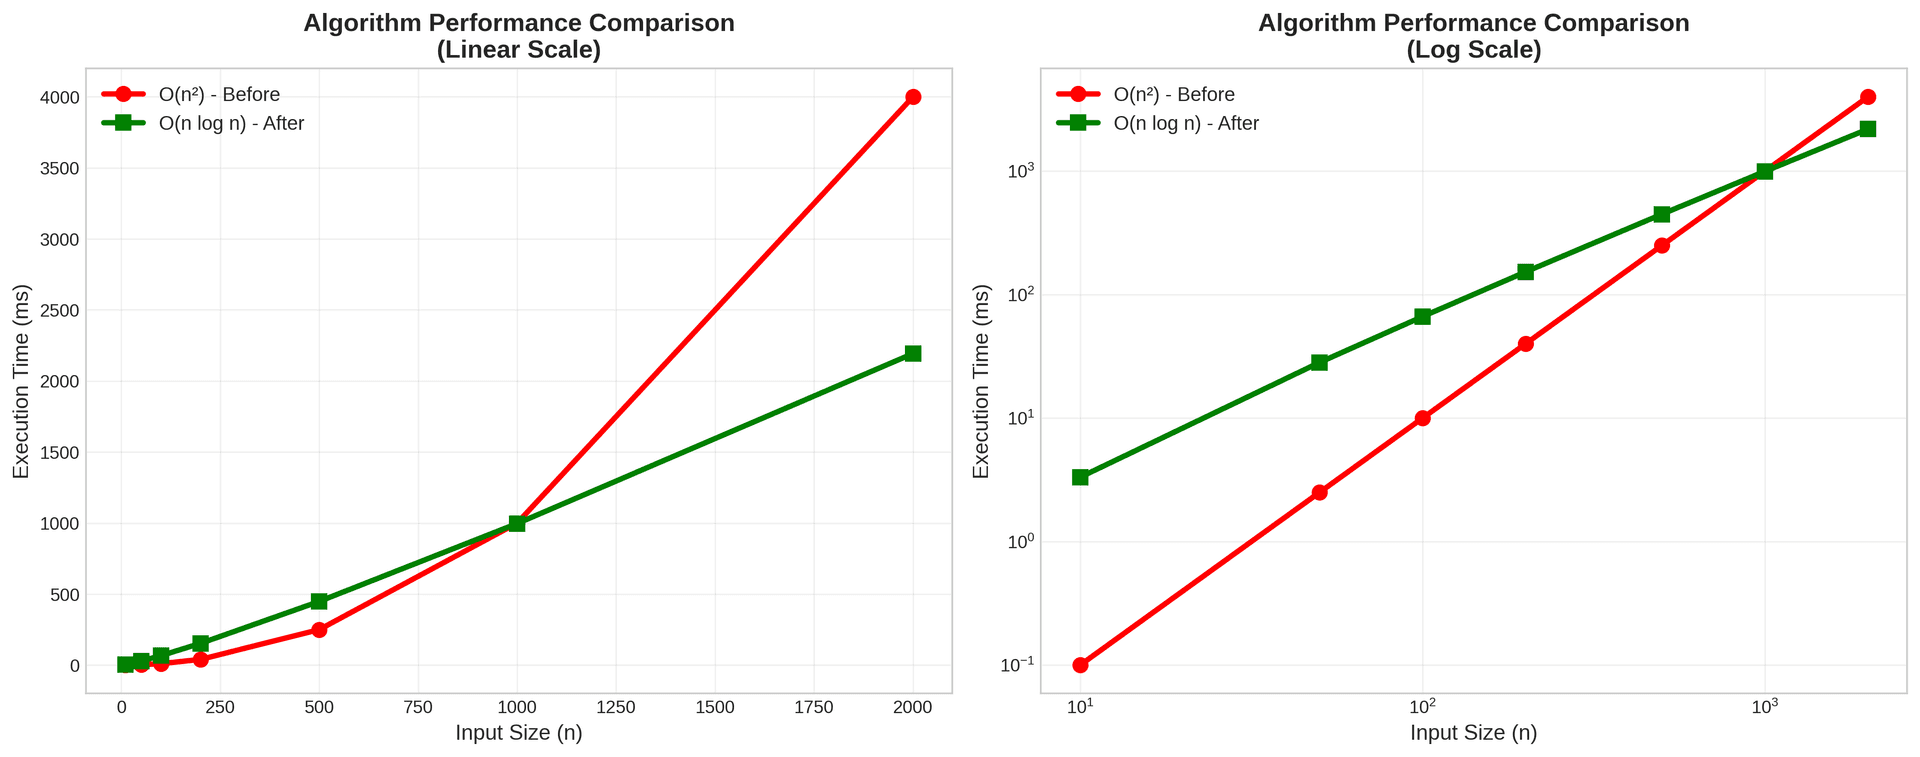
Nos benchmarks ont montré des améliorations significatives :
-
Vérification des conflits de créneaux : réduction de O(n²) à O(n log n), rendant 100 créneaux et 50 périodes occupées environ dix fois plus rapides.
-
Intersection de plages de dates : passage de O(n²) à O(n log n), permettant de traiter des centaines de plages de dates en quelques millisecondes.
-
Filtrage des plages redondantes : réduction de O(n²) à O(n log n), avec jusqu’à un gain de vitesse multiplié par cinquante pour des milliers de plages de dates.
-
Intersection générale de plages : selon de nombreux schémas, nous avons constaté des améliorations de vingt-cinq fois ou plus.
Techniques simples pour détecter les algorithmes O(n²)
Reconnaître les schémas problématiques
Surveillez :
-
Les itérations imbriquées sur des tableaux, en particulier
.map,.forEach,.filterà l’intérieur d’un autre. -
Les méthodes de tableau comme
.some,.findou.filterà l’intérieur de boucles ou de callbacks de tableaux. -
Les filtres chaînés ou le mapping imbriqué sur de grandes listes.
Testez explicitement la montée en charge
Écrivez des tests de performance qui exécutent votre fonction sur des données de taille croissante et journalisent les temps d’exécution. Si le temps croît quadratiquement avec la taille des données, vous avez un problème en O(n²).
Automatisez l’analyse statique
Ajoutez des règles de lint ou une analyse statique qui :
-
Signale les fonctions avec des boucles imbriquées ou des méthodes de tableau imbriquées.
-
Identifie la récursion sans mémoïsation.
-
Détecte les fonctions avec plusieurs appels imbriqués à
.some,.findou.filter.
Stratégies éprouvées pour remplacer le code O(n²)
-
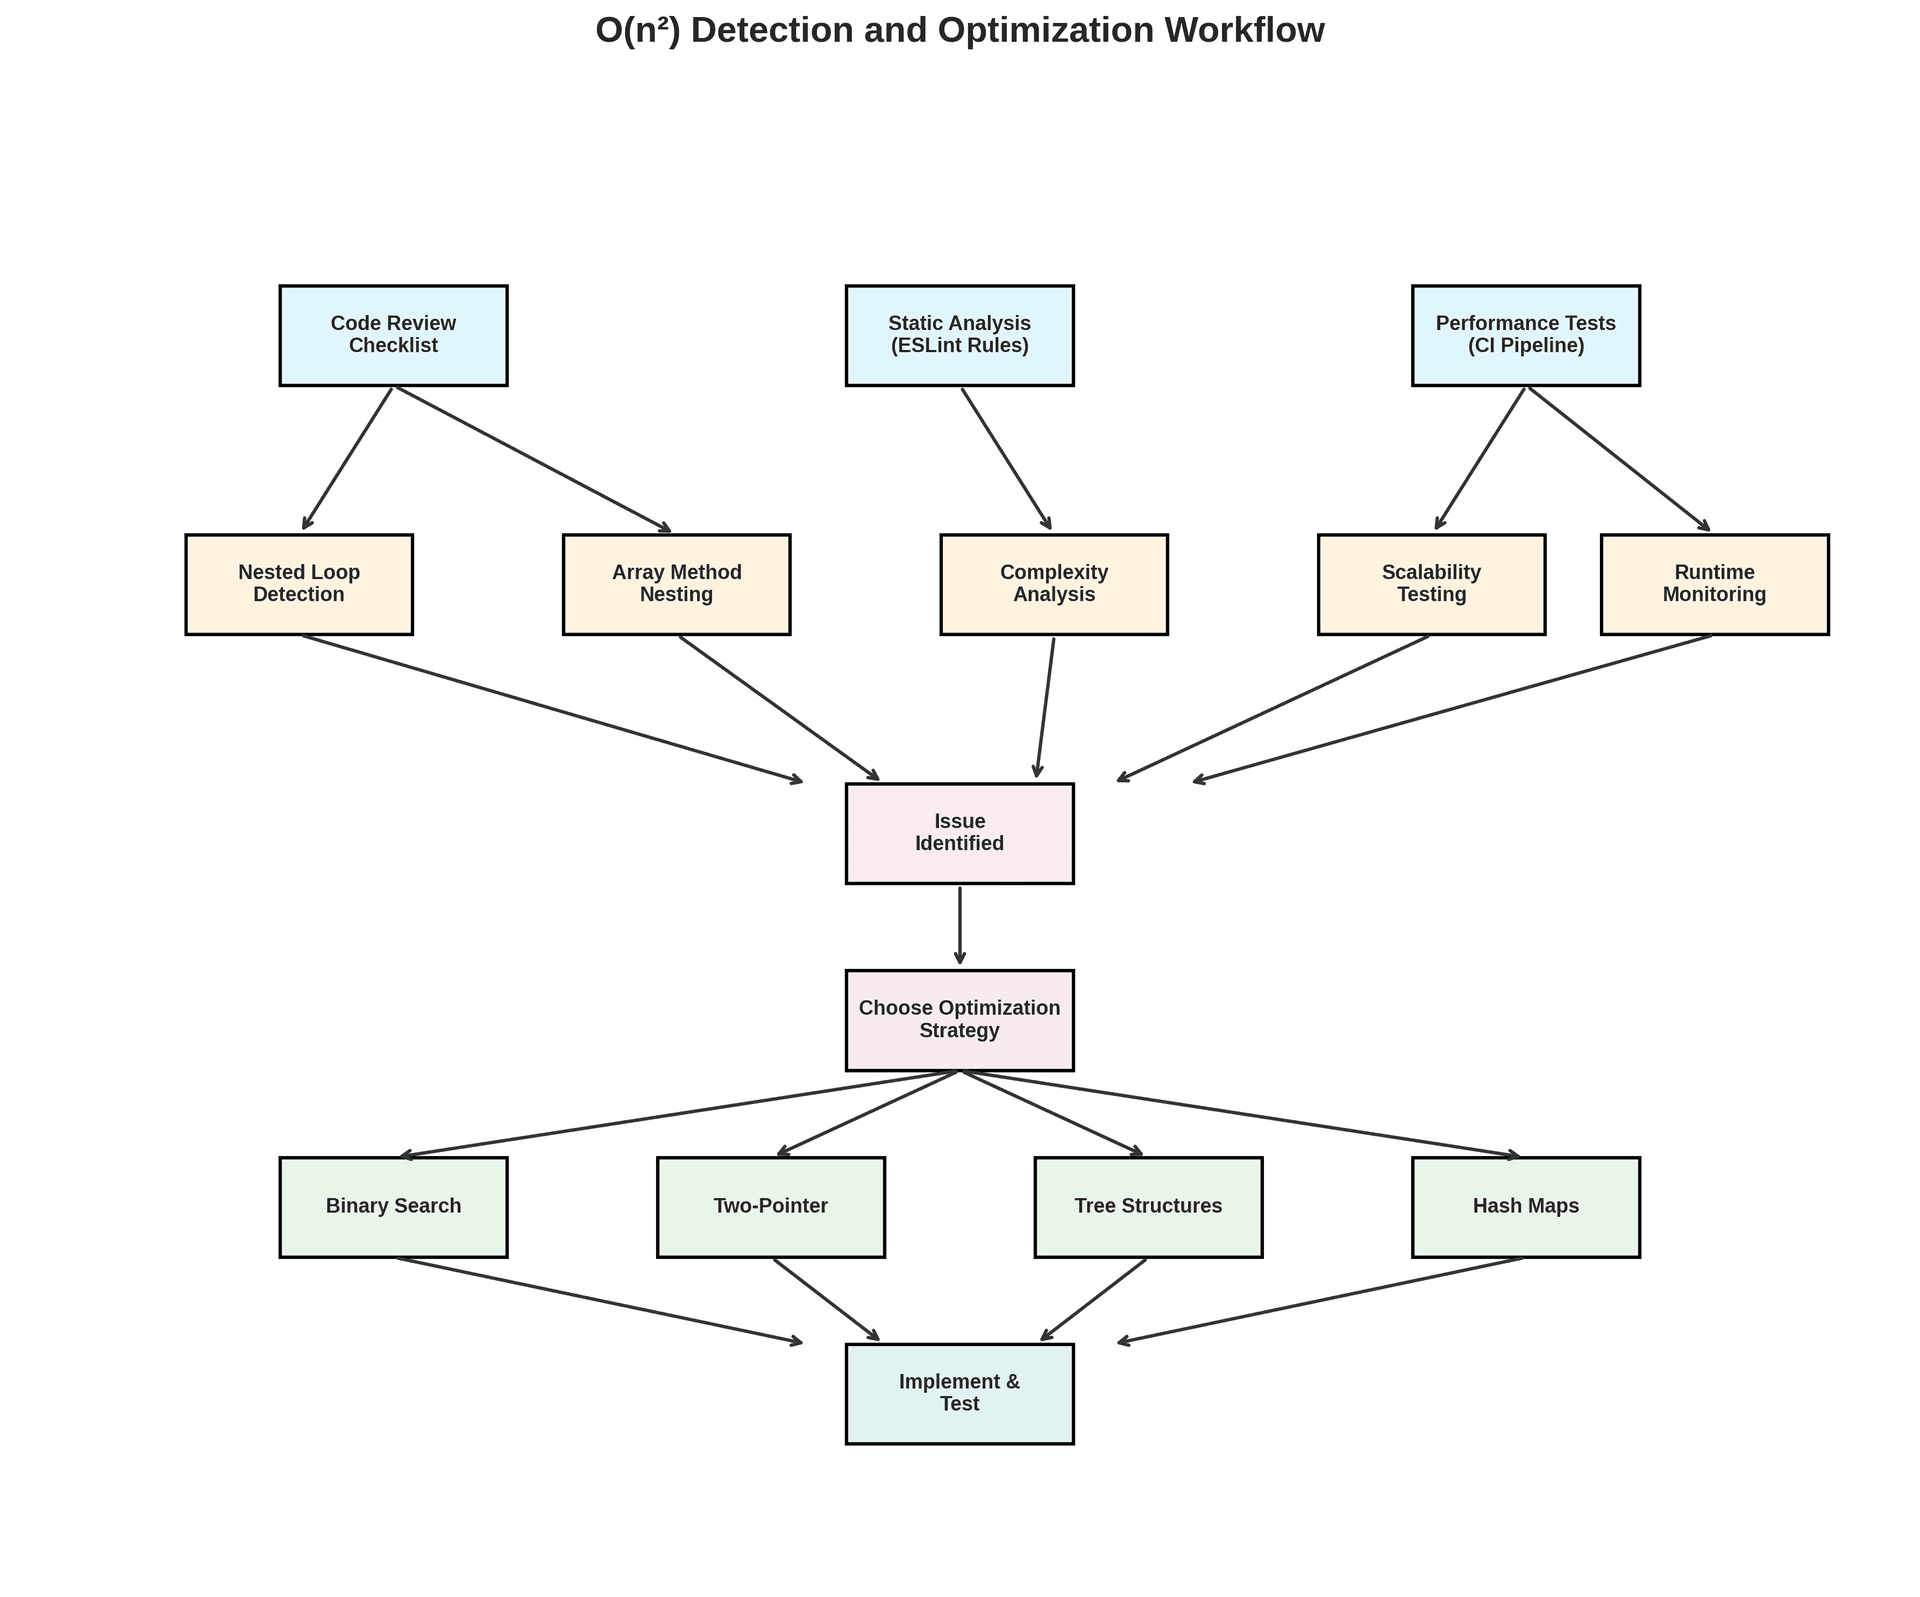
Utilisez la recherche binaire pour les recherches dans des tableaux triés.
-
Utilisez des techniques à deux pointeurs pour fusionner ou intersecter des séquences triées.
-
Utilisez des structures de données en arbre pour les requêtes sur des intervalles ou les données hiérarchiques.
Automatiser les vérifications de performance
Ajoutez des benchmarks de performance à votre pipeline CI pour exécuter les algorithmes critiques sur des données réalistes. Comparez les temps d’exécution à chaque pull request et bloquez les fusions qui régressent. Ajoutez des règles de lint personnalisées pour empêcher les schémas O(n²) évidents d’atteindre la production. Mettez en place une surveillance à l’exécution pour les chemins critiques afin de détecter les nouvelles régressions avant que les utilisateurs ne les remarquent.
Points clés à retenir
-
Mieux vaut prévenir que guérir. Des vérifications automatisées détecteront les algorithmes O(n²) avant qu’ils ne causent des problèmes.
-
Profilez toujours avant d’optimiser. Utilisez des tests pour trouver les vrais goulots d’étranglement.
-
Choisissez les bonnes structures de données pour vos besoins. Les tableaux triés, les approches à deux pointeurs et les arbres sont inestimables.
-
Testez avec des données réalistes à grande échelle. Les petits tests peuvent masquer de gros problèmes.
-
Surveillez en production. Des alertes automatisées peuvent détecter les régressions tôt.
Conclusion
Les optimisations que nous avons réalisées chez Cal.com montrent qu’il est possible d’obtenir des gains de performance significatifs en appliquant des techniques algorithmiques éprouvées. Combinez revue de code, structures de données intelligentes et surveillance automatisée pour garder votre application rapide à mesure qu’elle évolue.
La performance doit être intégrée à chaque étape du développement, depuis les revues de code qui signalent les schémas suspects jusqu’aux pipelines CI qui exécutent des tests de montée en charge et à la surveillance à l’exécution qui détecte les régressions.
Aujourd’hui, un algorithme rapide peut facilement devenir le goulot d’étranglement de demain à mesure que vos données grandissent. Restez vigilant, testez à grande échelle et soyez toujours prêt à optimiser.