Engineering 2026 und darüber hinaus
Wir bauen eine Infrastruktur, die fast nie ausfallen darf. Um das zu erreichen, bewegen wir uns schnell und liefern dabei Software in herausragender Qualität ohne Abkürzungen oder Kompromisse aus. Dieses Dokument beschreibt die Engineering-Standards, die uns durch 2026 und darüber hinaus leiten werden.
On this page
- Teamstruktur
- Unsere bisherigen Ergebnisse
- Die Foundation von Cal.com ermöglicht Exzellenz für coss.com
- Kernprinzipien
- 1. Keine aufgeschobene Qualität
- 2. Hohe Standards im Code Review
- 3. Fordert euch gegenseitig auf, das Richtige zu tun
- 4. Strebe nach Einfachheit
- 5. Automatisiere alles
- Architektonische Standards
- Vertical Slice Architecture: packages/features
- Warum vertikale Schnitte wichtig sind
- Leitlinien für die Funktionsorganisation
- Vorteile
- Repository-Pattern und Dependency Injection
- Data Transfer Objects (DTOs)
- Domain-Driven-Design-Patterns
- Konsistenz der Codebasis
- Bedingungen an den Einstiegspunkt der Anwendung verschieben
- Warum das wichtig ist
- So erreichst du das
- API-Design: Schlanke Controller und HTTP-Abstraktion
- API-Versionierung und Breaking Changes
- Performance und algorithmische Komplexität
- Denk ab dem ersten Tag an Skalierung
- Wähle die richtigen Datenstrukturen und Algorithmen
- Automatisierte Performance-Checks
- Performance ist ein Feature
- Die NP-schwere Realität der Terminplanung
- Anforderungen an die Codeabdeckung
- Erfolg messen
Teamstruktur
Unsere Engineering-Organisation besteht aus fünf Kernteams, von denen jedes klar definierte Verantwortlichkeiten hat:
-
Foundation-Team: Konzentriert sich darauf, Coding-Standards und architektonische Muster zu etablieren und zu pflegen. Dieses Team arbeitet eng mit anderen Teams zusammen, um unternehmensweit Best Practices zu schaffen.
-
Consumer-, Enterprise- und Platform-Teams: Produktorientierte Teams, die Funktionen schnell ausliefern und dabei die in diesem Dokument festgelegten Qualitätsstandards einhalten. Diese Teams zeigen, dass Geschwindigkeit und Qualität sich nicht ausschließen.
-
Community-Team: Verantwortlich dafür, PRs aus der Open-Source-Community schnell zu prüfen, Feedback zu geben und die Arbeit bis zum Merge zu begleiten. Dieses Team sorgt dafür, dass unsere Open-Source-Beitragenden eine großartige Erfahrung haben und ihre Beiträge unseren Qualitätsstandards entsprechen. Eine starke Open-Source-Kultur prägt weiterhin, wie Cal.com Engineering-Zusammenarbeit und Produktentwicklung angeht.
Unsere bisherigen Ergebnisse
Die Daten sprechen für sich. In den letzten anderthalb Jahren haben wir die Art und Weise, wie wir Software bauen, grundlegend verändert:

Wir haben unseren Engineering-Durchsatz ungefähr verdoppelt und gleichzeitig die Qualität verbessert. Noch beeindruckender ist die Veränderung dessen, was wir bauen:

Wir haben erfolgreich ungefähr 20 % der Engineering-Arbeit von Fixes weg und hin zu Features, Performance-Verbesserungen, Refactorings und Aufgaben verlagert. Diese Verschiebung zeigt, dass Investitionen in Qualität und Architektur dich nicht ausbremsen. Sie beschleunigen dich.
Die Foundation von Cal.com ermöglicht Exzellenz für coss.com
-
Cal.com ist ein stabiles, profitables Unternehmen, das wir weiter wachsen lassen werden.
- Dieser Erfolg verschafft uns einen einzigartigen Vorteil, während wir coss.com aufbauen. Anders als in den frühen Tagen von Cal.com, als wir schnell vorankommen mussten, um Product-Market-Fit zu erreichen und ein nachhaltiges Geschäft aufzubauen, startet coss.com aus einer Position der Stärke.
-
Wir müssen coss.com nicht überstürzt angehen.
- Die Stabilität von Cal.com bedeutet, dass wir es uns leisten können, coss.com von Anfang an auf die richtige Weise zu bauen. Wir haben den Luxus, diese Engineering-Standards umzusetzen, ohne den Druck unmittelbarer Markterwartungen oder Finanzierungseinschränkungen. Das ist eine grundlegend andere Ausgangsposition.
-
Die „Langsamkeit“ ist eine Investition, keine Kostenstelle.
- Ja, diese Standards zu befolgen, kann sich anfangs langsamer anfühlen und manche Engineers vielleicht sogar frustrieren. DTOs zu schreiben kostet mehr Zeit, als Datenbanktypen direkt an das Frontend weiterzugeben. Saubere Abstraktionen und Dependency Injection erfordern mehr Vorarbeit im Design. Für neuen Code eine Testabdeckung von 80 %+ zu halten, verlangt Disziplin. Aber diese scheinbare Langsamkeit ist nur vorübergehend, und der Nutzen wächst exponentiell.
Denk an den Zinseszinseffekt...
-
Code, der von Anfang an richtig architektonisch aufgebaut ist, braucht später keine massiven Refactorings
-
Hohe Testabdeckung verhindert Bugs, die sonst Wochen mit Debugging und Hotfixes verschlingen würden (siehe 2023 bis Mitte 2024)
-
Saubere Abstraktionen machen das Hinzufügen neuer Features mit der Zeit deutlich schneller
-
Saubere Grenzen und DTOs verhindern die architektonische Erosion, die irgendwann komplette Neuentwicklungen erforderlich macht
Die Cal.com Entwicklung zeigt, was passiert, wenn du auf unmittelbare Geschwindigkeit optimierst. Hohe Anfangsgeschwindigkeit, die mit wachsender technischer Schuld allmählich abnimmt, architektonische Abkürzungen erzeugen Engpässe, und immer mehr Zeit wird damit verbracht, Probleme zu beheben statt Features zu bauen (siehe vorherige Grafik, in der wir 55–60 % der Engineering-Arbeit für Fixes aufgewendet haben).
Die Entwicklung von coss.com wird die Stärke des korrekten Bauens von Anfang an nutzen. Etwas langsamere Anfangsgeschwindigkeit beim Etablieren sauberer Muster, gefolgt von exponentieller Beschleunigung, wenn diese Muster sich auszahlen und schnellere Entwicklung mit höherem Vertrauen ermöglichen.
Kernprinzipien
1. Keine aufgeschobene Qualität
-
Wir werden „Ich mache das in einem Folge-PR“ bei kleinen Refactorings minimieren.
- Folge-PRs für kleine Verbesserungen entstehen selten tatsächlich. Stattdessen sammeln sie sich als technische Schuld an, die uns Monate oder Jahre später belastet. Wenn ein kleines Refactoring jetzt gemacht werden kann, mach es jetzt. Folge-PRs sollten größeren Änderungen vorbehalten sein, die wirklich separate PRs rechtfertigen, oder außergewöhnlichen, dringenden Fällen.
2. Hohe Standards im Code Review
-
Lass PRs nicht mit vielen Kleinigkeiten durch, nur um nicht „die schlechte Person“ zu sein.
- Genau so werden Codebasen mit der Zeit schlampig. Code Review geht nicht darum, nett zu sein. Es geht darum, die Qualitätsstandards aufrechtzuerhalten, die unsere Infrastruktur verlangt. Jede Kleinigkeit zählt. Jeder Verstoß gegen Muster zählt. Sprich sie vor dem Merge an, nicht danach.
3. Fordert euch gegenseitig auf, das Richtige zu tun
-
Wir nehmen uns gegenseitig für Qualität in die Verantwortung
- Abkürzungen mögen sich im Moment schneller anfühlen, aber sie schaffen Probleme, die später alle ausbremsen. Wenn du siehst, dass ein Teammitglied kurz davor ist, einen PR mit offensichtlichen Problemen zu mergen, sprich es an. Wenn jemand statt der richtigen Lösung einen schnellen Hack vorschlägt, widersprich. Wenn du versucht bist, Tests zu überspringen oder architektonische Muster zu ignorieren, erwarte, dass dein Team dich herausfordert.
-
Es geht nicht darum, schwierig zu sein oder Leute auszubremsen
- Es geht um gemeinsame Verantwortung für unsere Codebase und unseren Ruf. Jede Abkürzung, die eine Person nimmt, wird zum Problem aller. Jede heute abgeschnittene Ecke bedeutet morgen mehr Debugging-Sitzungen, mehr Hotfixes und mehr frustrierte Kunden.
-
Macht es normal, schlechte Entscheidungen respektvoll zu hinterfragen
- Wenn jemand sagt: „Lass uns das erstmal hart codieren“, sollte die erwartete Antwort sein: „Was bräuchte es, um es gleich beim ersten Mal auf die richtige Weise zu machen?“ Wenn jemand ungetesteten Code committen will, sollte das Team widersprechen. Wenn jemand vorschlägt, Copy-and-Paste statt einer sauberen Abstraktion zu verwenden, sprich es respektvoll an.
-
Wir bauen etwas, das fast nie ausfallen darf
- Dieses Maß an Zuverlässigkeit entsteht nicht zufällig. Es entsteht, wenn sich jede Engineer für Qualität verantwortlich fühlt, nicht nur für den eigenen Code, sondern für das gesamte System. Wir gewinnen als Team oder wir scheitern als Team.
4. Strebe nach Einfachheit
-
Priorisiere Klarheit vor Cleverness
- Das Ziel ist Code, der leicht zu lesen und schnell zu verstehen ist, nicht elegante Komplexität. Einfache Systeme reduzieren die kognitive Last für jede Engineer.
-
Stell dir die richtigen Fragen
-
Löst ich wirklich das aktuelle Problem?
-
Denke ich zu sehr an mögliche zukünftige Anwendungsfälle?
-
Habe ich mindestens 1 andere Alternative zur Lösung bedacht? Wie schneidet sie im Vergleich ab?
-
-
Einfach bedeutet nicht, dass Features fehlen
- Nur weil unser Ziel darin besteht, einfache Systeme zu schaffen, heißt das nicht, dass sie sich ausgehungert und ohne offensichtliche Funktionalität anfühlen sollten.
5. Automatisiere alles
-
Nutze AI
-
Generiere 80 % des Boilerplate- und nicht-kritischen Codes mit Hilfe von AI, damit wir uns ausschließlich auf komplexe Geschäftslogik und kritische Architekturen konzentrieren können. Teams, die moderne AI-gestützte Workflows einführen, setzen zunehmend auf Tools wie die besten MCP-Server, um Entwicklerproduktivität und Orchestrierung zu verbessern.
-
Baue ein Alerting ohne Rauschen und ein intelligentes Error Handling.
-
Manuelles Testen gehört immer mehr der Vergangenheit an. AI kann für uns schnell und intelligent riesige Testsuiten erstellen.
-
-
Unsere CI ist der Endgegner
-
Alles in diesem Standards-Dokument wird geprüft, bevor Code in PRs gemerged wird
-
Keine Überraschungen schaffen es in main
-
Checks sind schnell und nützlich
-
Architektonische Standards
Wir stellen auf ein striktes Architekturmodell um, das auf Vertical Slice Architecture und Domain-Driven Design (DDD) basiert. Die folgenden Muster und Prinzipien werden in PR-Reviews und über Linting konsequent durchgesetzt.
Vertical Slice Architecture: packages/features
Unsere Codebase ist nach Domänen organisiert, nicht nach technischen Schichten. Das Verzeichnis packages/features ist das Herz dieses Architekturansatzes. Jeder Ordner darin steht für einen vollständigen vertikalen Schnitt der Anwendung, angetrieben von der Domäne, die er berührt.
Struktur:
packages/features/
  availability/
  bookings/
  ooo/
  payments/
  routing/
  scheduling/
  ...
Jeder Feature-Ordner ist ein in sich geschlossener vertikaler Schnitt und enthält alles, was für diese Domäne benötigt wird:
-
Domänenlogik: Die zentralen Geschäftsregeln und Entitäten, die spezifisch für dieses Feature sind
-
Application Services: Orchestrierung der Anwendungsfälle für diese Domäne
-
Repositories: Datenzugriff, der speziell auf die Anforderungen dieses Features zugeschnitten ist
-
DTOs: Data Transfer Objects für das Überschreiten von Grenzen
-
UI-Komponenten: Frontend-Komponenten, die mit diesem Feature verbunden sind (wo zutreffend)
-
Tests: Unit-, Integrations- und e2e-Tests für dieses Feature
Warum vertikale Schnitte wichtig sind
Traditionelle, geschichtete Architektur ordnet nach technischen Belangen:
// Bad: Organized by layer
src/
  controllers/
    AvailabilityController.ts
    BookingController.ts
    OOOController.ts
  services/
    AvailabilityService.ts
    BookingService.ts
    OOOService.ts
  repositories/
    AvailabilityRepository.ts
    BookingRepository.ts
    OOORepository.ts
Das führt zu mehreren Problemen:
-
Änderungen an einem Feature erfordern, dass du Dateien an mehreren Stellen in der Codebase bearbeitest
-
Es ist schwer zu verstehen, was eine Funktion macht, weil ihr Code fragmentiert ist
-
Teams treten sich gegenseitig auf die Füße, wenn sie an verschiedenen Funktionen arbeiten
-
Du kannst eine Funktion nicht einfach extrahieren oder als veraltet kennzeichnen
Vertical slice architecture organisiert nach Domäne:
// Good: Organized by domain
packages/features/
  availability/
    services/
      AvailabilityApplicationService.ts
      AvailabilityDomainService.ts
    repositories/
      AvailabilityRepository.ts
    dto/
      AvailabilityDto.ts
bookings/
  services/
    BookingApplicationService.ts
    BookingDomainService.ts
  repositories/
    BookingRepository.ts
  dto/
    BookingDto.ts
Das löst diese Probleme:
-
Alles rund um Verfügbarkeit liegt in
packages/features/availability -
Du kannst die gesamte Verfügbarkeitsfunktion verstehen, indem du ein Verzeichnis durchsuchst
-
Teams können ohne Konflikte an verschiedenen Funktionen arbeiten (wenn das Cal.com-Engineering-Team wächst, werden wir sehr wahrscheinlich in coss.com Teams haben, die größere Pakete übernehmen)
-
Funktionen sind locker gekoppelt und können sich unabhängig weiterentwickeln
Leitlinien für die Funktionsorganisation
In der Theorie ist jede Funktion unabhängig auslieferbar. Auch wenn wir sie vielleicht nicht tatsächlich getrennt ausliefern, zwingt uns diese Organisation dazu, Abhängigkeiten klar zu halten und die Kopplung minimal zu halten. Das ist die Grundlage und der Erfolg von Microservices, auch wenn wir noch keine Microservices ausliefern werden.
Funktionen kommunizieren über klar definierte Schnittstellen. Wenn bookings Verfügbarkeitsdaten braucht, importiert es aus @calcom/features/availability über exportierte Schnittstellen und greift nicht auf interne Implementierungsdetails zu.
Gemeinsamer Code lebt an den passenden Stellen:
-
Domänenunabhängige Utilities und querschnittliche Belange (Auth, Logging) :
packages/lib -
Gemeinsame UI-Primitives:
packages/ui(und bald coss.com ui)
Domänengrenzen werden automatisch durchgesetzt. Wir werden Linting aufbauen, das verhindert, dass du auf Interna von Funktionen zugreifst, zu denen du keinen Zugriff haben solltest. Wenn packages/features/bookings versucht, aus packages/features/availability/services/internal zu importieren, blockiert der Linter das. Alle Abhängigkeiten zwischen Funktionen müssen über die öffentliche API der jeweiligen Funktion laufen.
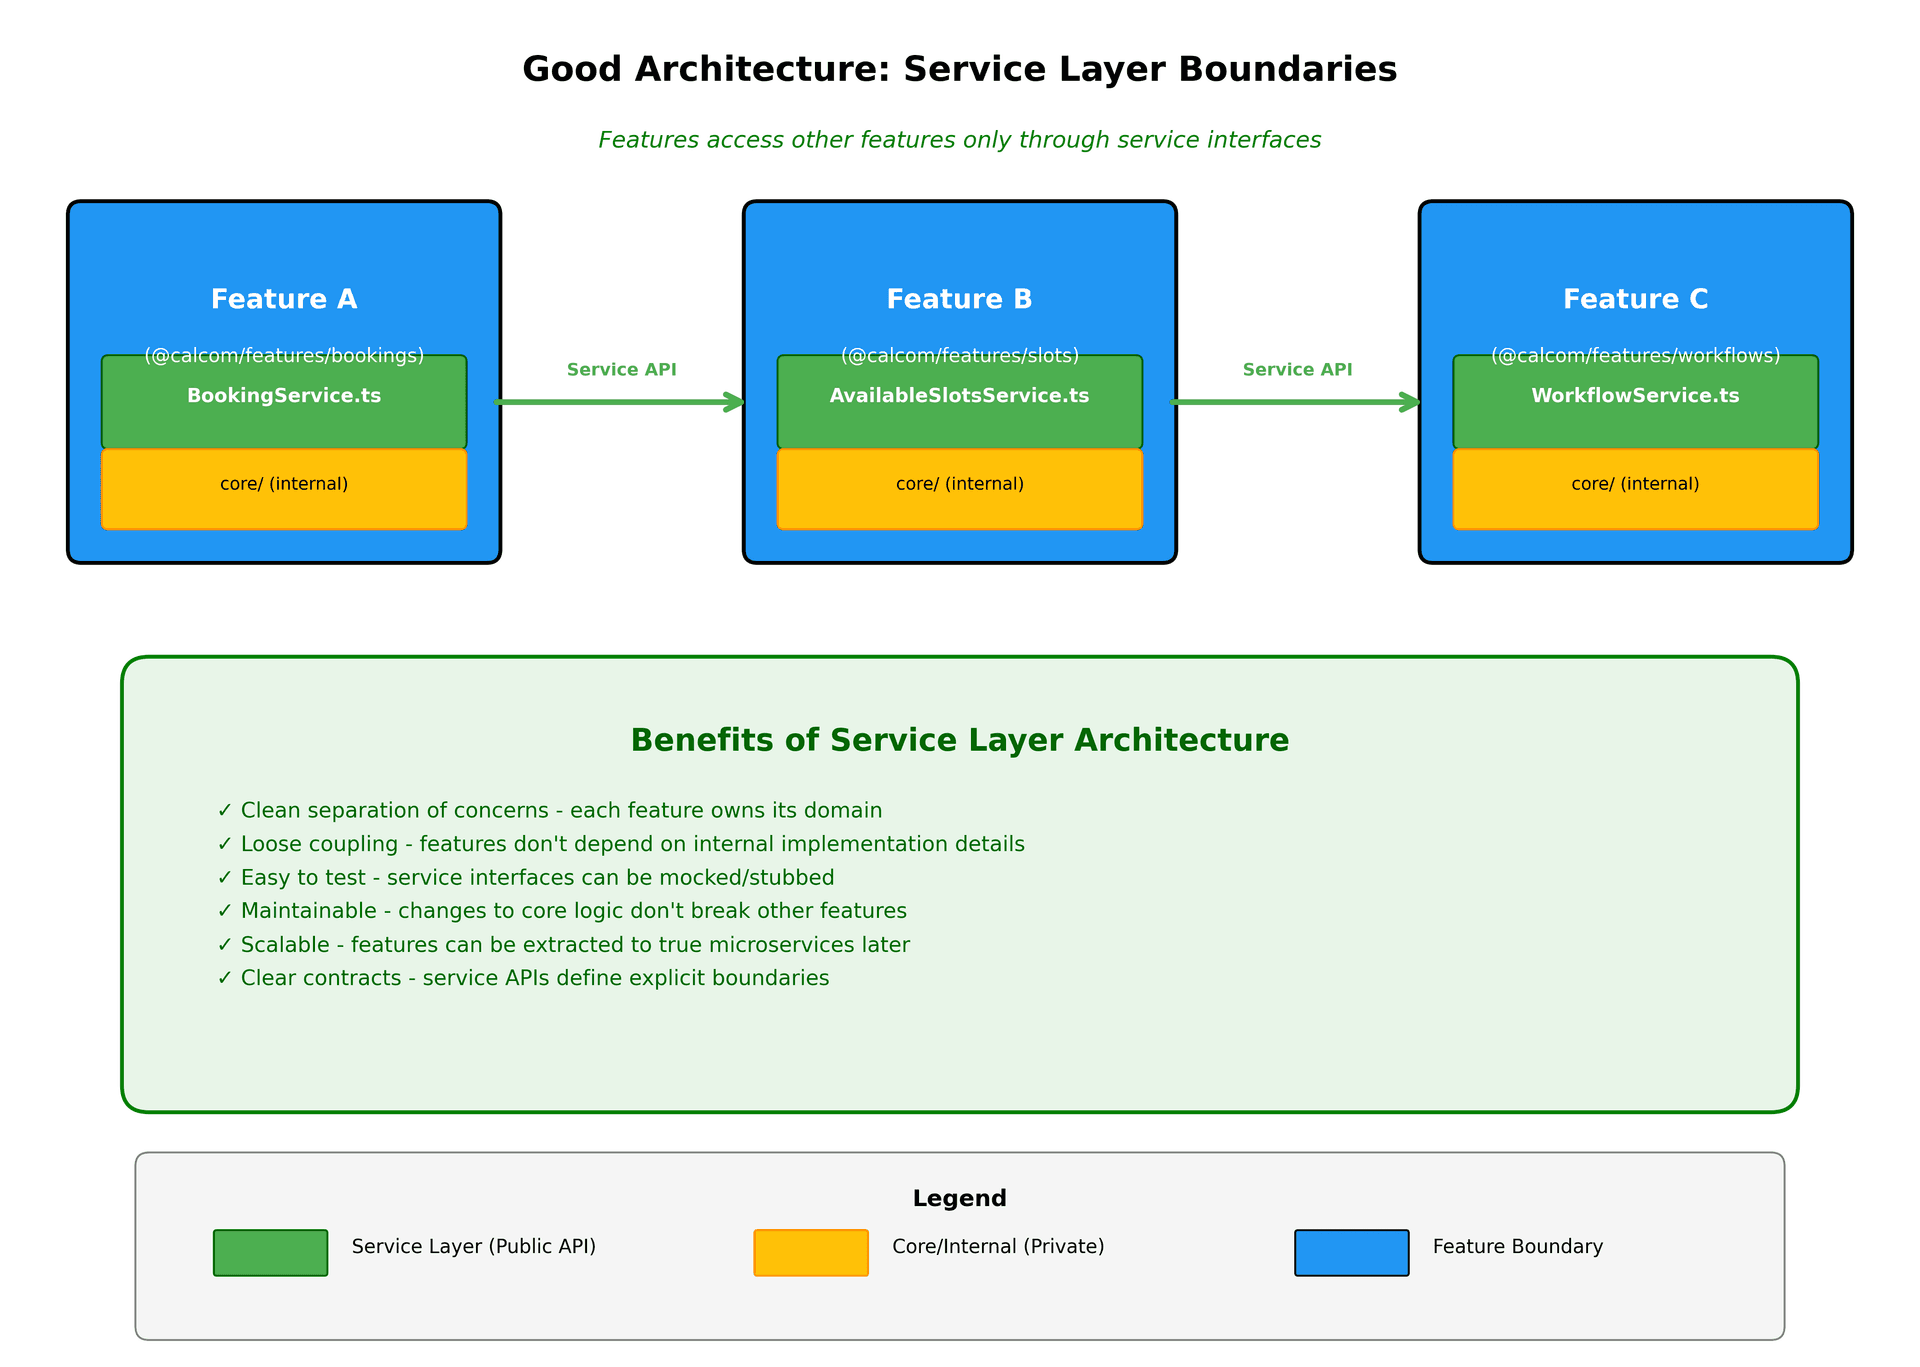
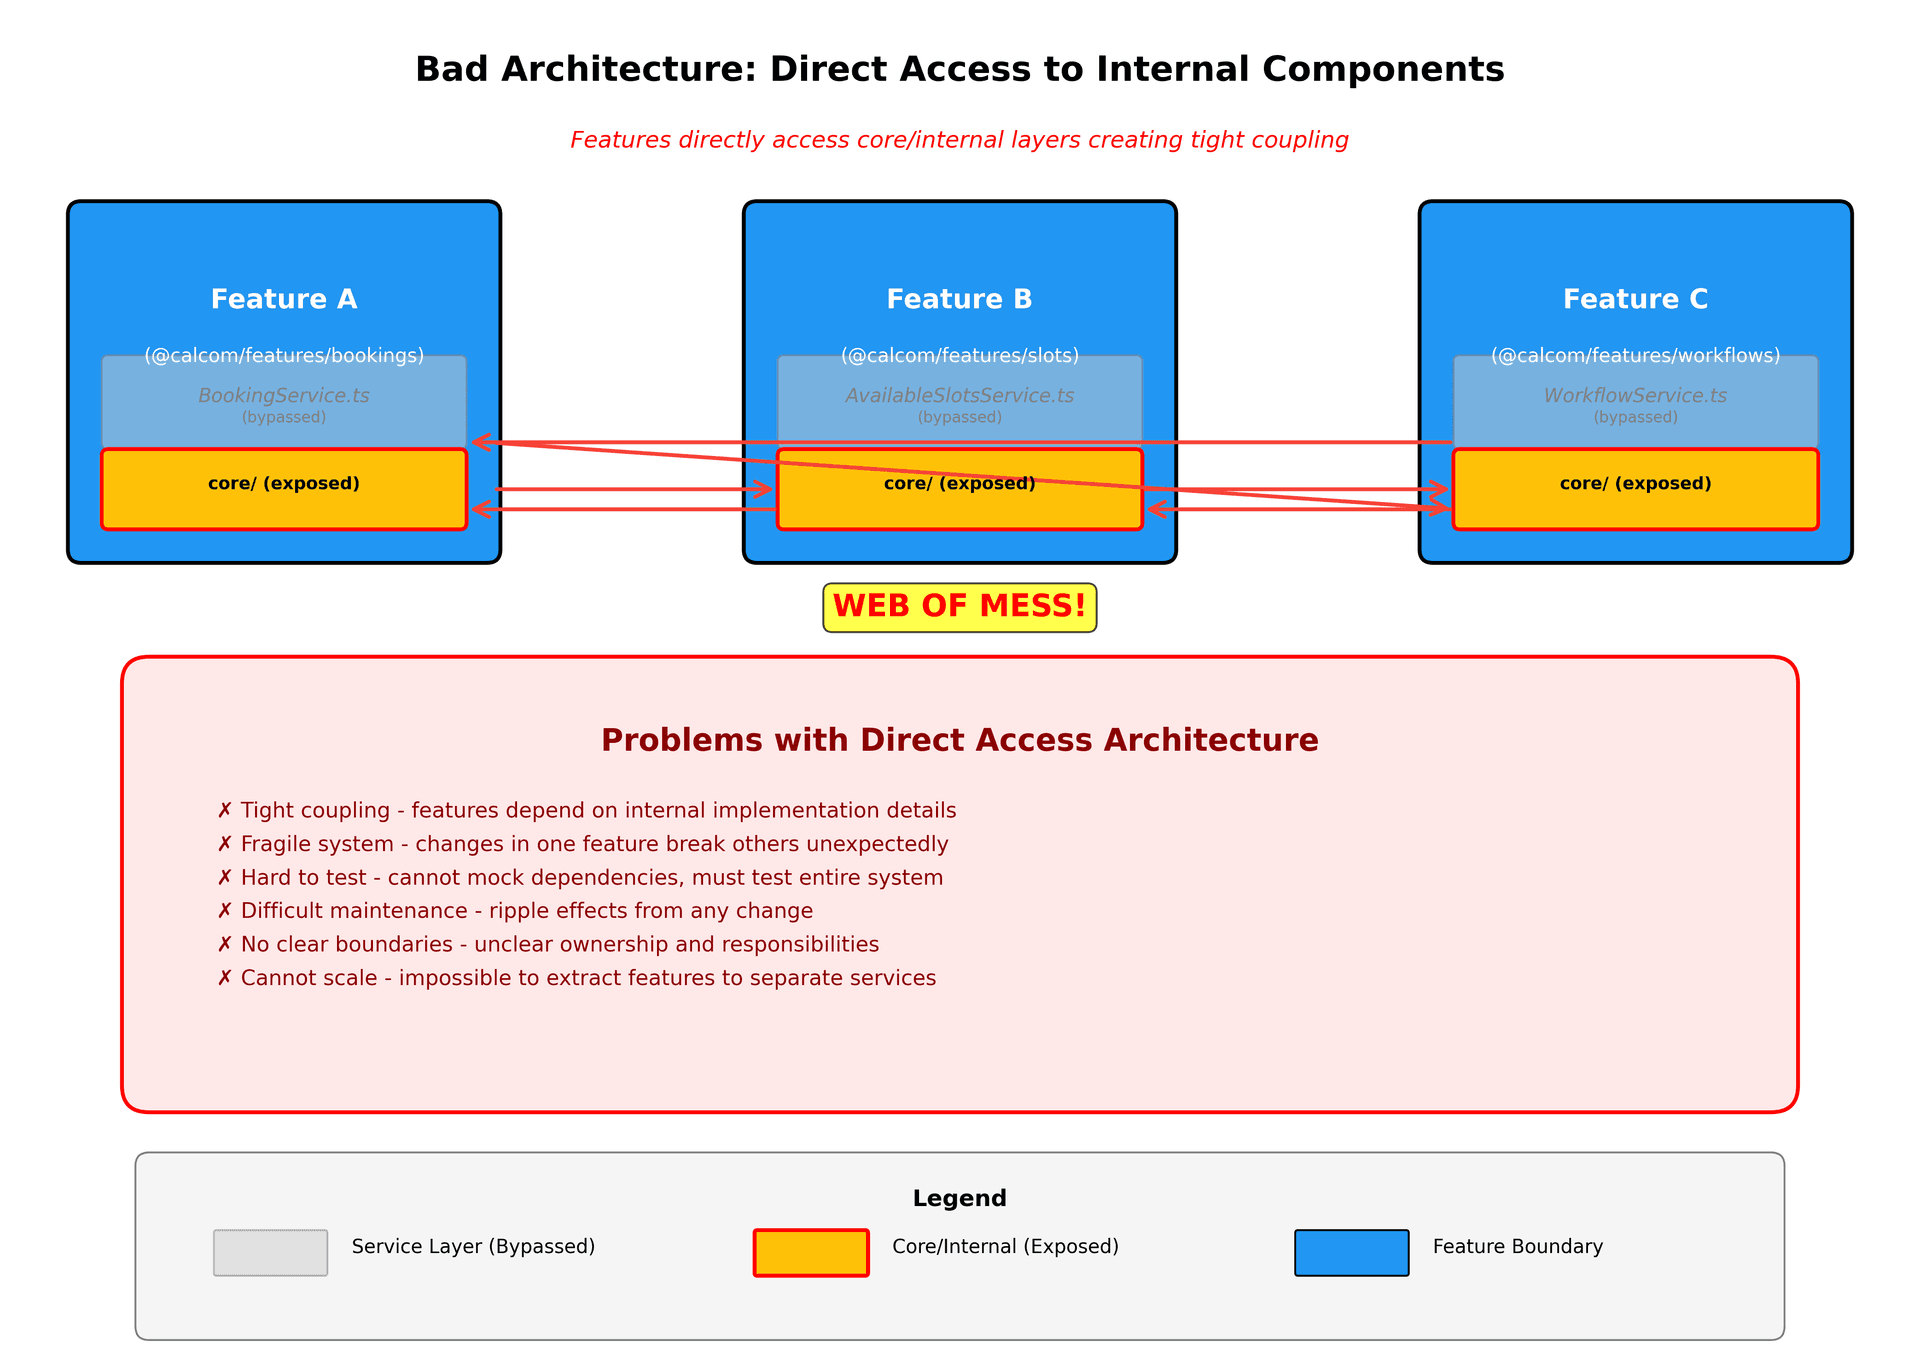
Neue Funktionen starten als vertikale Slices. Wenn du etwas Neues baust, erstelle einen neuen Ordner in packages/features mit dem kompletten vertikalen Slice. So ist klar, was du baust, und alles bleibt von Anfang an organisiert.
Vorteile
-
Auffindbarkeit
- Suchst du nach Buchungslogik? Sie liegt komplett in
packages/features/bookings. Kein Herumstöbern mehr in Controllern, Services, Repositories und Utilities, die über die ganze Codebasis verstreut sind.
- Suchst du nach Buchungslogik? Sie liegt komplett in
-
Einfacheres Testen
- Teste die gesamte Funktion als Einheit. Du hast alle Bausteine an einem Ort, was Integrationstests natürlich und unkompliziert macht.
-
Klarere Abhängigkeiten
- Wenn du
import { getAvailability } from '@calcom/features/availability'siehst, weißt du genau, von welcher Funktion du abhängst. Wenn Abhängigkeiten zu komplex werden, ist das offensichtlich und kann angegangen werden.
- Wenn du
Repository-Pattern und Dependency Injection
Technologieentscheidungen dürfen nicht durch die Anwendung durchsickern. Das Prisma-Problem zeigt das perfekt. Wir haben derzeit Verweise auf Prisma, die sich über Hunderte von Dateien verteilen. Das erzeugt massive Kopplung und macht Technologiewechsel untragbar teuer. Wir spüren das gerade beim Upgrade von Prisma auf v6.16. Etwas, das nur eine lokalisierte Refaktorierung hinter geschützten Repositories hätte sein sollen, ist zu einer langwierigen, fast endlosen Jagd nach Problemen über mehrere Apps hinweg geworden.
Der Standard für die Zukunft:
-
Der gesamte Datenbankzugriff muss über Repository-Klassen laufen. Wir haben dafür schon einen guten Vorsprung.
-
Repositories sind der einzige Code, der Prisma (oder irgendein anderes ORM) kennt. Darin sollte keine Logik stecken.
-
Repositories werden über Dependency-Injection-Container injiziert
-
Wenn wir jemals von Prisma zu Drizzle oder einem anderen ORM wechseln, sind die einzigen erforderlichen Änderungen:
-
Implementierungen der Repositories
-
Verdrahtung des DI-Containers für neue Repositories
-
Sonst nichts in der Codebasis sollte sich darum kümmern oder sich ändern
-
Das ist nicht theoretisch. So bauen wir wartbare Systeme.
Data Transfer Objects (DTOs)
Datenbanktypen dürfen nicht ins Frontend durchsickern. Das ist in unserem Tech-Stack zu einem beliebten Shortcut geworden, aber es ist ein Code-Smell, der mehrere Probleme erzeugt.
-
Technologische Kopplung (Prisma-Typen landen in React-Komponenten)
-
Sicherheitsrisiken (versehentliche Offenlegung sensibler Felder)
-
Fragile Verträge zwischen Server und Client (das ist besonders problematisch, während wir viel mehr APIs bauen)
-
Keine Möglichkeit, das Datenbankschema unabhängig weiterzuentwickeln
-
Alle DTOs werden über Zod konvertiert, sogar für eine API-Antwort, um sicherzustellen, dass alle Daten validiert werden, bevor sie an den Nutzer gesendet werden. Lieber fehlschlagen als etwas Falsches zurückgeben.
Der Standard für die Zukunft:
Erstelle an jeder architektonischen Grenze explizite DTOs.
-
Datenebene → Anwendungsebene → API: Wandle Datenbankmodelle in DTOs der Anwendungsebene um und dann die Anwendungs-DTOs in API-spezifische DTOs
-
API → Anwendungsebene → Datenebene: Wandle API-DTOs über die Anwendungsebene in datenspezifische DTOs um
Ja, das erfordert mehr Code. Ja, es lohnt sich. Explizite Grenzen verhindern die architektonische Erosion, die langfristig zu Wartungs-Albträumen führt.
Domain-Driven-Design-Patterns
Die folgenden Patterns müssen korrekt und konsistent verwendet werden:
-
Application Services
- Orchestrieren Use Cases, koordinieren zwischen Domain Services und Repositories
-
Domain Services
- Enthalten Business-Logik, die nicht natürlich zu einer einzelnen Entität gehört
-
Repositories
- Kapseln den Datenzugriff, isolieren Technologieentscheidungen
-
Dependency Injection
- Ermöglicht lose Kopplung, erleichtert Tests, isoliert Verantwortlichkeiten
-
Caching Proxies
-
Umhüllen Repositories oder Services, um Caching-Verhalten transparent hinzuzufügen
-
Natürlich nicht der einzige Weg, Caching umzusetzen, aber ein guter Ausgangspunkt
-
-
Decorators
- Fügen querschnittliche Belange hinzu (Logging, Metriken usw.), ohne die Domain-Logik zu verunreinigen
Konsistenz der Codebasis
Unsere Codebasen sollten sich anfühlen, als hätte sie eine Person geschrieben. Dieses Maß an Konsistenz erfordert eine strikte Einhaltung etablierter Muster, umfassende Linting-Regeln, die architektonische Standards durchsetzen, Code Reviews, die Musterverstöße ablehnen, plus die Hilfe von KI-Code-Reviewern.
Bedingungen an den Einstiegspunkt der Anwendung verschieben
If-Anweisungen gehören an den Einstiegspunkt, nicht quer durch deine Services verstreut. Das ist eines der wichtigsten architektonischen Prinzipien, um sauberen, fokussierten Code zu erhalten, der nicht in unwartbare Komplexität abgleitet.
So verschlechtert sich Code mit der Zeit: Ein Service wird für einen klaren, konkreten Zweck geschrieben. Die Logik ist sauber und fokussiert. Dann kommt eine neue Produktanforderung, und jemand fügt eine if-Anweisung hinzu. Ein paar Jahre und noch mehrere Anforderungen später ist dieser Service mit bedingten Prüfungen für verschiedene Szenarien übersät. Der Service ist zu folgendem geworden:
-
Kompliziert und schwer zu lesen
-
Schwer zu verstehen und nachzuvollziehen
-
Anfälliger für Bugs
-
Verstößt gegen Single Responsibility (behandelt zu viele verschiedene Fälle)
-
Fast unmöglich gründlich zu testen
Der Service hat seine Grenzen überschritten in Bezug auf Verantwortlichkeiten und Logik.
Eine Lösung: Factory-Pattern mit spezialisierten Services
Nutze das Factory-Pattern, um Entscheidungen am Einstiegspunkt zu treffen, und delegiere dann an spezialisierte Services, die ihre spezifische Logik ohne Bedingungen behandeln.
Beispiel aus unserer Codebasis:
Die BillingPortalServiceFactory entscheidet, ob Billing für eine Organisation, ein Team oder einen einzelnen Nutzer ist, und gibt dann den passenden Service zurück:
export class BillingPortalServiceFactory {
  static async createService(teamId: number): Promise<BillingPortalService> {
    const team = await teamRepository.findById({ id: teamId });
    if (!team) {
      throw new Error("Team not found");
    }
    // Decision made HERE at the entry point
    if (team.isOrganization) {
      return new OrganizationBillingPortalService();
    }
    return new TeamBillingPortalService();
  }

  static createUserService(): UserBillingPortalService {
    return new UserBillingPortalService();
  }
}
Jeder Service behandelt dann seine spezifische Logik, ohne prüfen zu müssen: „Bin ich eine Org oder ein Team?“:
// OrganizationBillingPortalService handles ONLY organization logic
class OrganizationBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "organization.manageBilling",  // Organization-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more organization-specific logic
}

// TeamBillingPortalService handles ONLY team logic
class TeamBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "team.manageBilling",  // Team-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more team-specific logic
}
Warum das wichtig ist
-
Services bleiben fokussiert
- Jeder Service hat eine Verantwortung und muss nichts über andere Kontexte wissen. Der
OrganizationBillingPortalServiceenthält keine if-Anweisungen wieif (isTeam)oderif (isUser). Er weiß nur, wie man Organisationen behandelt.
- Jeder Service hat eine Verantwortung und muss nichts über andere Kontexte wissen. Der
-
Änderungen sind isoliert
- Wenn du die Buchungslogik für Organisationen ändern musst, berührst du nur
OrganizationBillingPortalService. Du riskierst nicht, das Abrechnungsverhalten für Teams oder Nutzer zu beschädigen. Du musst dich nicht durch verschachtelte Bedingungen arbeiten, um herauszufinden, welchen Pfad dein Code nimmt.
- Wenn du die Buchungslogik für Organisationen ändern musst, berührst du nur
-
Tests sind einfach
- Teste jeden Service unabhängig mit seinen spezifischen Szenarien. Du musst nicht jede Kombination von Bedingungen über verschiedene Kontexte hinweg testen.
-
Neue Anforderungen verunreinigen bestehenden Code nicht
- z. B. Wenn du Enterprise-Abrechnung mit anderen Regeln hinzufügen musst, erstellst du
EnterpriseBillingPortalService. Die Factory bekommt eine weitere Bedingung, aber bestehende Services bleiben unangetastet und fokussiert.
- z. B. Wenn du Enterprise-Abrechnung mit anderen Regeln hinzufügen musst, erstellst du
So erreichst du das
-
Ziehe Bedingungen nach oben in Controller, Factories oder Routing-Logik. Lass diese Einstiegspunkte entscheiden, welchen Service sie verwenden.
-
Halte Services rein und auf eine einzige Verantwortung fokussiert. Wenn ein Service prüfen muss: „Welcher Typ bin ich?“, brauchst du wahrscheinlich mehrere Services.
-
Bevorzuge Polymorphie statt Bedingungen
- Interfaces definieren den Vertrag. Konkrete Implementierungen liefern die Details.
-
Achte auf die Anhäufung von if-Anweisungen
- Wenn du im Code Review siehst, dass ein Service für verschiedene Szenarien immer mehr Bedingungen bekommt, ist das ein Signal, in spezialisierte Services umzustrukturieren.
API-Design: Schlanke Controller und HTTP-Abstraktion
-
Controller sind schlanke Schichten, die nur HTTP-Belange behandeln.
- Sie nehmen Requests entgegen, verarbeiten sie und mappen Daten auf DTOs, die an die Kernlogik der Anwendung übergeben werden. Ab jetzt sollte in API-Routen oder tRPC-Handlern keine Anwendungs- oder Kernlogik mehr zu sehen sein.
-
Wir müssen die HTTP-Technologie von unserer Anwendung entkoppeln.
- Die Art, wie wir Daten zwischen Client und Server übertragen (ob REST, tRPC usw.), sollte nicht beeinflussen, wie unsere Kernanwendung funktioniert. HTTP ist ein Liefermechanismus, kein architektonischer Treiber.
Verantwortlichkeiten von Controllern (und NUR diese):
-
Eingehende Requests empfangen und validieren
-
Daten aus Request-Parametern, Body und Headern extrahieren
-
Request-Daten in DTOs umwandeln
-
Geeignete Anwendungsservices mit diesen DTOs aufrufen
-
Antworten von Anwendungsservices in Response-DTOs umwandeln
-
HTTP-Antworten mit passenden Statuscodes zurückgeben
Controller sollten NICHT:
-
Geschäftslogik oder Domänenregeln enthalten
-
Direkt auf Datenbanken oder externe Services zugreifen
-
Komplexe Datentransformationen oder Berechnungen durchführen
-
Entscheidungen darüber treffen, was die Anwendung tun soll
-
Implementierungsdetails der Domäne kennen
Beispiel für das Thin-Controller-Muster:
// Good: Thin controller
export async function createBookingHandler(req: Request, res: Response) {
  // Extract and validate request data
  const createBookingRequest = validateCreateBookingRequest(req.body);
  // Transform to DTO
  const createBookingDto = {
    userId: req.user.id,
    eventTypeId: createBookingRequest.eventTypeId,
    startTime: createBookingRequest.startTime,
    // ... other fields
  };
  // Delegate to application service
  const result = await bookingApplicationService.createBooking(createBookingDto);
  // Transform response and return
  const responseDto = mapBookingToResponseDto(result);
  res.status(201).json(responseDto);
}

// Bad: Fat controller with business logic
export async function createBookingHandler(req: Request, res: Response) {
  // This is wrong - business logic in controller
  if (req.body.startTime < new Date()) {
    return res.status(400).json({ error: "Cannot book in the past" });
  }

  // This is wrong - direct database access
  const existingBooking = await prisma.booking.findFirst({
    where: { eventTypeId: req.body.eventTypeId, startTime: req.body.startTime }
  });

  // This is wrong - complex business calculations
  const duration = calculateBookingDuration(req.body.eventTypeId);
  // ... more business logic
}
API-Versionierung und Breaking Changes
Keine Breaking Changes. Das ist entscheidend. Sobald ein API-Endpunkt öffentlich ist, muss er stabil bleiben. Breaking Changes zerstören das Vertrauen der Entwickler und verursachen für unsere Nutzer Integrations-Albträume.
Strategien, um Breaking Changes zu vermeiden:
-
Neue Felder immer als optional hinzufügen
-
API-Versionierung verwenden, wenn du bestehendes Verhalten ändern musst
-
Alte Endpunkte sauber und mit klaren Migrationspfaden deprecaten
-
Abwärtskompatibilität für mindestens zwei Hauptversionen beibehalten
Wenn du Breaking Changes machen musst:
-
Erstelle eine neue API-Version mit der datumsbasierten Versionierung in API v2 (vielleicht schauen wir uns auch die benannte Versionierung an, die Stripe kürzlich eingeführt hat)
-
Beide Versionen während der Übergangsphase parallel ausführen (das machen wir in API v2 bereits)
-
Wenn möglich automatisierte Migrationstools bereitstellen
-
Den Nutzern genug Zeit für die Migration geben (mindestens 6 Monate für öffentliche APIs)
-
Genau dokumentieren, was sich geändert hat und warum
Performance und algorithmische Komplexität
Wir bauen für große Organisationen und Teams. Was mit 10 Nutzern oder 50 Datensätzen gut funktioniert, kann unter der Last von Enterprise-Scale zusammenbrechen. Performance ist nichts, was wir später optimieren. Es ist etwas, das wir von Anfang an richtig bauen.
Denk ab dem ersten Tag an Skalierung
Wenn du Features baust, frage immer: „Wie verhält sich das bei 1.000 Nutzern? 10.000 Datensätzen? 100.000 Operationen?“ Der Unterschied zwischen O(n)- und O(n²)-Algorithmen mag in der Entwicklung kaum spürbar sein, in der Produktion aber katastrophal.
Häufige O(n²)-Muster, die du vermeiden solltest:
-
Verschachtelte Array-Iterationen (
.mapin.map,.forEachin.forEach) -
Array-Methoden wie
.some,.findoder.filterinnerhalb von Schleifen oder Callbacks -
Jedes Element gegen jedes andere Element prüfen, ohne zu optimieren
-
Verkettete Filter oder verschachteltes Mapping über große Listen
Praxisbeispiel: Bei 100 verfügbaren Slots und 50 belegten Zeiträumen führt ein O(n²)-Algorithmus 5.000 Prüfungen aus. Skalierst du das auf 500 Slots und 200 belegte Zeiträume, machst du 100.000 Operationen. Das ist ein 20-facher Anstieg der Rechenlast bei nur einem 5-fachen Anstieg der Datenmenge.
Wähle die richtigen Datenstrukturen und Algorithmen
Die meisten Performanceprobleme löst du, indem du bessere Datenstrukturen und Algorithmen wählst:
-
Sortieren + früh abbrechen: Sortiere deine Daten einmal und brich dann aus Schleifen aus, wenn du weißt, dass die restlichen Einträge nicht passen
-
Binäre Suche: Nutze binäre Suche für Lookups in sortierten Arrays statt linearer Scans
-
Zwei-Zeiger-Techniken: Um sortierte Sequenzen zu mergen oder zu schneiden, gehe mit Zeigern durch beide statt mit verschachtelten Schleifen
-
Hash-Maps/Sets: Nutze Objekte oder Sets für O(1)-Lookups statt
.findoder.includesauf Arrays -
Intervallbäume: Für Terminplanung, Verfügbarkeit und Bereichsabfragen nutze passende Baumstrukturen statt Bruteforce-Vergleichen
Beispieltransformation:
// Bad: O(n²) - checks every slot against every busy time
availableSlots.filter(slot => {
  return !busyTimes.some(busy => checkOverlap(slot, busy));
});

// Good: O(n log n) - sort once, break early
const sortedBusy = [...busyTimes].sort((a, b) => a.start - b.start);
availableSlots.filter(slot => {
  for (const busy of sortedBusy) {
    if (busy.start >= slot.end) break; // No more overlaps possible
    if (busy.end <= slot.start) continue; // This one doesn't overlap
    return false; // Overlap found
  }
  return true;
});
Automatisierte Performance-Checks
Wir werden mehrere Schutzebenen gegen Performance-Regressionen implementieren:
Linting-Regeln, die Folgendes markieren:
-
Funktionen mit verschachtelten Schleifen oder verschachtelten Array-Methoden
-
Mehrere verschachtelte Aufrufe von
.some,.findoder.filter -
Rekursion ohne Memoisierung
-
Bekannte Anti-Patterns für unsere Domäne (Terminplanung, Verfügbarkeitsprüfungen usw.)
Performance-Benchmarks in CI, die:
-
Kritische Algorithmen mit realistischen, großskaligen Daten ausführen
-
Ausführungszeiten bei jedem PR mit der Baseline vergleichen
-
Merges blockieren, die Performance-Regressionen einführen
-
Mit Enterprise-Scale-Daten testen (Tausende von Nutzern, Zehntausende von Datensätzen)
Produktionsmonitoring, das:
-
Die Ausführungszeit für kritische Pfade verfolgt
-
Alarm schlägt, wenn Algorithmen langsamer werden, während die Datenmenge wächst
-
Regressionen erkennt, bevor Nutzer sie bemerken
-
Reale Performance-Daten liefert, um Optimierungen zu steuern
Performance ist ein Feature
Leistung ist nicht optional. Es ist nichts, das wir „später machen“. Für Enterprise-Kunden, die über große Teams hinweg buchen, bedeuten langsame Antworten verlorene Produktivität und frustrierte Nutzer (unsere Erfahrung mit einigen größeren Enterprise-Kunden kann dafür als Beleg dienen).
Jeder Engineer sollte:
-
Profiliere deinen Code, bevor du optimierst, aber denke von Anfang an über Komplexität nach
-
Teste mit realistischen Daten in großem Maßstab (nicht nur 5 Testdatensätze). Wir haben bereits Seed-Skripte gebaut. Die müssen wir wahrscheinlich erweitern.
-
Wähle von vornherein effiziente Algorithmen und Datenstrukturen
-
Achte im Code-Review auf verschachtelte Iterationen
-
Hinterfrage jeden Algorithmus, der mit dem Produkt zweier Variablen skaliert
Die NP-schwere Realität der Terminplanung
Terminplanungsprobleme sind grundsätzlich NP-schwer. Das bedeutet: Je mehr Einschränkungen, Teilnehmer oder Zeitfenster hinzukommen, desto stärker kann die rechnerische Komplexität exponentiell explodieren. Die meisten optimalen Algorithmen für die Terminplanung haben im Worst Case eine exponentielle Laufzeitkomplexität, weshalb die Wahl des Algorithmus absolut entscheidend ist.
Auswirkungen in der Praxis:
-
Die optimale Meetingzeit für 10 Personen über 3 Zeitzonen hinweg mit individuellen Verfügbarkeitsbeschränkungen zu finden, ist rechnerisch teuer
-
Das Hinzufügen von Konflikterkennung, Puffern und einer Vielzahl weiterer Optionen verschärft das Problem
-
Schlechte Algorithmusentscheidungen, die für kleine Teams gut funktionieren, werden für große Organisationen völlig unbrauchbar
-
Was für 5 Nutzer Millisekunden dauert, kann für Organisationen viele Sekunden dauern
Strategien zum Umgang mit NP-schwerer Komplexität:
-
Verwende Approximationsalgorithmen, die schnell „gut genug“ statt langsam perfekte Lösungen finden
-
Implementiere aggressives Caching berechneter Zeitpläne und Verfügbarkeiten
-
Berechne häufige Szenarien vorab während Zeiten mit geringer Auslastung
-
Zerlege große Terminplanungsprobleme in kleinere, besser handhabbare Teilstücke
-
Setze sinnvolle Timeout-Grenzen und weiche bei Bedarf auf einfachere Algorithmen aus
Deshalb ist Leistung in Terminplanungssoftware nicht einfach nur ein Nice-to-have. Sie ist das Fundament, das darüber entscheidet, ob dein System für Enterprise-Anforderungen skalieren kann oder unter realen Nutzungsmustern zusammenbricht.
Anforderungen an die Codeabdeckung
-
Globale Abdeckungsverfolgung
- Wir verfolgen die gesamte Codebasis-Abdeckung als zentrale Kennzahl, die sich mit der Zeit verbessert. Das gibt uns Einblick in unsere Testreife und hilft, Bereiche zu identifizieren, die Aufmerksamkeit brauchen. Der globale Abdeckungsprozentsatz wird in unseren Dashboards prominent angezeigt.
-
80%+ Abdeckung für neuen Code
- Jeder PR muss für den von ihm eingeführten oder geänderten Code eine Testabdeckung von fast 80%+ haben. Das wird in unserer CI-Pipeline automatisch durchgesetzt. Wenn du 50 Zeilen neuen Code hinzufügst, müssen diese 50 Zeilen durch Tests abgedeckt sein. Wenn du eine bestehende Funktion änderst, müssen deine Änderungen getestet werden. Das ist die gesamte Testabdeckung. Die Unit-Test-Abdeckung muss bei fast 100% liegen, vor allem mit der Möglichkeit, KI zu nutzen, um dabei zu helfen, diese zu generieren.
Zur Einordnung des Arguments „Abdeckung ist nicht die ganze Geschichte“: Ja, wir wissen, dass Abdeckung keine perfekten Tests garantiert. Wir wissen, dass du bedeutungslose Tests schreiben kannst, die jede Zeile treffen, aber nichts Sinnvolles testen. Wir wissen, dass Abdeckung nur eine von vielen Kennzahlen ist. Aber es ist sicher besser, auf einen hohen Prozentsatz hinzuarbeiten, als überhaupt keine Ahnung zu haben, wo du stehst.
Erfolg messen
-
„Velocity“ (geklaut aus Scrum, obwohl wir Scrum nicht verwenden werden)
- Weiteres Wachstum der monatlichen Kennzahlen (Features, Verbesserungen, Refactors)
-
Qualität
- Den PR-Aufwand für Fixes von den aktuellen 35% bis Ende 2026 auf 20% oder weniger senken (berechnet auf Basis von Dateiänderungen sowie Hinzufügungen/Löschungen)
-
Architektonische Gesundheit
- Kennzahlen zu Musterkonformität, Technologie-Kopplung, Grenzverletzungen
-
Review-Effizienz
- Kleinere PRs, schnellere Reviews, weniger Feedback-Runden
-
Verfügbarkeit von Anwendung und API
- Wie nah sind wir an 99.99%?