O(n²)-Performance-Engpässe finden und beheben: Lektionen aus den Algorithmus-Optimierungen bei Cal.com
Ein tiefer Einblick darin, wie wir schlecht performende Algorithmen in einer echten Produktions-Codebasis erkannt, analysiert und optimiert haben.
On this page
- Einführung
- Das Problem: Wie aus unscheinbarem Code O(n²) wird
- Fallstudie 1: Optimierung der Prüfung von Slot-Konflikten
- Das ursprüngliche Problem
- Originalimplementierung: O(n²) verschachtelte Schleifen
- Optimierte Implementierung: O(n log n) mit Sortierung und frühem Abbruch
- Fallstudie 2: Schnittmenge von Datumsbereichen mit der Zwei-Zeiger-Technik
- Das ursprüngliche Problem
- Originalimplementierung: O(n²) verschachteltes Mapping
- Optimierte Implementierung: O(n log n) mit Zwei-Zeiger-Durchlauf
- Fallstudie 3: Intervallbaum für das Filtern redundanter Bereiche
- Das ursprüngliche Problem
- Originalimplementierung: O(n²) Enthaltensprüfung
- Optimierte Implementierung: O(n log n) mit einem Intervallbaum
- Performance-Ergebnisse: Vorher und nachher
- Einfache Techniken zum Erkennen von O(n²)-Algorithmen
- Erkenne Problem-Muster
- Teste die Skalierbarkeit explizit
- Automatisiere statische Analyse
- Bewährte Strategien, um O(n²)-Code zu ersetzen
- Performance-Prüfungen automatisieren
- Wichtigste Erkenntnisse
- Fazit
Einführung
Performance-Engpässe in Scheduling-Systemen können den Unterschied zwischen einer reaktionsschnellen User Experience und frustrierten Nutzern ausmachen, die deine Plattform verlassen. Bei Cal.com haben wir kürzlich mehrere kritische O(n²)-Algorithmen aufgedeckt und optimiert, die bei wachsender Nutzerbasis und zunehmenden Datenmengen Verlangsamungen verursacht haben.
In diesem Artikel teile ich vier reale Algorithmus-Optimierungen aus der Codebasis von Cal.com. Du erfährst, wie wir O(n²)-Komplexität erkannt haben, welche Optimierungsstrategien am besten funktioniert haben und wie wir automatisierte Prüfungen eingerichtet haben, um zukünftige Regressionen zu verhindern.
Das Problem: Wie aus unscheinbarem Code O(n²) wird
Wenn Scheduling-Plattformen wachsen, können harmlos wirkende verschachtelte Schleifen überraschend leicht zu stillen Performance-Killern werden. Sieh dir dieses echte Beispiel aus unserer Codebasis an:
// O(n²): Every available slot is checked against every busy period
availableTimeSlots.map(slot => {
  return busy.some(busyTime => checkOverlap(slot, busyTime));
});
Für 100 Slots und 50 belegte Zeiträume sind das 5.000 Überprüfungen auf Überschneidungen. In größerem Maßstab — 500 Slots und 200 belegte Zeiträume — explodiert das auf 100.000 Operationen. Das ist ein zwanzigfacher Anstieg der Rechenlast bei nur fünffach mehr Daten.
Fallstudie 1: Optimierung der Prüfung von Slot-Konflikten
Das ursprüngliche Problem
Die Funktion checkForConflicts nutzte verschachtelte Iteration, um zu prüfen, ob Buchungs-Slots mit belegten Zeiträumen kollidierten. Mit großen Zeitplänen wurde das schnell zu einem Performance-Problem.
Originalimplementierung: O(n²) verschachtelte Schleifen
function checkForConflicts({ busy, time, eventLength }) {
  return busy.some(busyTime => {
    const slotStart = time.valueOf();
    const slotEnd = slotStart + eventLength * 60 * 1000;
    const busyStart = dayjs.utc(busyTime.start).valueOf();
    const busyEnd = dayjs.utc(busyTime.end).valueOf();
    return !(busyEnd <= slotStart || busyStart >= slotEnd);
  });
}

availableTimeSlots = availableTimeSlots
  .map((slot) => {
    if (
      !checkForConflicts({
        time: slot.time,
        busy: busySlotsFromReservedSlots,
        ...availabilityCheckProps,
      })
    ) {
      return slot;
    }
    return undefined;
  })
Optimierte Implementierung: O(n log n) mit Sortierung und frühem Abbruch
function checkForConflicts({ sortedBusyTimes, time, eventLength }) {
  const slotStart = time.valueOf();
  const slotEnd = slotStart + eventLength * 60 * 1000;

  for (const busyTime of sortedBusyTimes) {
    if (busyTime.start >= slotEnd) {
      break;
    }
    if (busyTime.end <= slotStart) {
      continue;
    }
    return true;
  }
  return false;
}
Was sich geändert hat:
Wir haben die belegten Zeiten nach ihren Startzeiten sortiert. Dadurch konnten wir nicht überlappende Zeiträume überspringen und früh abbrechen, wenn keine Konflikte möglich waren. Das Ergebnis war ein drastischer Rückgang unnötiger Vergleiche.
Auswirkung:
Die Komplexität sank von O(available slots × busy periods) auf O(n log n), und in typischen Fällen wurden die meisten Prüfungen komplett übersprungen.
Fallstudie 2: Schnittmenge von Datumsbereichen mit der Zwei-Zeiger-Technik
Das ursprüngliche Problem
Die Funktion intersect nutzte zuvor verschachtelte Schleifen, um Überschneidungen über die Verfügbarkeit mehrerer Nutzer hinweg zu finden.
Originalimplementierung: O(n²) verschachteltes Mapping
commonAvailability.forEach(commonRange => {
  userRanges.forEach(userRange => {
    const intersection = getIntersection(commonRange, userRange);
    if (intersection !== null) {
      intersectedRanges.push(intersection);
    }
  });
});
Optimierte Implementierung: O(n log n) mit Zwei-Zeiger-Durchlauf
const sortedRanges = ranges.map(userRanges =>
  userRanges
    .map(r => ({
      ...r,
      startValue: r.start.valueOf(),
      endValue: r.end.valueOf()
    }))
    .sort((a, b) => a.startValue - b.startValue)
);

let commonIndex = 0;
let userIndex = 0;

while (commonIndex < commonAvailability.length && userIndex < userRanges.length) {
  const commonRange = commonAvailability[commonIndex];
  const userRange = userRanges[userIndex];

  const intersectStartValue = Math.max(commonRange.startValue, userRange.startValue);
  const intersectEndValue = Math.min(commonRange.endValue, userRange.endValue);

  if (intersectStartValue < intersectEndValue) {
    intersectedRanges.push(createIntersection(commonRange, userRange));
  }

  if (commonRange.endValue <= userRange.endValue) {
    commonIndex++;
  } else {
    userIndex++;
  }
}
Was sich geändert hat:
Durch Sortieren und den Einsatz von zwei Zeigern zum Durchlaufen der Bereiche haben wir verschachtelte Iteration überflüssig gemacht. Dadurch sank die Komplexität für die meisten praktischen Eingaben von quadratisch auf nahezu linear.
Fallstudie 3: Intervallbaum für das Filtern redundanter Bereiche
Das ursprüngliche Problem
Die Funktion filterRedundantDateRanges prüfte jeden Bereich gegen jeden anderen, um festzustellen, ob einer den anderen enthält. Bei großen Zeitplänen wurde das quälend langsam.
Originalimplementierung: O(n²) Enthaltensprüfung
return dateRanges.filter((range, index) => {
  return !dateRanges.some((otherRange, otherIndex) => {
    if (index === otherIndex) return false;
    return isCompletelyContained(range, otherRange);
  });
});
Optimierte Implementierung: O(n log n) mit einem Intervallbaum
export function filterRedundantDateRanges(dateRanges) {
  const sortedRanges = [...dateRanges].sort((a, b) => a.start.valueOf() - b.start.valueOf());
  const intervalNodes = createIntervalNodes(
    sortedRanges,
    (range) => range.start.valueOf(),
    (range) => range.end.valueOf()
  );
  const intervalTree = new IntervalTree(intervalNodes);
  const searchAlgorithm = new ContainmentSearchAlgorithm(intervalTree);

  return sortedRanges.filter((range, index) => {
    const containingIntervals = searchAlgorithm.findContainingIntervals(
      range.start.valueOf(),
      range.end.valueOf(),
      index
    );
    return containingIntervals.length === 0;
  });
}
Was sich geändert hat:
Statt mit brachialer Gewalt zu vergleichen, haben wir eine Intervallbaum-Struktur verwendet, um schnelle O(log n)-Abfragen auf Enthaltensein zu ermöglichen. Das ist ein klassischer Ansatz aus der rechnerischen Geometrie, der für Scheduling-Anwendungen Wunder wirkt.
Performance-Ergebnisse: Vorher und nachher
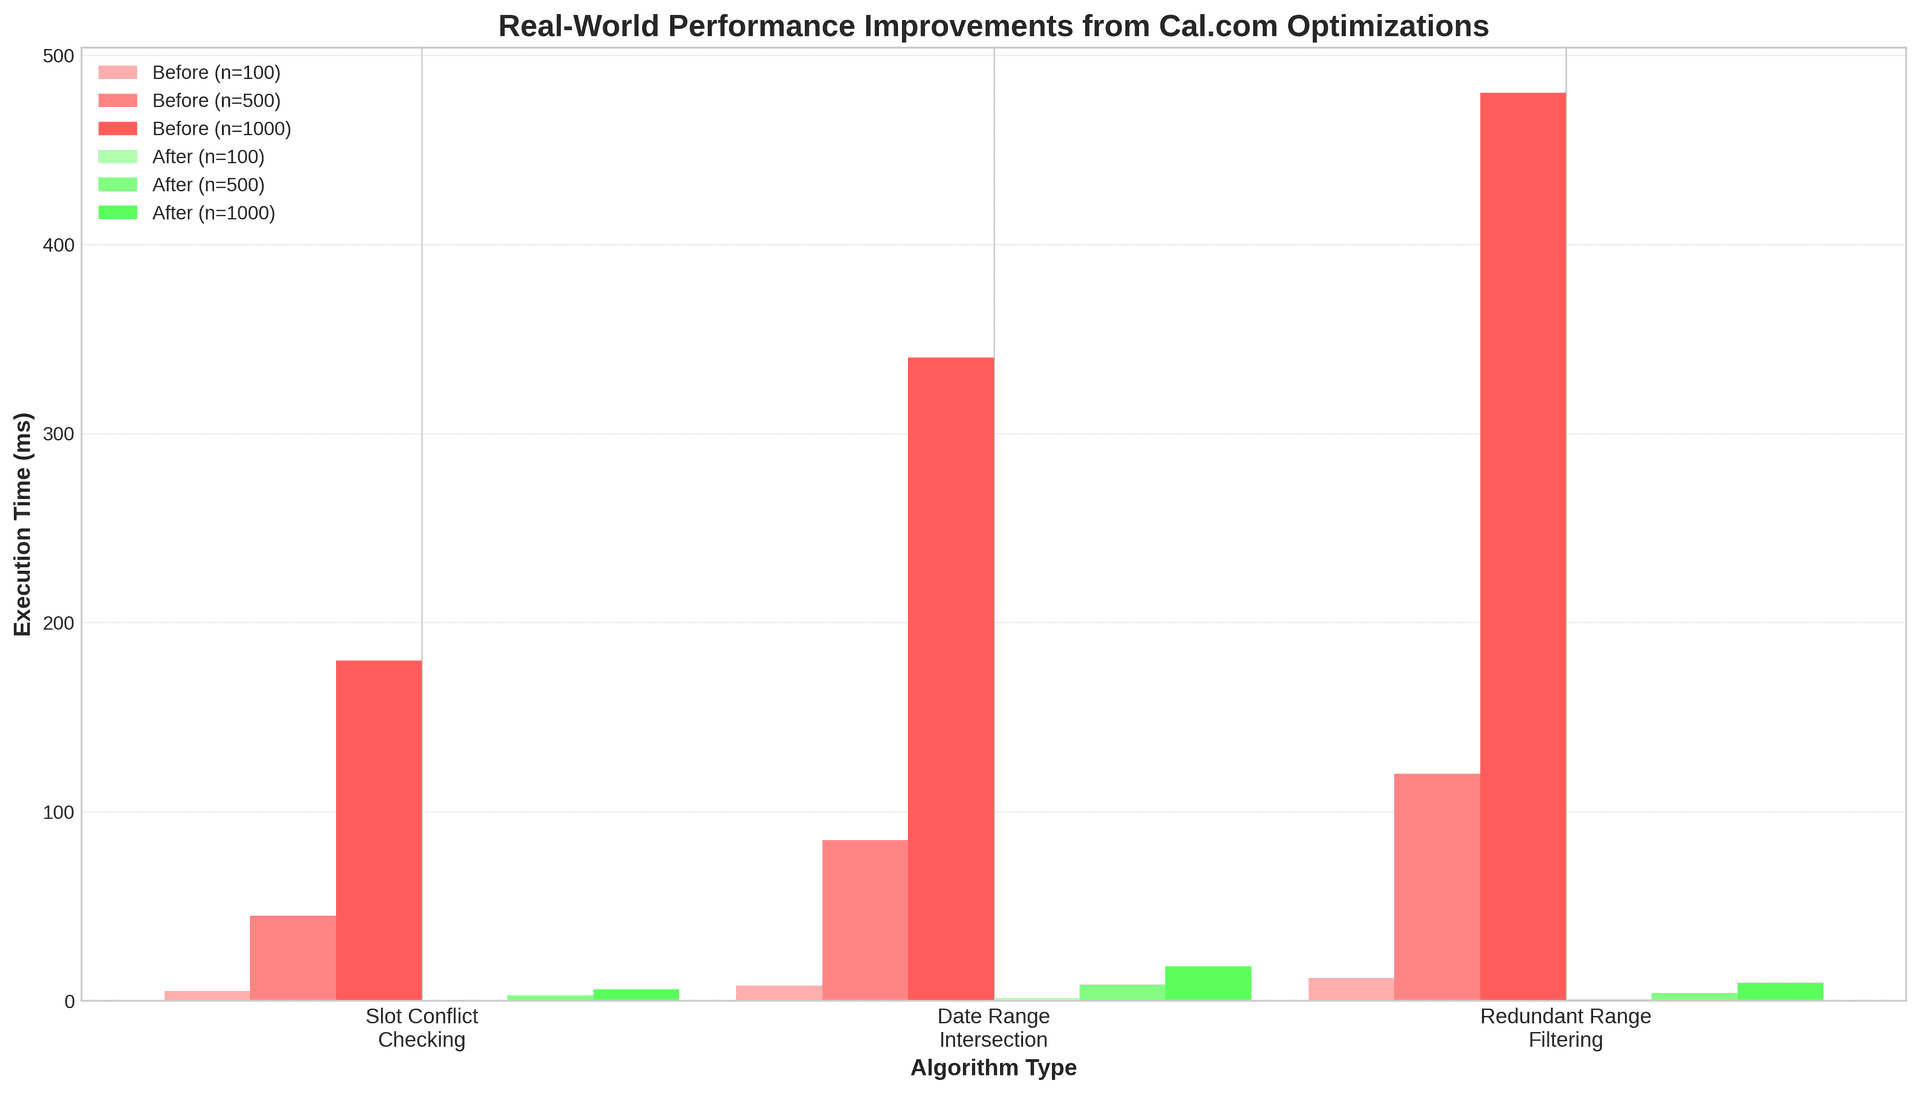
Unsere Benchmarks haben deutliche Verbesserungen gezeigt:
-
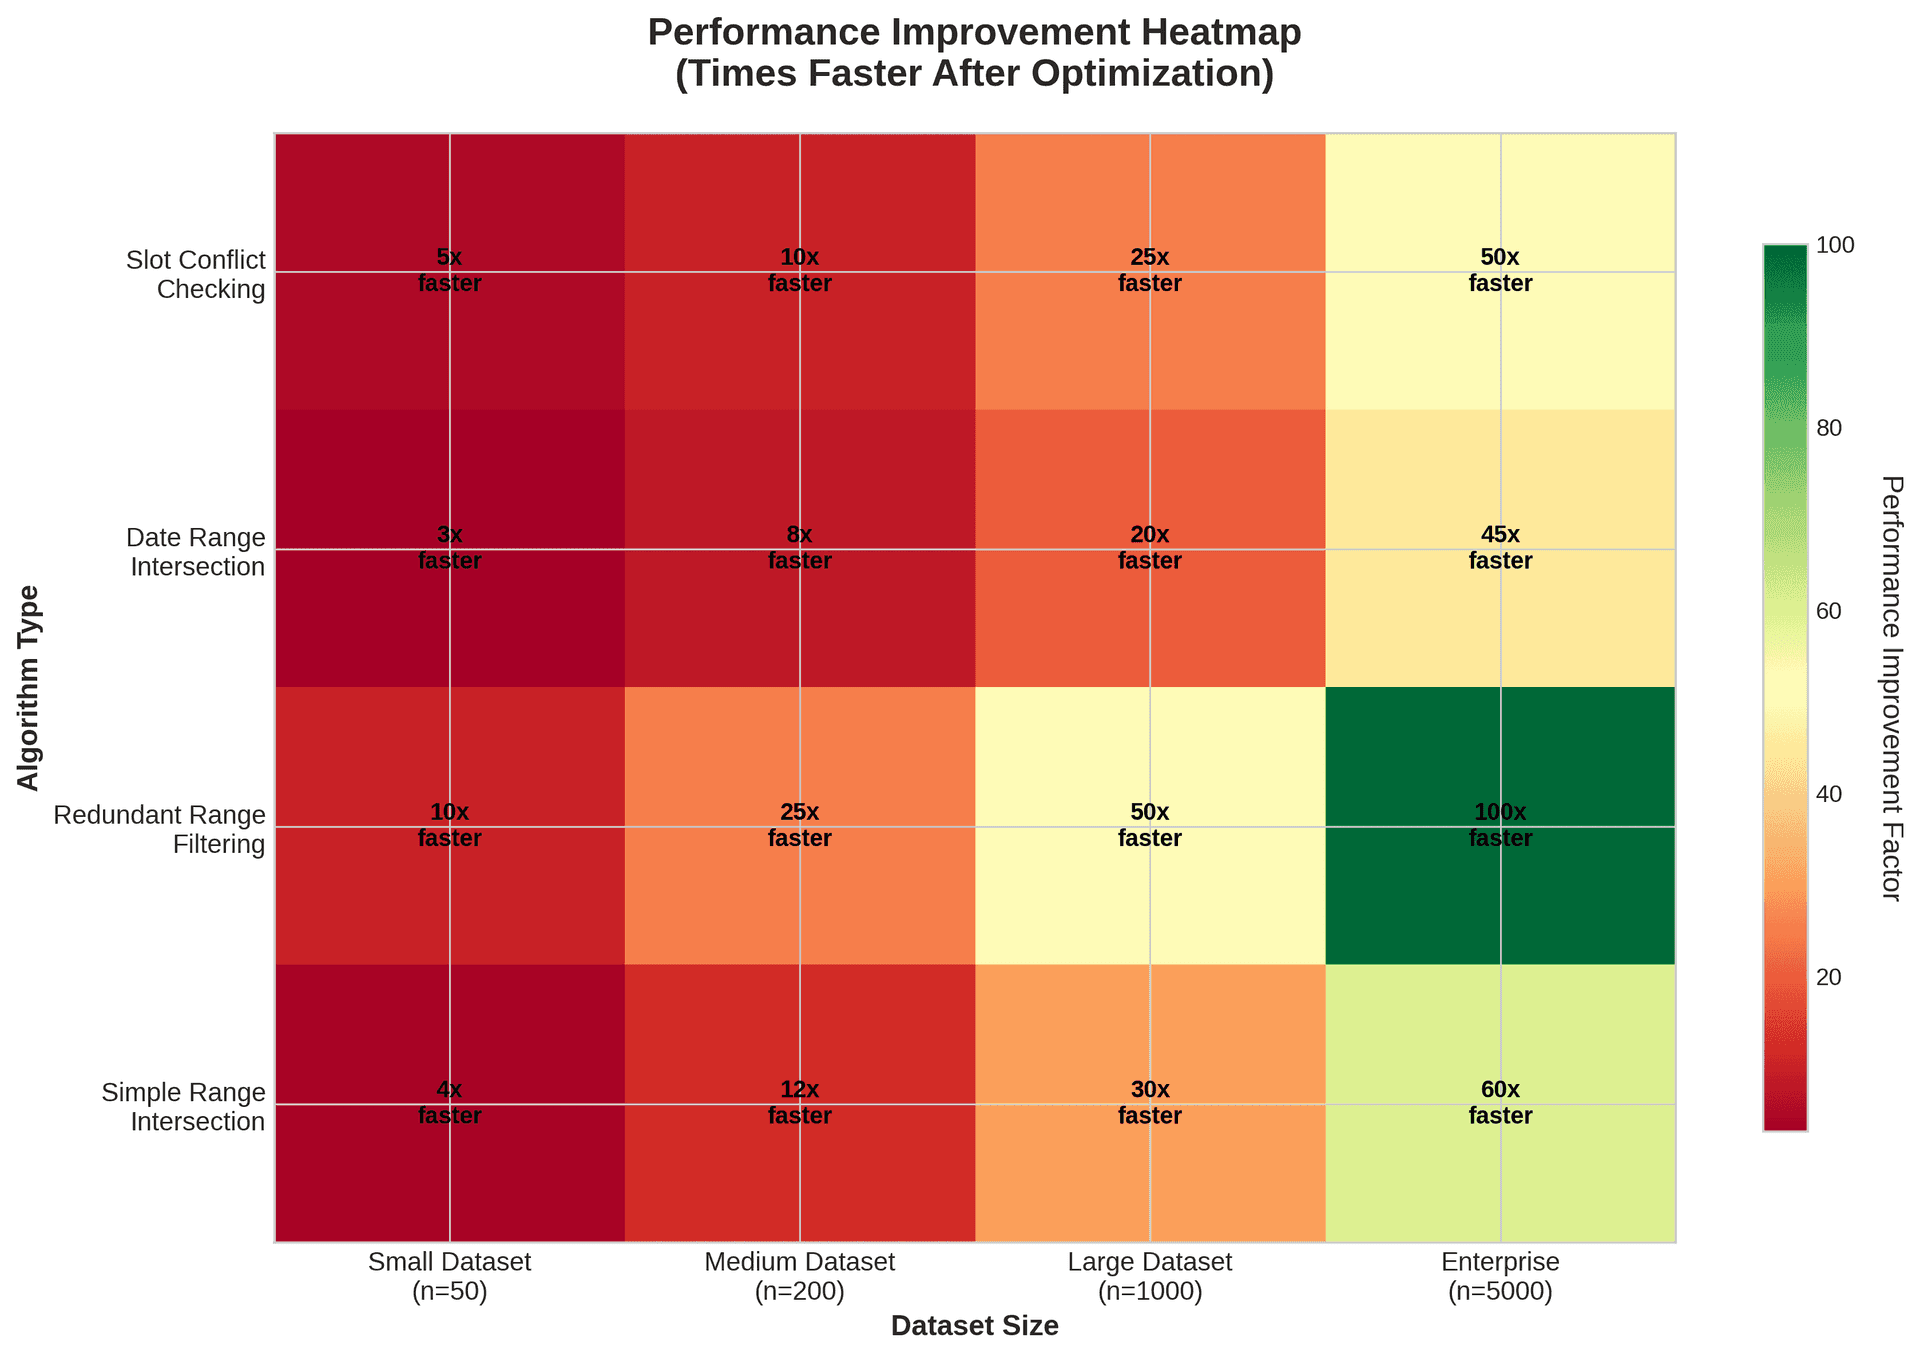
Prüfung von Slot-Konflikten: Von O(n²) auf O(n log n) reduziert, wodurch 100 Slots und 50 belegte Zeiträume etwa zehnmal schneller wurden.
-
Schnittmenge von Datumsbereichen: Von O(n²) auf O(n log n) gesenkt, sodass Hunderte von Datumsbereichen in Millisekunden verarbeitet werden konnten.
-
Filtern redundanter Bereiche: Von O(n²) auf O(n log n) reduziert, mit bis zu 50-facher Beschleunigung für Tausende von Datumsbereichen.
-
Allgemeine Schnittmengen von Bereichen: Über viele Muster hinweg sahen wir Verbesserungen um das 25-Fache oder mehr.
Einfache Techniken zum Erkennen von O(n²)-Algorithmen
Erkenne Problem-Muster
Achte auf:
-
Verschachtelte Array-Iterationen, besonders
.map,.forEach,.filterinnerhalb einer anderen. -
Array-Methoden wie
.some,.findoder.filterinnerhalb von Schleifen oder Array-Callbacks. -
Verkettete Filter oder verschachteltes Mapping über große Listen.
Teste die Skalierbarkeit explizit
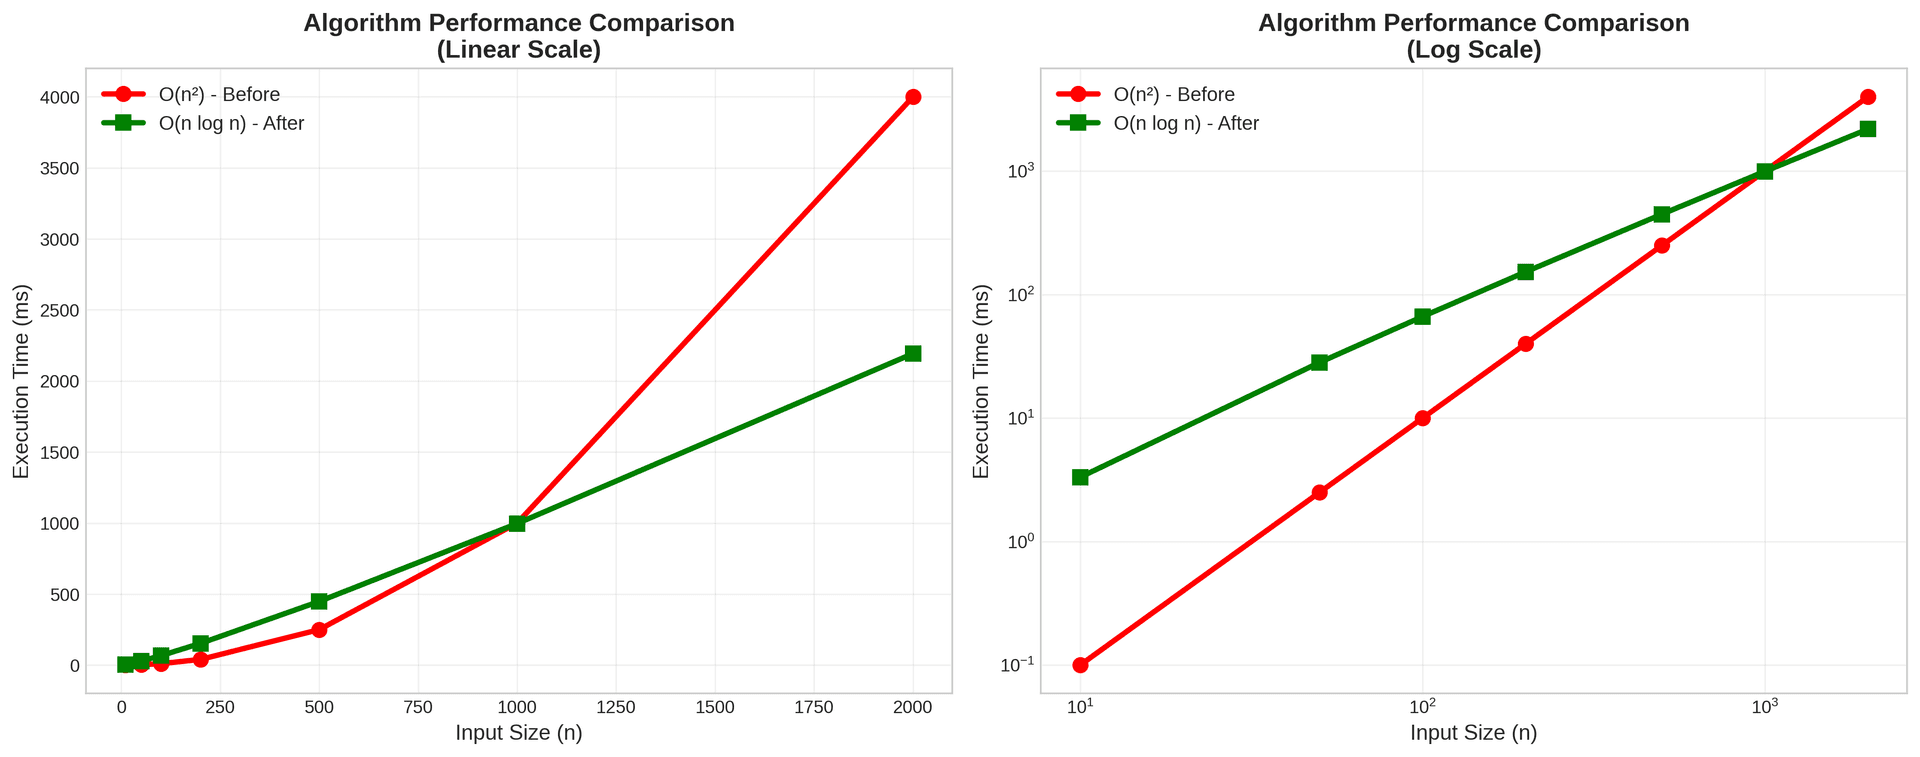
Schreibe Performance-Tests, die deine Funktion mit Daten wachsender Größe ausführen und die Laufzeiten protokollieren. Wenn die Zeit mit der Datenmenge quadratisch wächst, hast du ein O(n²)-Problem.
Automatisiere statische Analyse
Füge Lint-Regeln oder statische Analysen hinzu, die:
-
Funktionen mit verschachtelten Schleifen oder verschachtelten Array-Methoden markieren.
-
Rekursion ohne Memoisierung erkennen.
-
Funktionen mit mehreren verschachtelten
.some-,.find- oder.filter-Aufrufen entdecken.
Bewährte Strategien, um O(n²)-Code zu ersetzen
-
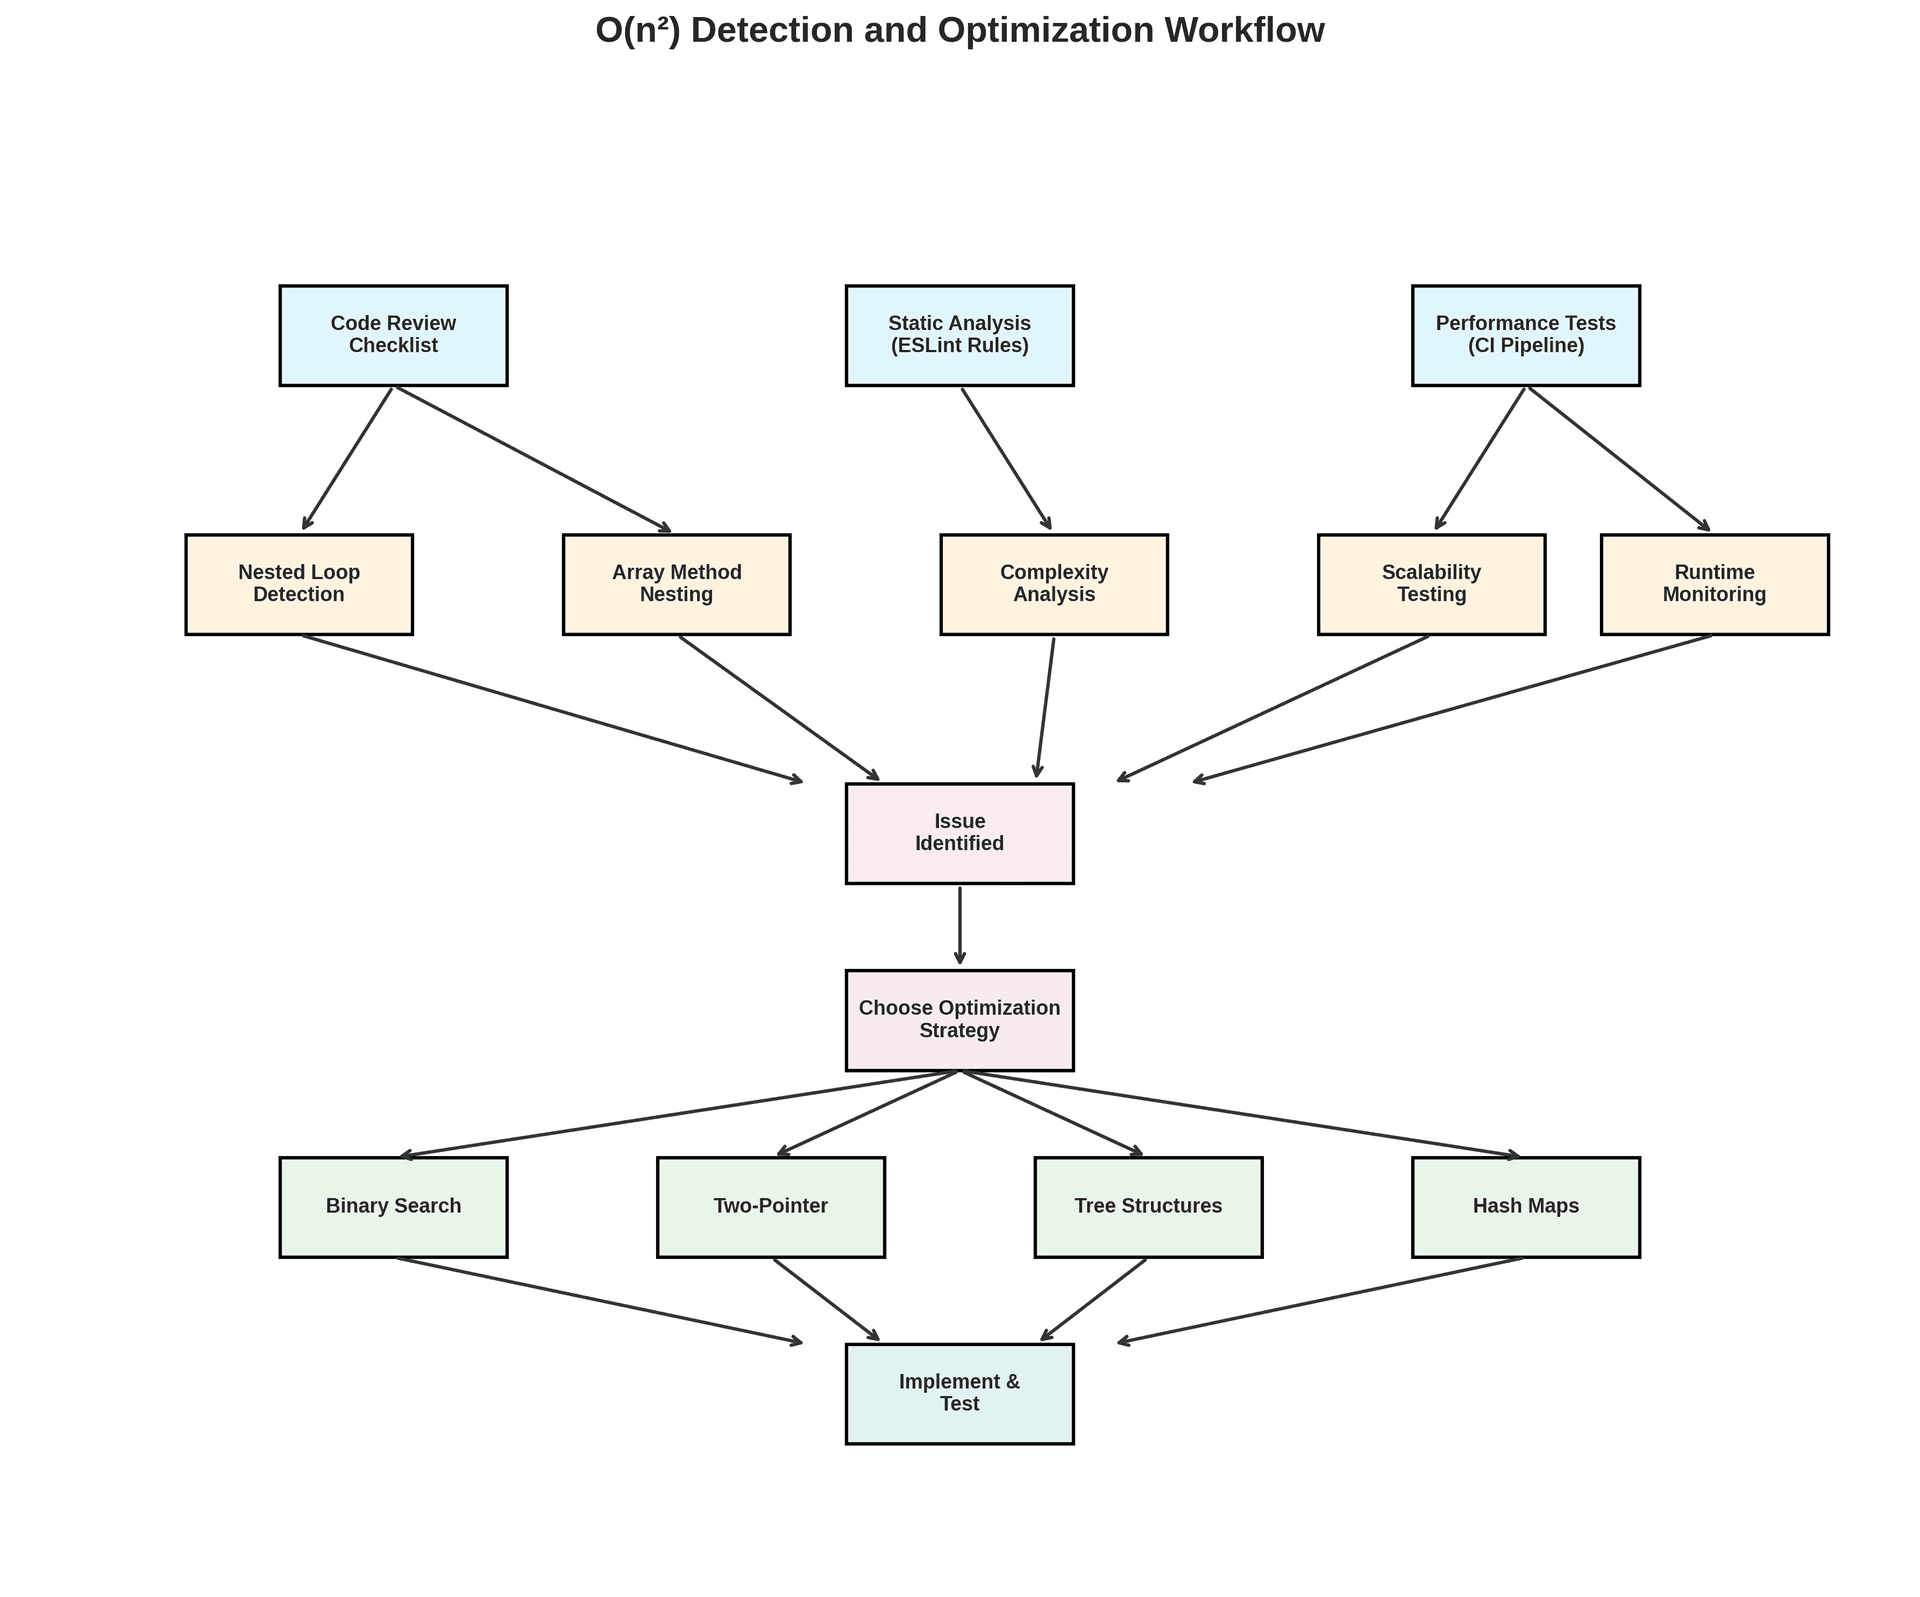
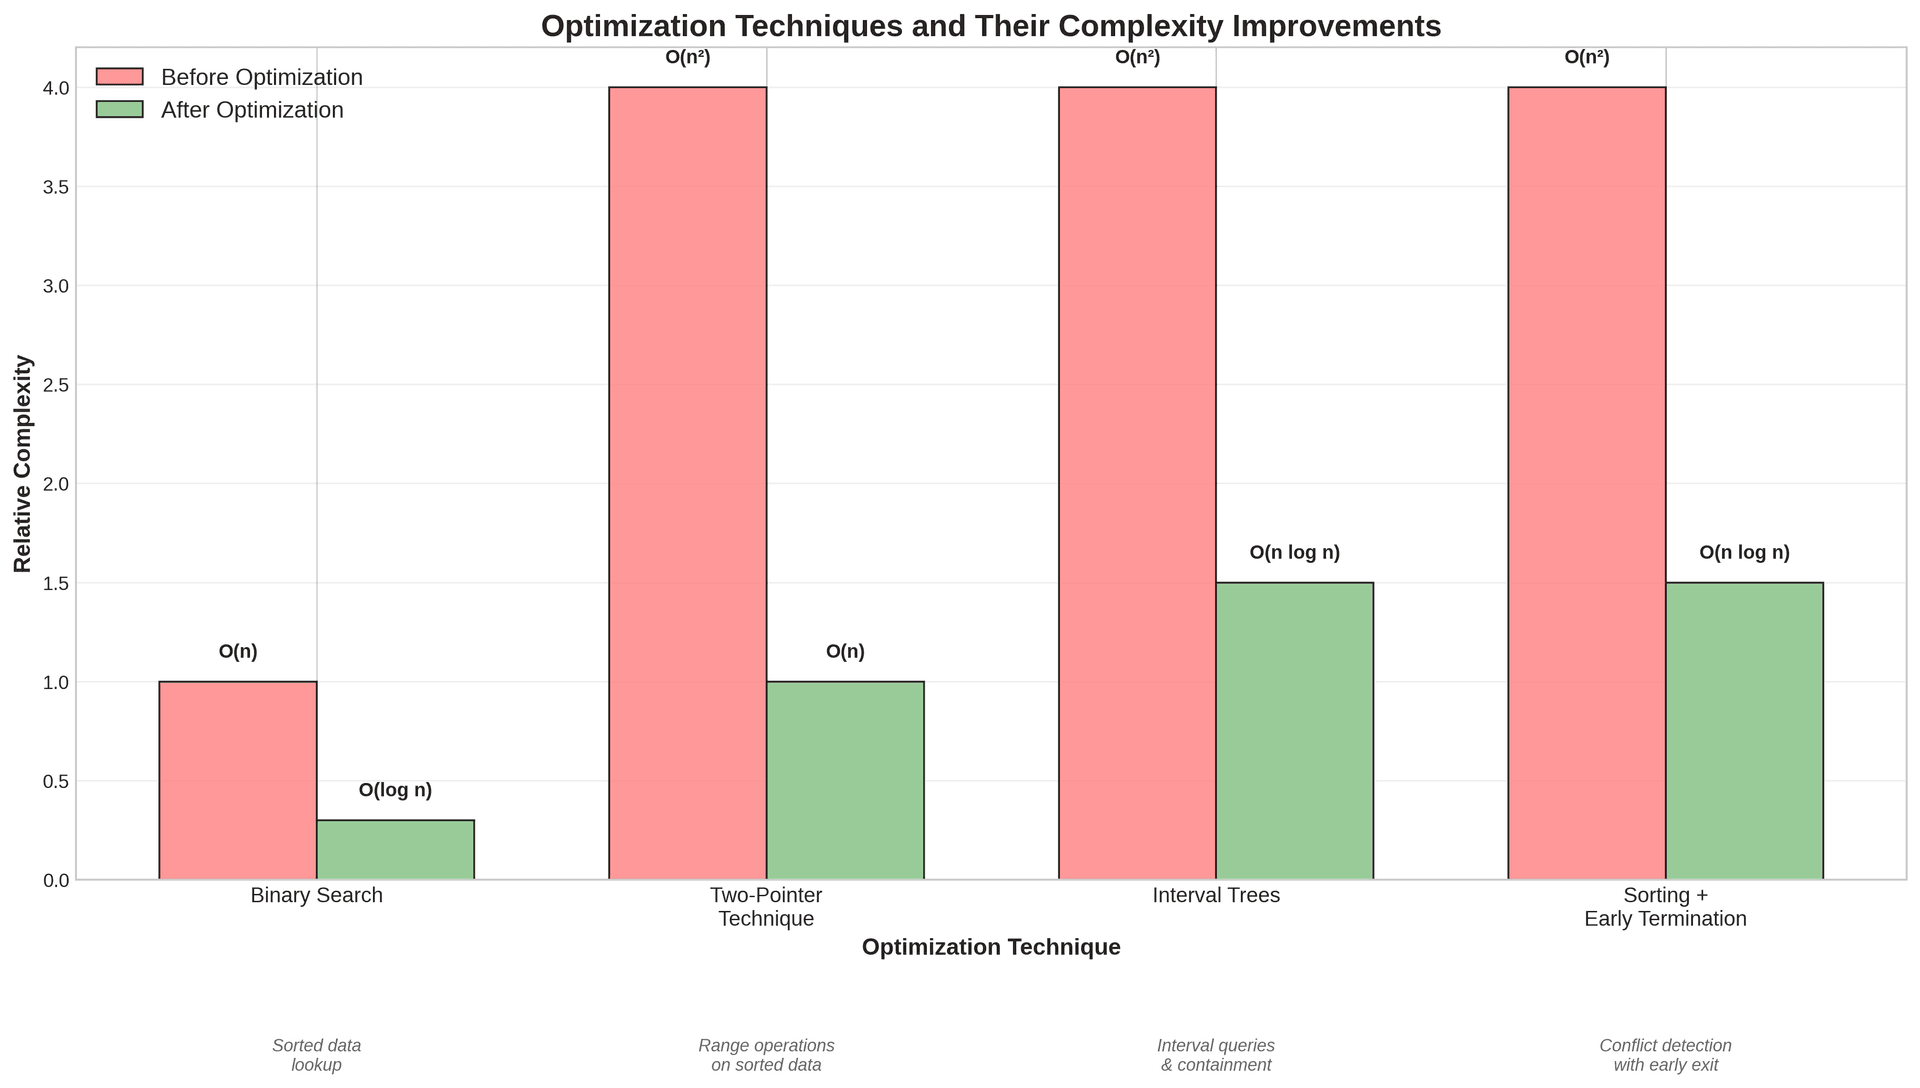
Verwende binäre Suche für Suchvorgänge in sortierten Arrays.
-
Verwende Zwei-Zeiger-Techniken zum Zusammenführen oder Schneiden sortierter Sequenzen.
-
Verwende baumbasierte Datenstrukturen für Intervallabfragen oder hierarchische Daten.
Performance-Prüfungen automatisieren
Füge Performance-Benchmarks zu deiner CI-Pipeline hinzu, die kritische Algorithmen mit realistischen Daten ausführen. Vergleiche die Laufzeiten bei jedem Pull Request und blockiere Merges, die Regressionen verursachen. Füge benutzerdefinierte Lint-Regeln hinzu, um offensichtliche O(n²)-Muster davon abzuhalten, überhaupt in die Produktion zu gelangen. Implementiere Runtime-Monitoring für kritische Pfade, um neue Regressionen zu erkennen, bevor Nutzer sie bemerken.
Wichtigste Erkenntnisse
-
Vorbeugen ist immer besser als heilen. Automatisierte Prüfungen fangen O(n²)-Algorithmen ab, bevor sie Probleme verursachen.
-
Profiliere immer vor der Optimierung. Nutze Tests, um echte Engpässe zu finden.
-
Wähle die richtigen Datenstrukturen für deinen Bedarf. Sortierte Arrays, Zwei-Zeiger-Ansätze und Bäume sind unverzichtbar.
-
Teste mit realistischen Daten im großen Maßstab. Kleine Tests können große Probleme verbergen.
-
Überwache in der Produktion. Automatisierte Alerts können Regressionen früh erkennen.
Fazit
Die Optimierungen, die wir bei Cal.com vorgenommen haben, zeigen, dass sich mit bewährten algorithmischen Techniken deutliche Performance-Gewinne erzielen lassen. Kombiniere Code-Review, intelligente Datenstrukturen und automatisiertes Monitoring, damit deine Anwendung auch beim Wachsen schnell bleibt.
Performance sollte in jeder Entwicklungsphase verankert sein — von Code-Reviews, die verdächtige Muster markieren, über CI-Pipelines, die Skalierbarkeitstests ausführen, bis hin zu Runtime-Monitoring, das Regressionen erkennt.
Ein heute schneller Algorithmus kann mit wachsendenden Daten morgen schnell zum Engpass werden. Bleib wachsam, teste in großem Maßstab und sei immer bereit zu optimieren.