Vorfallbericht: Datenbanklast, Kaskadenausfälle und was wir gelernt haben - 27. Januar 2026
Am Dienstag, den 27. Januar, kam es zu einem Produktionsvorfall, der zu einer beeinträchtigten Leistung auf der gesamten Plattform und zu einem vollständigen Ausfall für einige Unternehmenskunden mit Scheduling Links mit hohem Volumen führte. Der Vorfall begann mit erhöhter Datenbanklast, schien behoben zu sein und offenbarte dann sekundäre Ausfälle in nachgelagerten Systemen. Dieser Beitrag erklärt, was passiert ist, wie wir es bestätigt haben und was wir als Ergebnis geändert haben.

Mit KI zusammenfassen
Auswirkungen
-
Nutzer mit geringem Volumen erlebten hohe Latenz und langsame Seitenladezeiten
-
Unternehmenskunden mit stark frequentierten Scheduling Links erlebten Timeouts und Ausfälle
-
Später im Vorfall sahen Nutzer mit Google Calendar-Integrationen sporadische Ausfälle
Was wir zuerst gesehen haben
Um 15:30 UTC lösten automatische Warnmeldungen wegen erhöhter Datenbanklast aus. Erste Untersuchungen zeigten steigende Average Active Sessions (AAS) und schnell zunehmende Statement-Latenz, während der gesamte Traffic innerhalb der erwarteten Grenzen blieb.
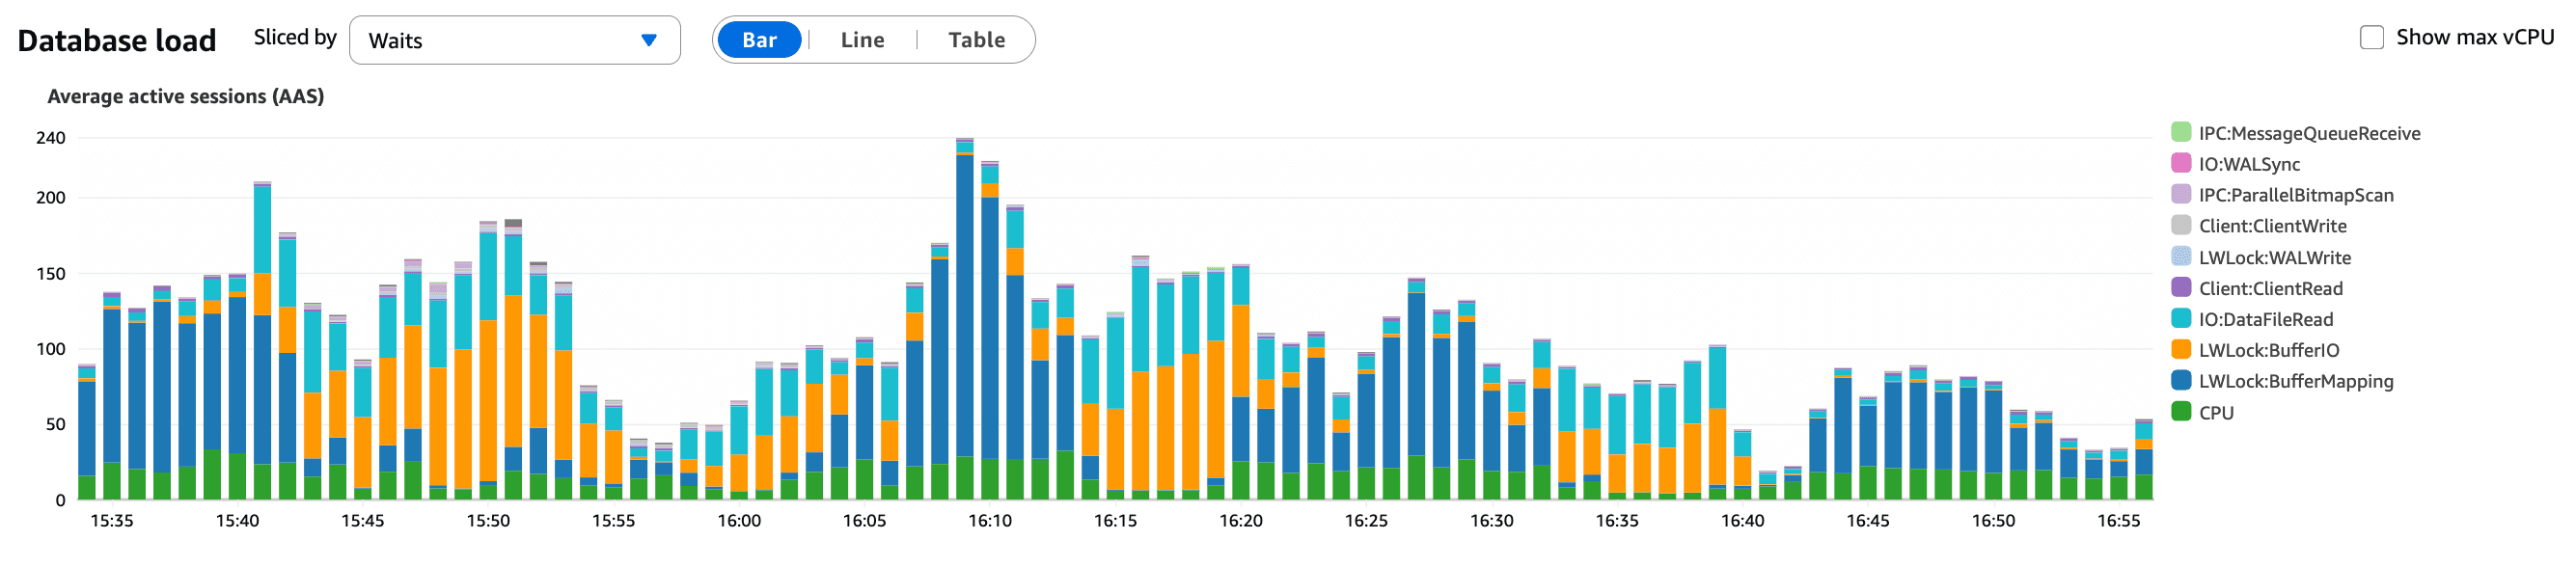
Was dieses Diagramm zeigt:
-
Einen anhaltenden Anstieg aktiver Datenbanksessions
-
Sessions, die sich stauen statt schnell abzuschließen
-
Ein starkes Signal dafür, dass Abfragen langsamer wurden und nicht der Traffic zugenommen hatte
Das deutete auf eine Änderung in unserer Anwendung statt auf einen Traffic-Spike hin, was die Traffic-Analyse bestätigte.
CPU-Sättigung bestätigt den Engpass
Mit steigender Last zog auch die CPU-Auslastung der Datenbank an.
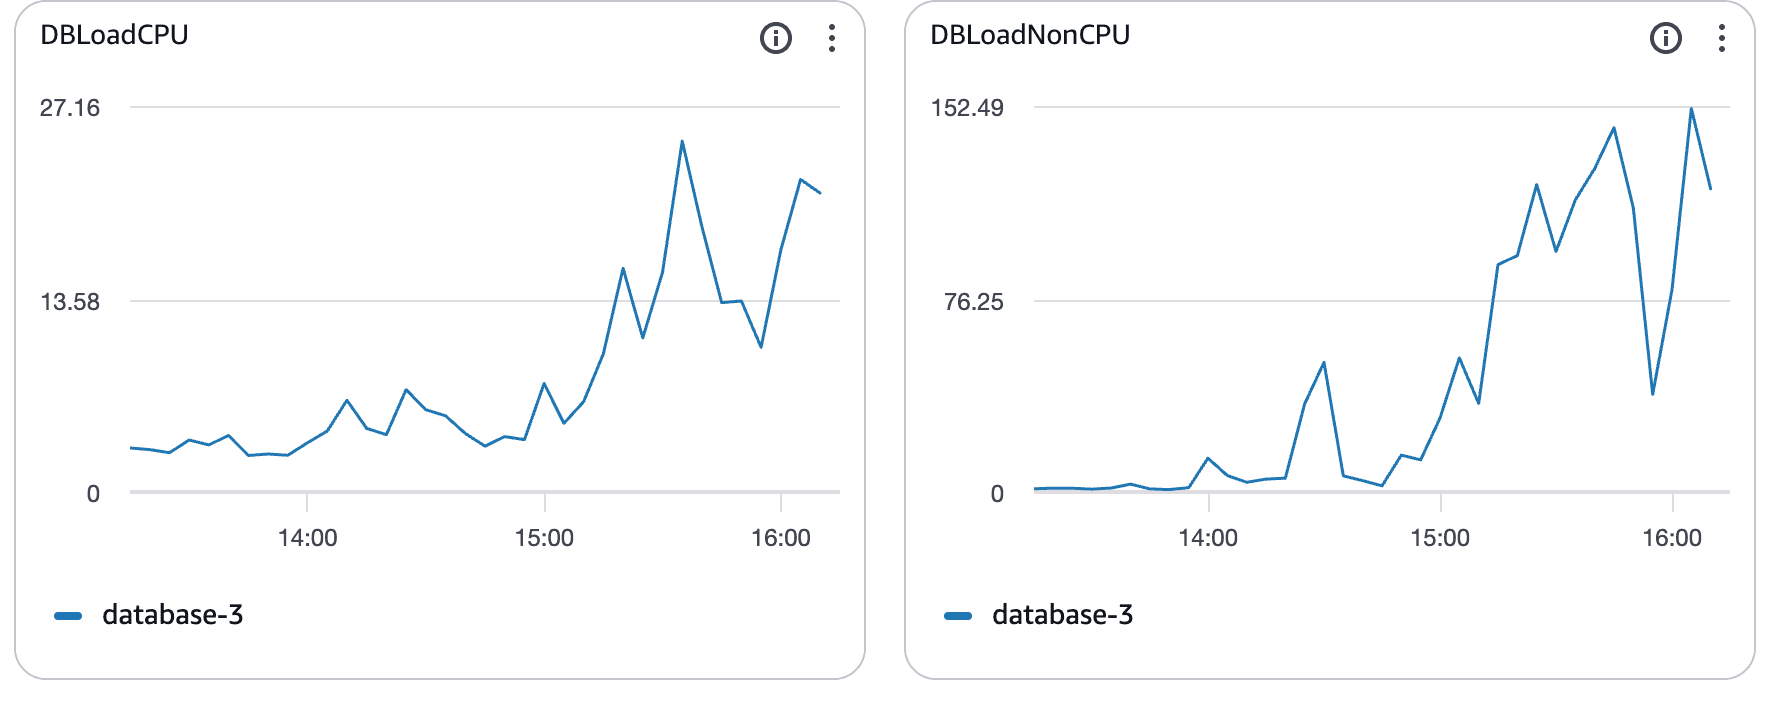
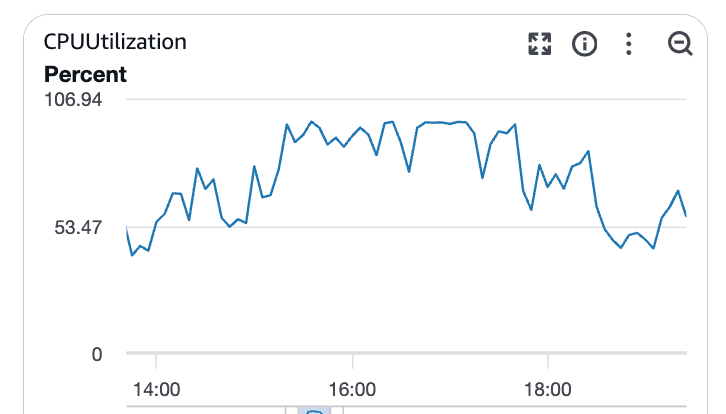
Was diese Diagramme zeigen:
-
Eine CPU-Auslastung, die weit über das Grundniveau hinaus anstieg
-
Anhaltende Sättigung statt kurzer Spitzen
-
Eine klare Korrelation mit steigender Abfrage-Latenz
Zu diesem Zeitpunkt war Postgres CPU-limitiert. Abfragen liefen länger, blockierten andere und die Latenz breitete sich im gesamten System aus.
Zeitachse (UTC)
-
15:30 – Automatische Warnmeldungen wegen hoher DB-Last. Erste Diagnosen zeigten erhöhte
DELETE-Aktivität auf APIv2. -
15:49 – Wir haben die
DELETE-Ratenlimits verschärft, um den unmittelbaren Druck zu verringern. -
16:03 – Weitere Untersuchungen zeigten, dass der Traffic normal war. Die Datenbanklast stieg weiter an.
-
16:06 – Erste Meldungen von Unternehmenskunden, die Scheduling Links nicht laden konnten.
-
16:18 – Vorfall erklärt. Die CPU-Sättigung führte dazu, dass die Statement-Latenz im gesamten System anstieg.
-
17:07 – Wir begannen, eine Abfrage mit hoher Last neu zu schreiben, um den Druck auf die Datenbank zu reduzieren.
-
17:40 – Die neu geschriebene Abfrage wurde bereitgestellt. Das half, löste das Problem aber nicht vollständig.
Der entscheidende Wendepunkt
Um 17:45 identifizierten wir eine unbeabsichtigte Wechselwirkung:
Eine aktuelle Funktion, die am Montag, dem 26., veröffentlicht wurde, führte die Buchungssuche in KBar (CMD+K) ein. Dadurch wurde bei jedem Seitenaufruf in der Web-App ein schwerer API-Aufruf ausgelöst.
Um 17:55 wurde die KBar-Änderung in der Produktion zurückgenommen.
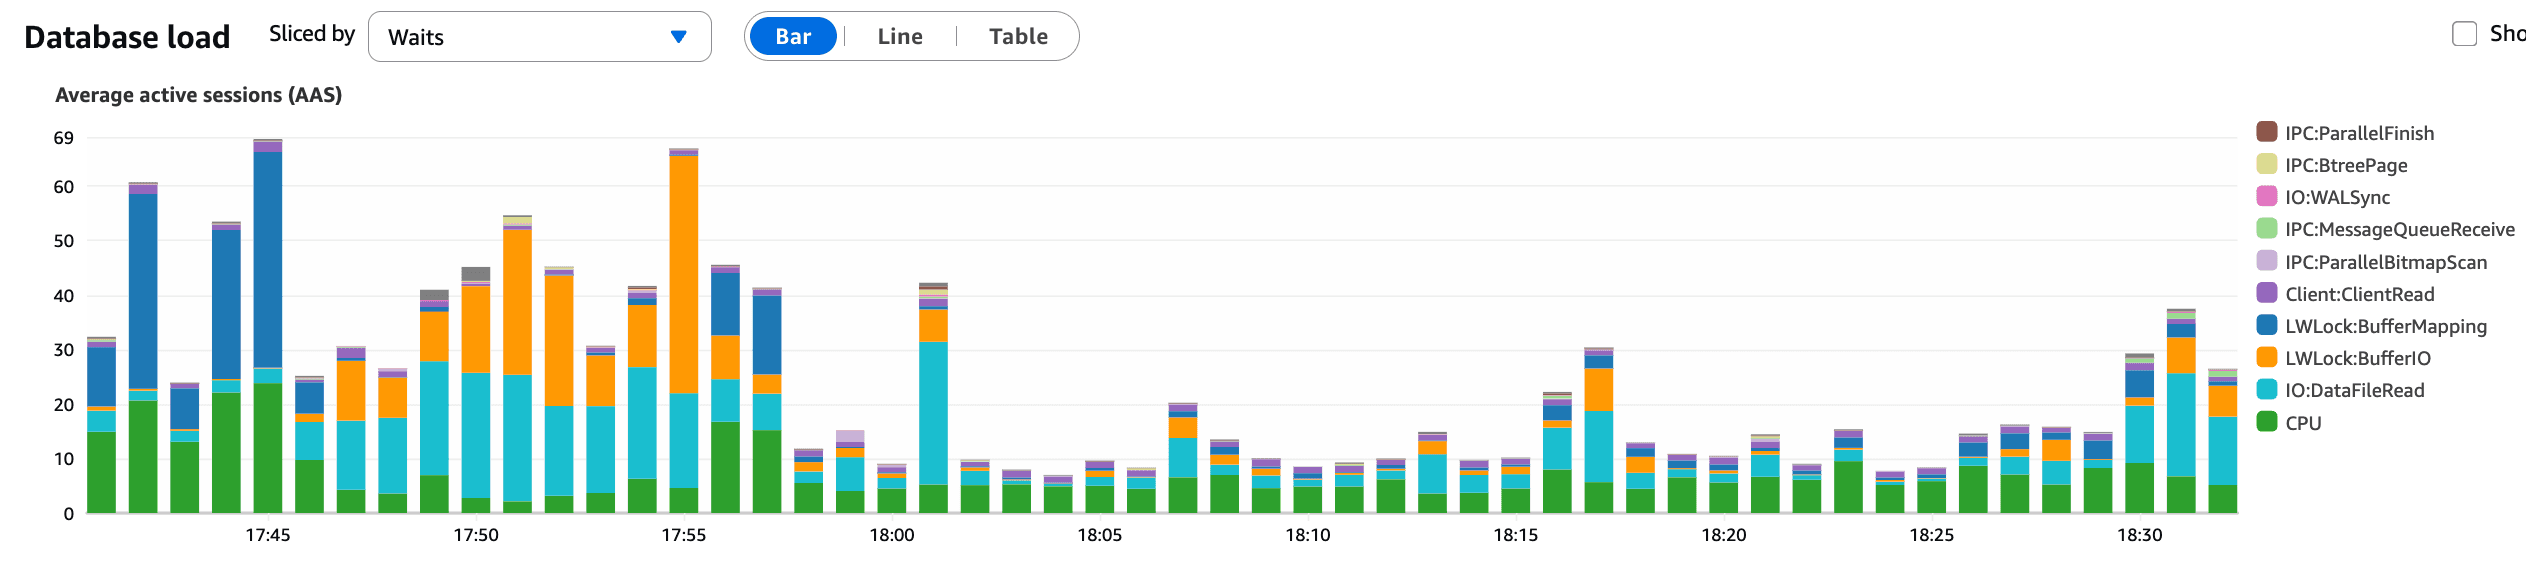
Was dieses Diagramm bestätigt:
-
Einen deutlichen und unmittelbaren Rückgang der AAS nach dem Revert
-
Geringeren Druck auf die Datenbankabfragen
-
Eine kurz darauf stabile Latenz
Das passt genau zum Zeitpunkt des Reverts und bestätigte die KBar-Wechselwirkung als den primären Auslöser des Datenbankvorfalls.
- 18:15 – Die Datenbankleistung stabilisierte sich.
Der primäre DB-Vorfall war zu diesem Zeitpunkt behoben.
Aufgedeckte Folgeprobleme
Nachdem sich die Datenbank erholt hatte, blieb ein kleinerer Teil der Nutzer weiterhin betroffen.
Nutzer mit Google Calendar-Integrationen erlebten Ausfälle aufgrund ausgeschöpfter Google API-Quoten. Ursache dafür war ein Retry-Verhalten über mehrere Consumer hinweg, während upstream Fehler auftraten.
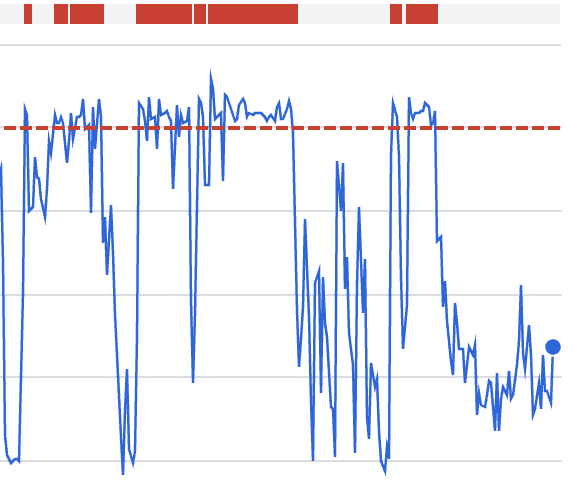
Was dieses Diagramm zeigt:
-
Einen schnellen Verbrauch des Quotenlimits während des Vorfallfensters
-
Eine Korrelation mit Retry-Verhalten statt mit neuem Traffic
-
18:40 – Ursache identifiziert: Atoms-Retry-Logik aktualisiert Kalender aggressiv.
-
18:46 – Die Funktionalität von Atoms wurde vorübergehend unterbrochen. Kalenderereignisse wurden nachgezogen und die Quoten-Nutzung sank.
-
18:54 – Die Leistung von APIv2 blieb leicht beeinträchtigt; ein Teil des Traffics wurde vorübergehend auf Vercel-Endpunkte umgeleitet.
-
19:30 – APIv2 und Google-Integrationen stabilisierten sich vollständig.
Später identifizierten wir ein weiteres beitragendes Problem:
- Ein nicht erwartetes promisified call führte dazu, dass Node-Prozesse abstürzten, wenn Google-API-Fehler in den globalen Scope gelangten.
Ursache
Die primäre Ursache war eine unerwartete Wechselwirkung zwischen Funktionen:
-
KBar löste bei jedem Seitenaufruf einen schweren API-Aufruf aus
-
Dieser API-Pfad beruhte auf teuren Datenbankabfragen; insbesondere für Nutzer mit großem Umfang und vielen Buchungen.
-
Die CPU-Sättigung erhöhte die Abfrage-Latenz im gesamten System
-
Unternehmenskunden mit Scheduling Links mit hohem Volumen waren am stärksten betroffen
Sekundäre Ausfälle (Erschöpfung der Google-Quoten und Instabilität von APIv2) waren nicht die ursprüngliche Ursache, wurden aber sichtbar, sobald das System unter Last stand.
Was wir geändert haben
Seit Dienstag haben wir:
-
Die KBar-Kopplung entfernt, die schwere API-Aufrufe ausgelöst hat (#27314)
-
Mehrere Abfrageoptimierungen ausgeliefert, um die DB-Last zu reduzieren (#27364, #27319, #27309, #27315)
-
Die Paginierung für
/booking/{upcoming,…}von vorgerendert auf On-Demand umgestellt, um die Datenbanknutzung zu senken, während wir den Endpunkt weiter optimieren (#27351) -
Den nicht erwarteten async call behoben, der Node-Prozessabstürze in APIv2 verursachte(#27313)
-
Verschiedene Schutzmechanismen auf DB-Ebene eingerichtet, um unsere Datenbank in Phasen extremer Nutzung zu schützen.
-
Aufruf an DELETE-Endpunkte auf 1 Anfrage pro Sekunde begrenzt (#27359)
Fazit
Dieser Vorfall wurde nicht durch Traffic-Spitzen oder einen Infrastrukturfehler verursacht. Er wurde durch eine unerwartete Funktionswechselwirkung ausgelöst, mit Kaskadenproblemen aufgrund von Retry-Verhalten nachgelagerter Systeme und einem subtilen Anwendungsfehler.
Es tut uns leid für die Störung, besonders für Kundinnen und Kunden im großen Maßstab. Der Vorfall vom Dienstag hat direkt Verbesserungen daran angestoßen, wie wir Funktionen ausliefern, unsere Datenbank schützen und Kaskadenausfälle behandeln.
Danke für eure Geduld und dafür, dass ihr uns an einem hohen Standard messt.