Ingénierie en 2026 et au-delà
Nous construisons une infrastructure qui ne doit presque jamais tomber en panne. Pour y parvenir, nous avançons vite tout en livrant un logiciel d’une qualité exceptionnelle, sans raccourcis ni compromis. Ce document décrit les standards d’ingénierie qui nous guideront en 2026 et au-delà.
On this page
- Structure d’équipe
- Nos résultats jusqu’à présent
- La fondation de Cal.com permet l’excellence pour coss.com
- Principes fondamentaux
- 1. Aucune qualité différée
- 2. Standards élevés en revue de code
- 3. Poussez-vous les uns les autres à faire ce qu’il faut
- 4. Visez la simplicité
- 5. Automatisez tout
- Standards architecturaux
- Vertical Slice Architecture : packages/features
- Pourquoi les tranches verticales sont importantes
- Directives pour l'organisation des fonctionnalités
- Avantages
- Modèle Repository et injection de dépendances
- Objets de transfert de données (DTO)
- Patterns de conception pilotée par le domaine
- Cohérence de la base de code
- Déplacez les conditions vers le point d'entrée de l'application
- Pourquoi c'est important
- Comment y parvenir
- Conception de l’API : controllers légers et abstraction HTTP
- Versioning de l’API et changements cassants
- Performance et complexité algorithmique
- Pensez à l’échelle dès le premier jour
- Choisissez les bons types de données et les bons algorithmes
- Contrôles automatisés des performances
- La performance est une fonctionnalité
- La réalité NP-difficile de la planification
- Exigences de couverture de code
- Mesurer le succès
Structure d’équipe
Notre organisation d’ingénierie se compose de cinq équipes principales, chacune ayant des responsabilités distinctes :
-
Foundation Team : se concentre sur l’établissement et la maintenance des standards de code et des modèles architecturaux. Cette équipe travaille en collaboration avec les autres équipes pour définir les meilleures pratiques à l’échelle de l’organisation.
-
Consumer, Enterprise, and Platform Teams : des équipes centrées sur le produit qui livrent rapidement des fonctionnalités tout en maintenant les standards de qualité définis dans ce document. Ces équipes prouvent que vitesse et qualité ne sont pas mutuellement exclusives.
-
Community Team : chargée d’examiner rapidement les PR de la communauté open source, de fournir du feedback et d’accompagner ce travail jusqu’à la fusion. Cette équipe veille à ce que nos contributeurs open source vivent une excellente expérience et que leurs contributions respectent nos standards de qualité. Le maintien d’une forte culture open-source continue de façonner la manière dont Cal.com aborde la collaboration en ingénierie et le développement produit.
Nos résultats jusqu’à présent
Les chiffres parlent d’eux-mêmes. Au cours de l’année et demie écoulée, nous avons transformé en profondeur notre manière de construire des logiciels :

Nous avons à peu près doublé notre volume de développement tout en améliorant simultanément la qualité. Ce qui est encore plus impressionnant, c’est l’évolution de ce que nous construisons :

Nous avons réussi à réallouer environ 20 % des efforts d’ingénierie des corrections vers les fonctionnalités, les améliorations de performance, les refactorings et les tâches de maintenance. Ce changement montre qu’investir dans la qualité et l’architecture ne vous ralentit pas. Cela vous accélère.
La fondation de Cal.com permet l’excellence pour coss.com
-
Cal.com est une entreprise stable et rentable que nous continuerons à faire grandir.
- Ce succès nous donne un avantage unique à mesure que nous construisons coss.com. Contrairement aux débuts de Cal.com, où nous devions aller vite pour atteindre l’adéquation produit-marché et bâtir une activité durable, coss.com part d’une position de force.
-
Nous n’avons pas besoin de nous précipiter sur coss.com.
- La stabilité de Cal.com signifie que nous pouvons nous permettre de construire coss.com de la bonne manière dès le premier jour. Nous avons le luxe d’appliquer ces standards d’ingénierie sans la pression immédiate du marché ni les contraintes de financement. C’est un point de départ fondamentalement différent.
-
La « lenteur » est un investissement, pas un coût.
- Oui, suivre ces standards peut sembler plus lent au départ et peut même être frustrant pour certains ingénieurs. Écrire des DTO prend plus de temps que de transmettre directement les types de base de données au frontend. Créer des abstractions adaptées et pratiquer l’injection de dépendances demande davantage de conception en amont. Maintenir une couverture de tests de 80 % ou plus pour le nouveau code exige de la discipline. Mais cette lenteur apparente est temporaire, et le retour est exponentiel.
Considérez les rendements composés...
-
Un code correctement architecturé dès le départ n’a pas besoin de refactorings massifs plus tard
-
Une forte couverture de tests empêche des bugs qui, autrement, consommeraient des semaines de débogage et de correctifs urgents (voir 2023 à mi-2024)
-
De bonnes abstractions rendent l’ajout de nouvelles fonctionnalités considérablement plus rapide au fil du temps
-
Des frontières propres et des DTO empêchent l’érosion architecturale qui finit par exiger des réécritures complètes
La trajectoire de Cal.com montre ce qui se passe quand vous optimisez pour une vélocité immédiate. Une vitesse initiale élevée qui se dégrade progressivement à mesure que la dette technique s’accumule, que des raccourcis architecturaux créent des goulots d’étranglement, et que de plus en plus de temps est consacré à corriger des problèmes plutôt qu’à construire des fonctionnalités (voir le graphique précédent où nous consacrions 55 à 60 % des efforts d’ingénierie aux corrections).
La trajectoire de coss.com adoptera la puissance d’une construction correcte dès le premier jour. Une vélocité initiale légèrement plus lente pendant la mise en place de modèles adaptés, suivie d’une accélération exponentielle à mesure que ces modèles porteront leurs fruits et permettront un développement plus rapide avec davantage de confiance.
Principes fondamentaux
1. Aucune qualité différée
-
Nous réduirons au minimum le « je le ferai dans une PR de suivi » pour les petits refactorings.
- Les PR de suivi pour des améliorations mineures n’aboutissent que rarement. À la place, elles s’accumulent sous forme de dette technique qui nous pèse des mois ou des années plus tard. Si un petit refactoring peut être fait maintenant, faites-le maintenant. Les suivis doivent être réservés aux changements importants qui justifient réellement des PR séparées ou à des cas exceptionnels et urgents.
2. Standards élevés en revue de code
-
Ne laissez pas passer des PR avec beaucoup de remarques juste pour éviter d’être « la mauvaise personne ».
- C’est précisément ainsi que les bases de code deviennent négligées avec le temps. La revue de code n’a pas pour but d’être aimable. Elle sert à maintenir les standards de qualité que notre infrastructure exige. Chaque détail compte. Chaque violation de pattern compte. Corrigez-les avant la fusion, pas après.
3. Poussez-vous les uns les autres à faire ce qu’il faut
-
Nous nous tenons mutuellement responsables de la qualité
- Couper les coins peut sembler plus rapide sur le moment, mais cela crée des problèmes qui ralentissent tout le monde ensuite. Quand vous voyez un collègue sur le point de fusionner une PR avec des problèmes évidents, dites-le. Quand quelqu’un propose un bidouillage rapide au lieu de la bonne solution, opposez-vous-y. Quand vous êtes tenté de sauter les tests ou d’ignorer les modèles architecturaux, attendez-vous à ce que vos collègues vous challengent.
-
Il ne s’agit pas d’être pénible ni de ralentir les gens
- Il s’agit d’une responsabilité collective vis-à-vis de notre base de code et de notre réputation. Chaque raccourci pris par une personne devient le problème de tout le monde. Chaque coin coupé aujourd’hui signifie davantage de sessions de débogage, davantage de correctifs urgents et davantage de clients frustrés demain.
-
Faites en sorte qu’il soit normal de contester des mauvaises décisions, avec respect
- Si quelqu’un dit « faisons juste un hard-code pour l’instant », la réponse attendue devrait être « qu’est-ce qu’il faudrait pour le faire correctement du premier coup ? » Si quelqu’un veut committer du code non testé, l’équipe doit s’y opposer. Si quelqu’un propose de copier-coller au lieu de créer une abstraction adaptée, signalez-le avec respect.
-
Nous construisons quelque chose qui doit presque jamais tomber en panne
- Un tel niveau de fiabilité n’arrive pas par hasard. Il se produit lorsque chaque ingénieur se sent responsable de la qualité, non seulement de son propre code mais de l’ensemble du système. Nous réussissons en équipe ou nous échouons en équipe.
4. Visez la simplicité
-
Privilégiez la clarté à l’ingéniosité
- Le but est d’avoir du code facile à lire et à comprendre rapidement, pas une complexité élégante. Les systèmes simples réduisent la charge cognitive de chaque ingénieur.
-
Posez-vous les bonnes questions
-
Est-ce que je résous vraiment le problème en question ?
-
Est-ce que je pense trop aux cas d’usage futurs possibles ?
-
Ai-je envisagé au moins une autre alternative pour résoudre cela ? Comment se compare-t-elle ?
-
-
Simple ne veut pas dire pauvre en fonctionnalités
- Ce n’est pas parce que notre objectif est de créer des systèmes simples qu’ils doivent sembler anémiques et manquer de fonctionnalités évidentes.
5. Automatisez tout
-
Tirez parti de l’IA
-
Générez 80 % du code standard et non critique grâce à l'IA, ce qui nous permet de nous concentrer uniquement sur la logique métier complexe et les architectures critiques. Les Teams qui adoptent des workflows modernes assistés par l'IA s'appuient de plus en plus sur des outils comme les meilleurs serveurs MCP pour améliorer la productivité et l'orchestration des développeurs.
-
Construisez un système d’alertes sans bruit parasite et une gestion intelligente des erreurs.
-
Les tests manuels deviennent de plus en plus une chose du passé. L’IA peut rapidement et intelligemment construire pour nous d’immenses suites de tests.
-
-
Notre CI est le boss final
-
Tout ce qui figure dans ce document de standards est vérifié avant que le code ne soit fusionné dans les PR
-
Aucune surprise n’arrive jusqu’à main
-
Les vérifications sont rapides et utiles
-
Standards architecturaux
Nous passons à un modèle architectural strict basé sur Vertical Slice Architecture et Domain-Driven Design (DDD). Les schémas et principes suivants seront appliqués avec rigueur dans les revues de PR et via le linting.
Vertical Slice Architecture : packages/features
Notre base de code est organisée par domaine, et non par couche technique. Le répertoire packages/features est le cœur de cette approche architecturale. Chaque dossier qu’il contient représente une tranche verticale complète de l’application, guidée par le domaine qu’il touche.
Structure :
packages/features/
  availability/
  bookings/
  ooo/
  payments/
  routing/
  scheduling/
  ...
Chaque dossier de fonctionnalité est une tranche verticale autonome qui inclut tout ce qui est nécessaire à ce domaine :
-
Logique de domaine : les règles métier fondamentales et les entités propres à cette fonctionnalité
-
Services applicatifs : orchestration des cas d’usage pour ce domaine
-
Repositories : accès aux données spécifique aux besoins de cette fonctionnalité
-
DTO : objets de transfert de données pour franchir les frontières
-
Composants UI : composants frontend liés à cette fonctionnalité (le cas échéant)
-
Tests : tests unitaires, d’intégration et e2e pour cette fonctionnalité
Pourquoi les tranches verticales sont importantes
L’architecture traditionnelle en couches s’organise selon des préoccupations techniques :
// Bad: Organized by layer
src/
  controllers/
    AvailabilityController.ts
    BookingController.ts
    OOOController.ts
  services/
    AvailabilityService.ts
    BookingService.ts
    OOOService.ts
  repositories/
    AvailabilityRepository.ts
    BookingRepository.ts
    OOORepository.ts
Cela crée plusieurs problèmes :
-
Les changements apportés à une fonctionnalité exigent de modifier des fichiers dispersés dans plusieurs répertoires
-
Il est difficile de comprendre ce que fait une fonctionnalité parce que son code est fragmenté
-
Les Teams se marchent sur les pieds lorsqu'elles travaillent sur différentes fonctionnalités
-
Vous ne pouvez pas facilement extraire ou déprécier une fonctionnalité
L'architecture en tranche verticale organise par domaine :
// Good: Organized by domain
packages/features/
  availability/
    services/
      AvailabilityApplicationService.ts
      AvailabilityDomainService.ts
    repositories/
      AvailabilityRepository.ts
    dto/
      AvailabilityDto.ts
bookings/
  services/
    BookingApplicationService.ts
    BookingDomainService.ts
  repositories/
    BookingRepository.ts
  dto/
    BookingDto.ts
Cela résout ces problèmes :
-
Tout ce qui concerne la disponibilité se trouve dans
packages/features/availability -
Vous pouvez comprendre toute la fonctionnalité de disponibilité en explorant un seul répertoire
-
Les Teams peuvent travailler sur différentes fonctionnalités sans conflit (si l'équipe d'ingénierie de Cal.com grandit, mais très certainement chez coss.com nous ferons en sorte que des teams prennent en charge les principaux lots)
-
Les fonctionnalités sont faiblement couplées et peuvent évoluer indépendamment
Directives pour l'organisation des fonctionnalités
En théorie, chaque fonctionnalité peut être déployée indépendamment. Même si nous ne les déployons peut-être pas séparément en pratique, organiser ainsi nous oblige à garder des dépendances claires et un couplage minimal. C'est le principe et la réussite des microservices, même si nous ne déploierons pas encore de microservices.
Les fonctionnalités communiquent via des interfaces bien définies. Si bookings a besoin de données de disponibilité, il les importe depuis @calcom/features/availability via des interfaces exportées, et non en allant chercher dans les détails d'implémentation internes.
Le code partagé se trouve aux bons endroits :
-
Utilitaires agnostiques du domaine et préoccupations transverses (auth, logging) :
packages/lib -
Primitives UI partagées :
packages/ui(et bientôt coss.com ui)
Les frontières du domaine sont appliquées automatiquement. Nous allons créer un linting qui empêche d'aller fouiller dans les entrailles des fonctionnalités là où vous ne devriez pas être autorisé à aller. Si packages/features/bookings essaie d'importer depuis packages/features/availability/services/internal, le linter le bloquera. Toutes les dépendances entre fonctionnalités doivent passer par l'API publique de la fonctionnalité.
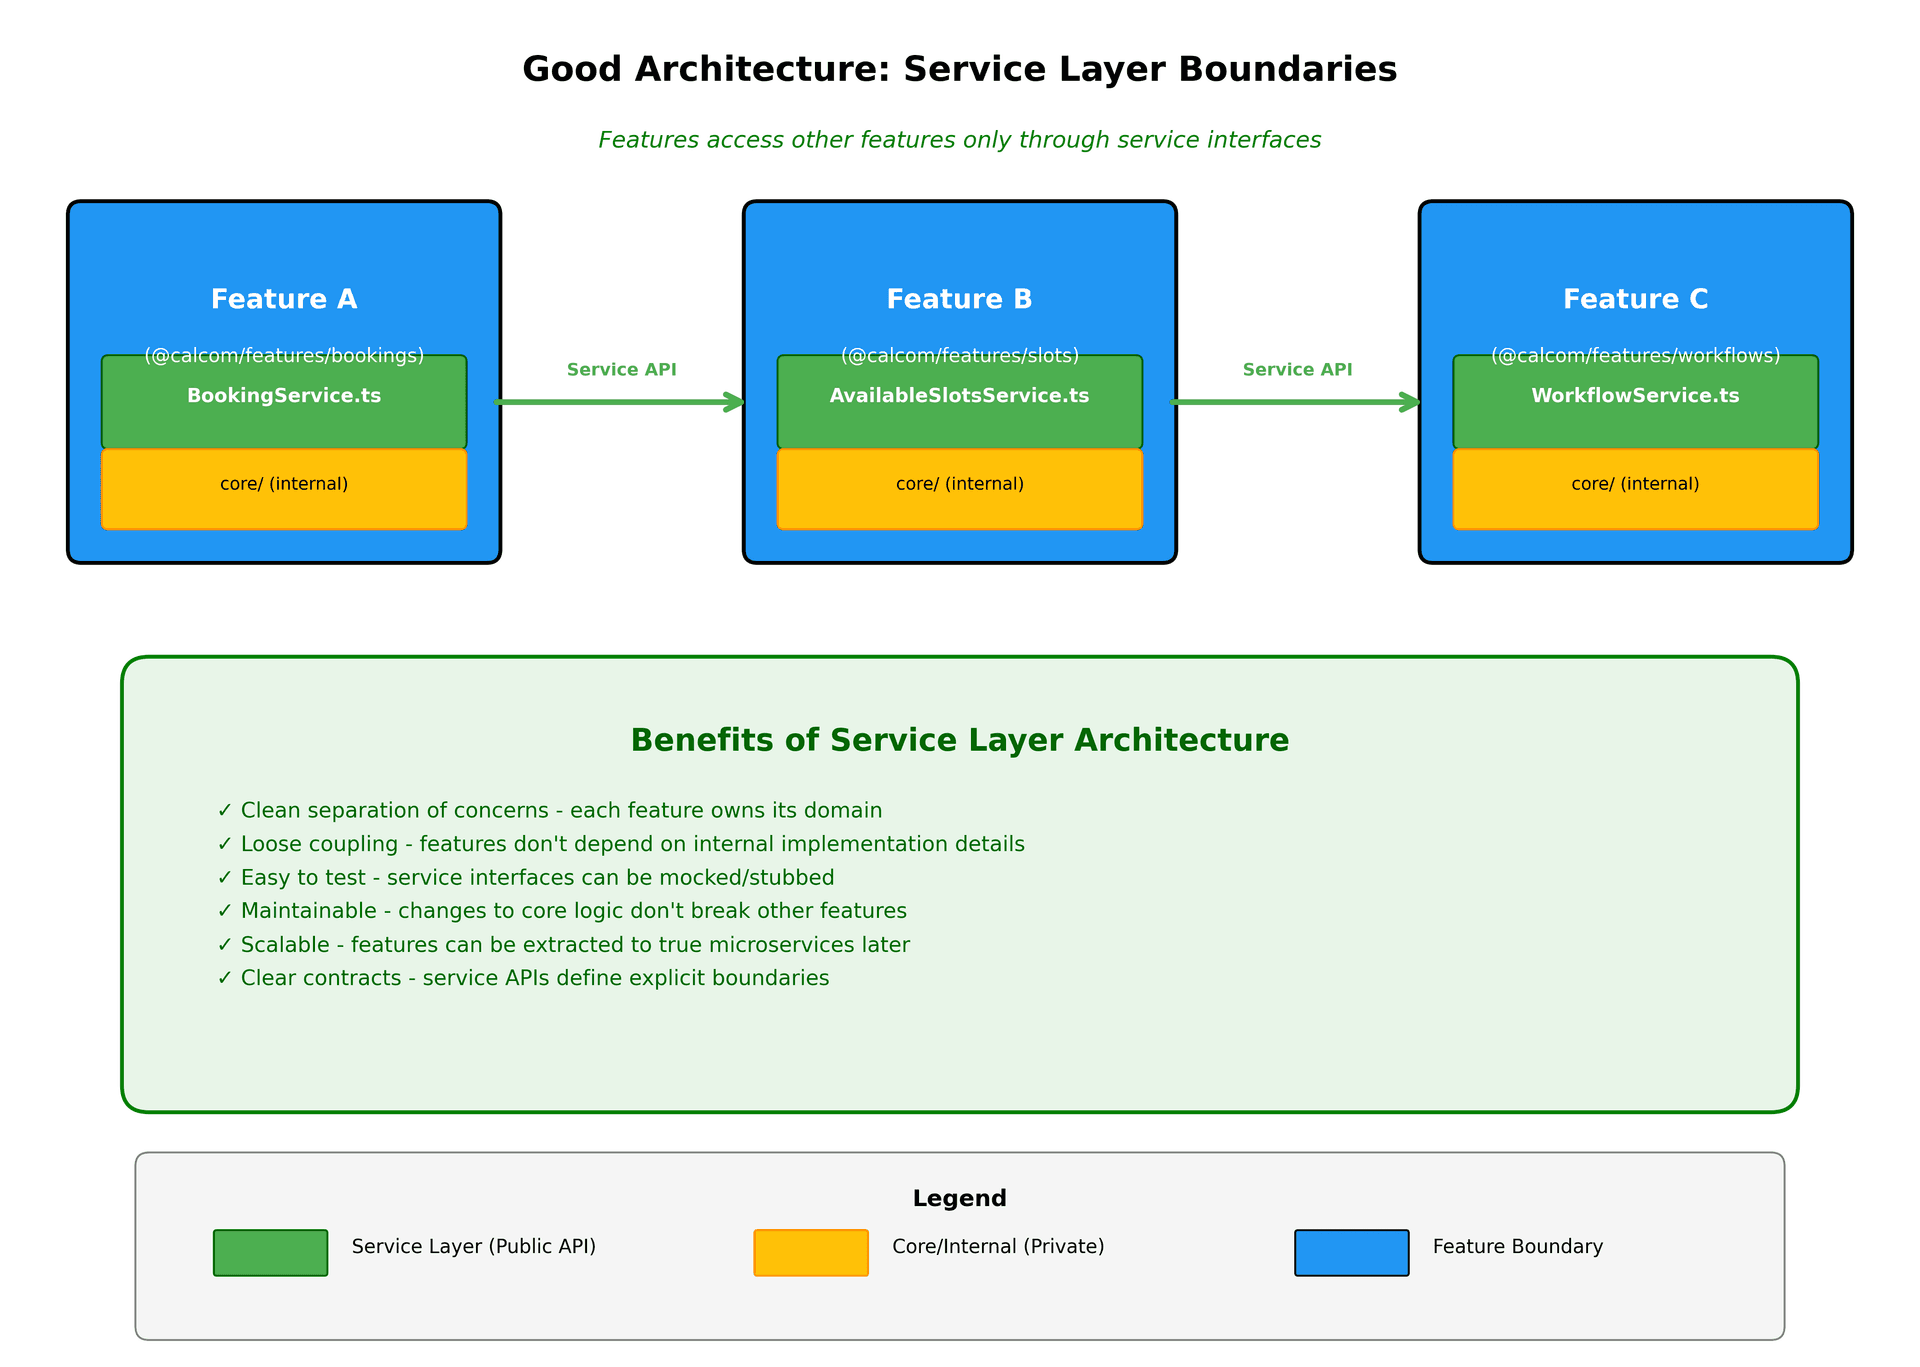
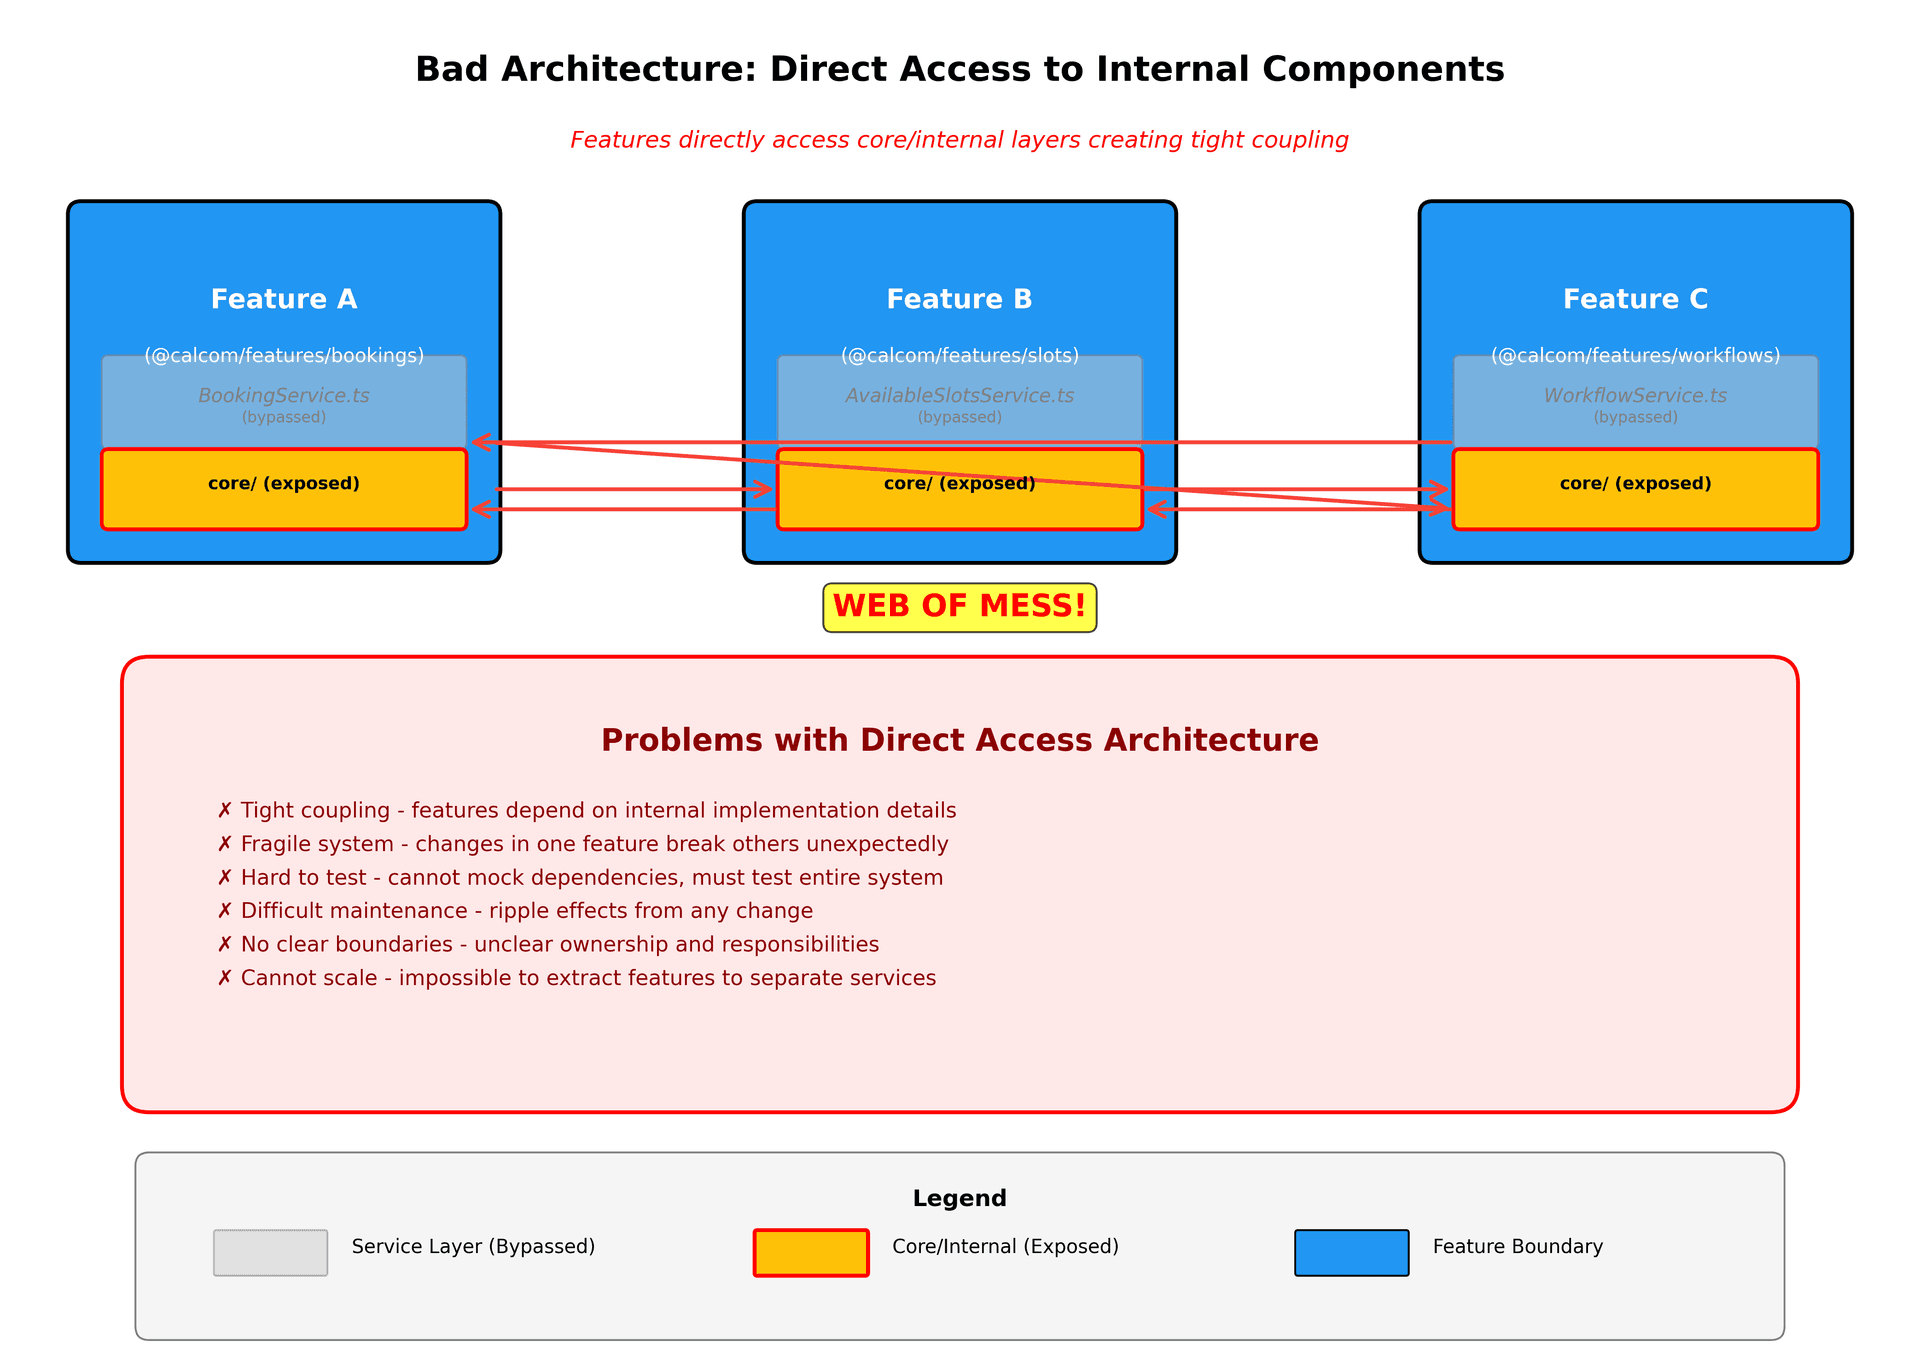
Les nouvelles fonctionnalités commencent comme des tranches verticales. Quand vous construisez quelque chose de nouveau, créez un nouveau dossier dans packages/features avec la tranche verticale complète. Cela rend clair ce que vous construisez et garde tout organisé dès le premier jour.
Avantages
-
Découvrabilité
- Vous cherchez la logique de réservation ? Tout est dans
packages/features/bookings. Pas besoin de fouiller dans des contrôleurs, services, dépôts et utilitaires dispersés dans toute la base de code.
- Vous cherchez la logique de réservation ? Tout est dans
-
Tests plus simples
- Testez toute la fonctionnalité comme une unité. Vous avez toutes les pièces au même endroit, ce qui rend les tests d'intégration naturels et simples.
-
Dépendances plus claires
- Quand vous voyez
import { getAvailability } from '@calcom/features/availability', vous savez exactement de quelle fonctionnalité vous dépendez. Quand les dépendances deviennent trop complexes, c'est évident et cela peut être corrigé.
- Quand vous voyez
Modèle Repository et injection de dépendances
Les choix technologiques ne doivent pas se diffuser dans toute l'application. Le problème Prisma l'illustre parfaitement. Nous avons actuellement des références à Prisma éparpillées dans des centaines de fichiers. Cela crée un couplage massif et rend les changements de technologie prohibitivement coûteux. Nous ressentons maintenant la douleur de la mise à niveau de Prisma vers v6.16. Ce qui aurait dû n'être qu'un refactoring local derrière des repositories protégés s'est transformé en une traque sinueuse, presque sans fin, de problèmes à travers plusieurs apps.
La norme à l'avenir :
-
Tout accès à la base de données doit passer par des classes Repository. Nous avons déjà une bonne longueur d'avance là-dessus.
-
Les repositories sont le seul code qui connaît Prisma (ou tout autre ORM). Aucun logique ne doit s'y trouver.
-
Les repositories sont injectés via des conteneurs Dependency Injection
-
Si un jour nous passons de Prisma à Drizzle ou à un autre ORM, les seuls changements nécessaires sont :
-
Les implémentations des repositories
-
Le câblage du conteneur DI pour les nouveaux repositories
-
Rien d'autre dans la base de code ne devrait s'en soucier ou changer
-
Ce n'est pas théorique. C'est ainsi que nous construisons des systèmes maintenables.
Objets de transfert de données (DTO)
Les types de base de données ne doivent pas fuiter vers le frontend. C'est devenu un raccourci populaire dans notre stack technique, mais c'est une odeur de code qui crée plusieurs problèmes.
-
Couplage technologique (les types Prisma finissent dans les composants React)
-
Risques de sécurité (fuite accidentelle de champs sensibles)
-
Contrats fragiles entre serveur et client (c'est particulièrement problématique à mesure que nous construisons beaucoup plus d'API)
-
Impossibilité de faire évoluer le schéma de la base de données indépendamment
-
Toutes les conversions de DTO via Zod, même pour une réponse d'API, afin de garantir que toutes les données sont validées avant l'envoi à l'utilisateur. Mieux vaut échouer que renvoyer quelque chose d'incorrect.
La norme à l'avenir :
Créez des DTO explicites à chaque frontière architecturale.
-
Couche de données → Couche applicative → API : Transformez les modèles de base de données en DTO de la couche applicative, puis transformez les DTO applicatifs en DTO spécifiques à l'API
-
API → Couche applicative → Couche de données : Transformez les DTO de l'API via la couche applicative et en DTO spécifiques aux données
Oui, cela demande plus de code. Oui, cela en vaut la peine. Des frontières explicites empêchent l'érosion architecturale qui crée des cauchemars de maintenance à long terme.
Patterns de conception pilotée par le domaine
Les patterns suivants doivent être utilisés correctement et de manière cohérente :
-
Services applicatifs
- Orchestrent les cas d'usage, coordonnent les services de domaine et les repositories
-
Services de domaine
- Contiennent la logique métier qui n'appartient pas naturellement à une seule entité
-
Repositories
- Abstraient l'accès aux données, isolent les choix technologiques
-
Injection de dépendances
- Permet le faible couplage, facilite les tests, isole les préoccupations
-
Proxies de cache
-
Enveloppent les repositories ou services pour ajouter un comportement de mise en cache de manière transparente
-
Ce n'est évidemment pas la seule façon de faire du cache, mais c'est un bon point de départ
-
-
Décorateurs
- Ajoutent des préoccupations transverses (logging, métriques, etc.) sans polluer la logique métier
Cohérence de la base de code
Nos bases de code devraient donner l'impression qu'une seule personne les a écrites. Ce niveau de cohérence exige un respect strict des patterns établis, des règles de linting complètes qui imposent les standards architecturaux, des code reviews qui rejettent les violations de pattern + l'aide de relecteurs de code IA.
Déplacez les conditions vers le point d'entrée de l'application
Les instructions if doivent appartenir au point d'entrée, pas être dispersées dans vos services. C'est l'un des principes architecturaux les plus importants pour maintenir un code propre et ciblé qui ne dérive pas vers une complexité ingérable.
Voici comment le code se dégrade au fil du temps : un service est écrit pour un objectif clair et spécifique. La logique est propre et ciblée. Puis une nouvelle exigence produit arrive, et quelqu'un ajoute une instruction if. Quelques années et plusieurs exigences plus tard, ce service est jonché de vérifications conditionnelles pour différents scénarios. Le service est devenu :
-
Compliqué et difficile à lire
-
Difficile à comprendre et à raisonner
-
Plus sensible aux bugs
-
En violation du principe de responsabilité unique (il gère trop de cas différents)
-
Presque impossible à tester de manière exhaustive
Le service a dépassé ses limites en termes de responsabilités et de logique.
Une solution : le pattern Factory avec des services spécialisés
Utilisez le pattern Factory pour prendre les décisions au point d'entrée, puis déléguez à des services spécialisés qui gèrent leur logique spécifique sans conditions.
Exemple dans notre base de code :
BillingPortalServiceFactory détermine si la facturation concerne une organisation, une équipe ou un utilisateur individuel, puis renvoie le service approprié :
export class BillingPortalServiceFactory {
  static async createService(teamId: number): Promise<BillingPortalService> {
    const team = await teamRepository.findById({ id: teamId });
    if (!team) {
      throw new Error("Team not found");
    }
    // Decision made HERE at the entry point
    if (team.isOrganization) {
      return new OrganizationBillingPortalService();
    }
    return new TeamBillingPortalService();
  }

  static createUserService(): UserBillingPortalService {
    return new UserBillingPortalService();
  }
}
Chaque service gère ensuite sa logique spécifique sans avoir besoin de vérifier « suis-je une organisation ou une équipe ? » :
// OrganizationBillingPortalService handles ONLY organization logic
class OrganizationBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "organization.manageBilling",  // Organization-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more organization-specific logic
}

// TeamBillingPortalService handles ONLY team logic
class TeamBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "team.manageBilling",  // Team-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more team-specific logic
}
Pourquoi c'est important
-
Les services restent ciblés
- Chaque service a une seule responsabilité et n'a pas besoin de connaître les autres contextes.
OrganizationBillingPortalServicene contient pas d'instructions if qui vérifientif (isTeam)ouif (isUser). Il sait seulement gérer les organisations.
- Chaque service a une seule responsabilité et n'a pas besoin de connaître les autres contextes.
-
Les changements sont isolés
- Lorsque vous avez besoin de modifier la logique de facturation de l’organisation, vous ne touchez qu’à
OrganizationBillingPortalService. Vous ne risquez pas de casser la facturation de l’équipe ou de l’utilisateur. Vous n’avez pas besoin de suivre des conditions imbriquées pour comprendre quel chemin votre code emprunte.
- Lorsque vous avez besoin de modifier la logique de facturation de l’organisation, vous ne touchez qu’à
-
Les tests sont simples
- Testez chaque service indépendamment avec ses scénarios spécifiques. Inutile de tester toutes les combinaisons de conditions dans différents contextes.
-
Les nouvelles exigences ne polluent pas le code existant
- par ex. lorsque vous devez ajouter une facturation enterprise avec des règles différentes, vous créez
EnterpriseBillingPortalService. La factory gagne une condition supplémentaire, mais les services existants restent intacts et ciblés.
- par ex. lorsque vous devez ajouter une facturation enterprise avec des règles différentes, vous créez
Comment y parvenir
-
Remontez les conditions vers les controllers, les factories ou la logique de routing. Laissez ces points d’entrée décider quel service utiliser.
-
Gardez les services purs et centrés sur une seule responsabilité. Si un service doit se demander « de quel type suis-je ? », vous avez probablement besoin de plusieurs services.
-
Préférez le polymorphisme aux conditions
- Les interfaces définissent le contrat. Les implémentations concrètes fournissent les détails.
-
Surveillez l’accumulation de if
- Lors de la revue de code, si vous voyez qu’un service accumule des conditions pour différents scénarios, c’est le signe qu’il faut le refactoriser en services spécialisés.
Conception de l’API : controllers légers et abstraction HTTP
-
Les controllers sont des couches légères qui ne gèrent que les préoccupations HTTP.
- Ils reçoivent les requêtes, les traitent et mappent les données vers des DTO transmis à la logique métier principale. À l’avenir, aucune logique applicative ou métier ne doit apparaître dans les routes API ni dans les handlers tRPC.
-
Nous devons détacher la technologie HTTP de notre application.
- La manière dont nous transférons les données entre le client et le serveur (REST, tRPC, etc.) ne doit pas influencer le fonctionnement de notre application principale. HTTP est un mécanisme de livraison, pas un moteur architectural.
Responsabilités des controllers (et SEULEMENT celles-ci) :
-
Recevoir et valider les requêtes entrantes
-
Extraire les données des paramètres de requête, du corps et des en-têtes
-
Transformer les données de la requête en DTO
-
Appeler les services applicatifs appropriés avec ces DTO
-
Transformer les réponses des services applicatifs en DTO de réponse
-
Retourner des réponses HTTP avec les bons codes de statut
Les controllers ne doivent PAS :
-
Contenir de logique métier ni de règles du domaine
-
Accéder directement aux bases de données ou à des services externes
-
Effectuer des transformations de données ou des calculs complexes
-
Décider de ce que l’application doit faire
-
Connaître les détails d’implémentation du domaine
Exemple de modèle de controller léger :
// Good: Thin controller
export async function createBookingHandler(req: Request, res: Response) {
  // Extract and validate request data
  const createBookingRequest = validateCreateBookingRequest(req.body);
  // Transform to DTO
  const createBookingDto = {
    userId: req.user.id,
    eventTypeId: createBookingRequest.eventTypeId,
    startTime: createBookingRequest.startTime,
    // ... other fields
  };
  // Delegate to application service
  const result = await bookingApplicationService.createBooking(createBookingDto);
  // Transform response and return
  const responseDto = mapBookingToResponseDto(result);
  res.status(201).json(responseDto);
}

// Bad: Fat controller with business logic
export async function createBookingHandler(req: Request, res: Response) {
  // This is wrong - business logic in controller
  if (req.body.startTime < new Date()) {
    return res.status(400).json({ error: "Cannot book in the past" });
  }

  // This is wrong - direct database access
  const existingBooking = await prisma.booking.findFirst({
    where: { eventTypeId: req.body.eventTypeId, startTime: req.body.startTime }
  });

  // This is wrong - complex business calculations
  const duration = calculateBookingDuration(req.body.eventTypeId);
  // ... more business logic
}
Versioning de l’API et changements cassants
Aucun changement cassant. C’est critique. Une fois qu’un endpoint API est public, il doit rester stable. Les changements cassants détruisent la confiance des développeurs et créent des cauchemars d’intégration pour nos utilisateurs.
Stratégies pour éviter les changements cassants :
-
Ajoutez toujours les nouveaux champs comme optionnels
-
Utilisez le versioning d’API lorsque vous devez modifier un comportement existant
-
Dépréciez les anciens endpoints avec grâce, avec des chemins de migration clairs
-
Maintenez la compatibilité ascendante pendant au moins deux versions majeures
Quand vous devez faire des changements cassants :
-
Créez une nouvelle version d’API en utilisant le versioning daté dans API v2 (nous regarderons peut-être aussi le versioning nommé que Stripe a récemment introduit)
-
Faites fonctionner les deux versions simultanément pendant la transition (nous le faisons déjà dans API v2)
-
Fournissez des outils de migration automatisés lorsque c’est possible
-
Donnez aux utilisateurs suffisamment de temps pour migrer (minimum 6 mois pour les API publiques)
-
Documentez précisément ce qui a changé et pourquoi
Performance et complexité algorithmique
Nous construisons pour les grandes organisations et les équipes. Ce qui fonctionne très bien avec 10 utilisateurs ou 50 enregistrements peut s’écrouler sous le poids d’une échelle enterprise. La performance n’est pas quelque chose que nous optimisons plus tard. C’est quelque chose que nous construisons correctement dès le départ.
Pensez à l’échelle dès le premier jour
Quand vous construisez des fonctionnalités, demandez-vous toujours : « Comment cela se comporte-t-il avec 1 000 utilisateurs ? 10 000 enregistrements ? 100 000 opérations ? » La différence entre des algorithmes O(n) et O(n²) peut être imperceptible en développement, mais catastrophique en production.
Schémas O(n²) courants à éviter :
-
Itérations imbriquées sur des tableaux (
.mapdans.map,.forEachdans.forEach) -
Méthodes de tableau comme
.some,.findou.filterà l’intérieur de boucles ou de callbacks -
Vérifier chaque élément contre chaque autre élément sans optimisation
-
Filtres en chaîne ou mappages imbriqués sur de grandes listes
Exemple concret : Pour 100 créneaux disponibles et 50 périodes occupées, un algorithme O(n²) effectue 5 000 vérifications. Portez cela à 500 créneaux et 200 périodes occupées, et vous faites 100 000 opérations. Cela représente une charge de calcul 20 fois plus élevée pour seulement 5 fois plus de données.
Choisissez les bons types de données et les bons algorithmes
La plupart des problèmes de performance se résolvent en choisissant de meilleurs types de données et de meilleurs algorithmes :
-
Tri + sortie anticipée : triez vos données une fois, puis sortez des boucles quand vous savez que les éléments restants ne correspondront pas
-
Recherche binaire : utilisez la recherche binaire pour les recherches dans des tableaux triés au lieu de parcours linéaires
-
Techniques à deux pointeurs : pour fusionner ou intersecter des séquences triées, parcourez-les avec des pointeurs au lieu de boucles imbriquées
-
Tables de hachage/ensembles : utilisez des objets ou des Sets pour des recherches en O(1) au lieu de
.findou.includessur des tableaux -
Arbres d’intervalles : pour la planification, la disponibilité et les requêtes de plage, utilisez des structures d’arbre adaptées au lieu de comparaisons en force brute
Exemple de transformation :
// Bad: O(n²) - checks every slot against every busy time
availableSlots.filter(slot => {
  return !busyTimes.some(busy => checkOverlap(slot, busy));
});

// Good: O(n log n) - sort once, break early
const sortedBusy = [...busyTimes].sort((a, b) => a.start - b.start);
availableSlots.filter(slot => {
  for (const busy of sortedBusy) {
    if (busy.start >= slot.end) break; // No more overlaps possible
    if (busy.end <= slot.start) continue; // This one doesn't overlap
    return false; // Overlap found
  }
  return true;
});
Contrôles automatisés des performances
Nous mettrons en place plusieurs couches de défense contre les régressions de performance :
Règles de linting qui signalent :
-
Les fonctions avec des boucles imbriquées ou des méthodes de tableau imbriquées
-
Plusieurs appels imbriqués à
.some,.findou.filter -
La récursion sans mémoïsation
-
Les anti-patterns connus pour notre domaine (planification, vérifications de disponibilité, etc.)
Benchmarks de performance dans CI qui :
-
Exécutent les algorithmes critiques sur des données réalistes à grande échelle
-
Comparent les temps d’exécution au point de référence à chaque PR
-
Bloquent les merges qui introduisent des régressions de performance
-
Testent avec des données à l’échelle enterprise (des milliers d’utilisateurs, des dizaines de milliers d’enregistrements)
Surveillance en production qui :
-
Suit le temps d’exécution des chemins critiques
-
Alerte lorsque les algorithmes ralentissent à mesure que les données grossissent
-
Détecte les régressions avant que les utilisateurs ne les remarquent
-
Fournit des données de performance réelles pour éclairer les optimisations
La performance est une fonctionnalité
La performance n’est pas facultative. Ce n’est pas quelque chose qu’on « fera plus tard ». Pour les clients enterprise qui réservent à travers de grandes équipes, des réponses lentes signifient une productivité perdue et des utilisateurs frustrés (notre expérience avec certains clients enterprise plus importants peut en témoigner).
Chaque ingénieur devrait :
-
Profiler votre code avant d’optimiser, mais pensez à la complexité dès le départ
-
Tester avec des données réalistes à grande échelle (pas seulement 5 enregistrements de test). Nous avons déjà des scripts de seed. Il faudra probablement les étendre.
-
Choisir dès le départ des algorithmes et des structures de données efficaces
-
Repérer les itérations imbriquées lors de la revue de code
-
Remettre en question tout algorithme dont la complexité croît avec le produit de deux variables
La réalité NP-difficile de la planification
Les problèmes de planification sont fondamentalement NP-difficiles. Cela signifie que lorsque le nombre de contraintes, de participants ou de créneaux augmente, la complexité de calcul peut exploser de façon exponentielle. La plupart des algorithmes de planification optimaux ont une complexité temporelle exponentielle dans le pire des cas, ce qui rend le choix de l’algorithme absolument crucial.
Implications concrètes :
-
Trouver l’heure de réunion optimale pour 10 personnes réparties sur 3 fuseaux horaires avec des contraintes de disponibilité individuelles est coûteux en calcul
-
L’ajout de la détection des conflits, des buffers et d’une multitude d’autres options amplifie le problème
-
De mauvais choix d’algorithmes qui fonctionnent très bien pour de petites équipes deviennent totalement inutilisables pour de grandes organisations
-
Ce qui prend des millisecondes pour 5 utilisateurs peut prendre de nombreuses secondes pour des organisations
Stratégies pour gérer la complexité NP-difficile :
-
Utiliser des algorithmes d’approximation qui trouvent rapidement des solutions « suffisamment bonnes » plutôt que de lentes solutions parfaites
-
Mettre en place une mise en cache agressive des plannings et des disponibilités calculés
-
Pré-calculer les scénarios courants pendant les heures creuses
-
Découper les grands problèmes de planification en sous-problèmes plus petits et plus faciles à gérer
-
Définir des limites de délai d’expiration raisonnables et revenir à des algorithmes plus simples lorsque c’est nécessaire
C’est pourquoi la performance n’est pas juste un plus dans les logiciels de planification. C’est la base qui détermine si votre système peut évoluer pour répondre aux besoins enterprise ou s’effondre sous les schémas d’utilisation réels.
Exigences de couverture de code
-
Suivi global de la couverture
- Nous suivons la couverture globale de la base de code comme un indicateur clé qui s’améliore au fil du temps. Cela nous donne de la visibilité sur notre maturité en matière de tests et nous aide à identifier les zones qui nécessitent de l’attention. Le pourcentage global de couverture est affiché bien en évidence dans nos tableaux de bord.
-
Couverture de 80 %+ pour le nouveau code
- Chaque PR doit avoir une couverture de tests proche de 80 %+ pour le code qu’elle introduit ou modifie. C’est appliqué automatiquement dans notre pipeline CI. Si vous ajoutez 50 lignes de nouveau code, ces 50 lignes doivent être couvertes par des tests. Si vous modifiez une fonction existante, vos changements doivent être testés. Il s’agit de la couverture globale des tests. La couverture des tests unitaires doit être proche de 100 %, surtout avec la possibilité de tirer parti de l’IA pour aider à les générer.
Répondre à l’argument « la couverture ne raconte pas toute l’histoire » : Oui, nous savons que la couverture ne garantit pas des tests parfaits. Nous savons qu’on peut écrire des tests sans intérêt qui couvrent chaque ligne mais ne testent rien de significatif. Nous savons que la couverture n’est qu’un indicateur parmi d’autres. Mais il vaut sûrement mieux viser un pourcentage élevé que de n’avoir aucune idée de votre position.
Mesurer le succès
-
« Vélocité » (emprunté à Scrum même si nous n’utiliserons pas Scrum)
- Croissance continue des statistiques mensuelles (fonctionnalités, améliorations, refactorings)
-
Qualité
- Réduire d’ici fin 2026 l’effort de PR consacré aux correctifs, de 35 % actuellement à 20 % ou moins (calculé à partir des changements de fichiers et des ajouts/suppressions)
-
Santé architecturale
- Indicateurs sur le respect des patterns, le couplage technologique, les violations de frontière
-
Efficacité de la revue
- PR plus petites, revues plus rapides, moins de tours de feedback
-
Disponibilité de l’application et de l’API
- À quel point sommes-nous proches de 99,99 % ?