Cal.com Cold Start Resolution
Samenvatten met AI
Achtergrond
De Cal.com-app kon enige tijd last hebben van lange cold start-laadtijden, variërend van 7 seconden tot 30 seconden in extreme gevallen. Dit gedrag deed zich niet altijd voor vanwege het karakter van cold starts, maar het kwam vaak genoeg voor dat het een probleem werd dat we zo snel mogelijk moesten aanpakken.
Voor wie niet bekend is met cold starts: er is genoeg materiaal te vinden dat het probleem in het algemeen uitlegt, dus daar gaan we hier niet op in. Met deze blog willen we juist de exacte hoofdoorzaak uitleggen die specifiek ons systeem trof, en die werd veroorzaakt door cold starts in een serverless omgeving.
Bevindingen en experimenten
Laten we eerst eens naar de volgende log van Vercel kijken:
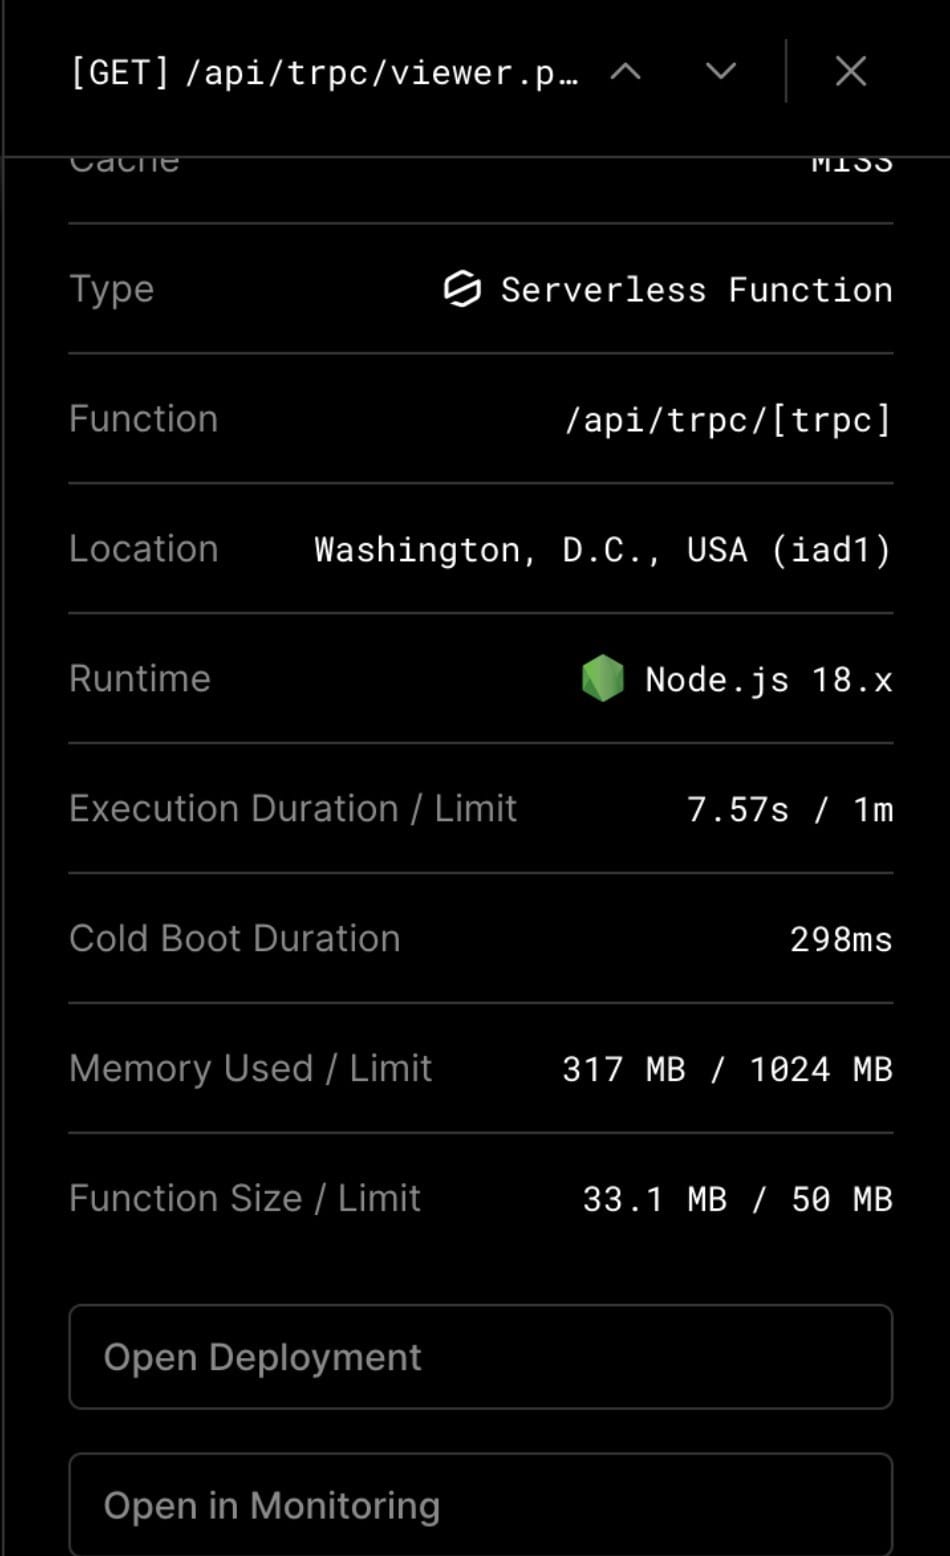
Voor de functie /api/trpc/[trpc] zien we een Cold Boot Duration van 298ms maar een Execution Duration van 7.57s. Dat is een beetje vreemd, toch? De cold boot zelf is niet het probleem, maar wat er tijdens de cold boot wordt geladen zorgt ervoor dat de Execution Duration flink oploopt.
Dus waar beginnen we om de hoofdoorzaak te vinden?
Hypothese 1: Functiebundelgrootte
Na het zien van de Function Size van 33.1 MB doken ons team, de community en de mensen van Vercel en Prisma er direct in en begonnen ze bundelanalyses en compilatielogs om te proberen te vinden welke pakketten onze functies zwaarder maakten. Ook al ligt deze Function Size onder de limiet van 50MB, we dachten dat die toch minstens gedeeltelijk de boosdoener kon zijn.
We identificeerden inderdaad een paar grote dependencies die werden geladen als onderdeel van onze sessie-opvraag en die konden worden verkleind (PR), en we laadden onze app store-dependencies lazy (PR).
De prestaties verbeterden bij elke request na deze updates, maar het was niet de vermindering van meerdere seconden waar we op hoopten. Dus wat kon het nog meer zijn? Is Prisma traag met verbinden bij een cold start in onze serverless setup?
Hypothese 2: Prisma
We hadden al Prisma Data Proxy in productie draaien om onze connection pooling af te handelen, dus we waren sceptisch dat dat het probleem was, maar we wilden het alsnog zorgvuldig uitzoeken om ons daarvan te overtuigen.
In een experimentele branch zetten we een test-endpoint op, los van onze API-routes en pagina's, in een aparte app-route (met de nieuwe App Router van Next.js) die alleen het aantal gebruikers in het systeem ophaalde. De prestaties van deze route bij cold starts konden oplopen tot 1 seconde, wat ons liet zien dat Prisma bij cold starts een kleine vertraging kan hebben, maar opnieuw: het was niet de 7-15 seconden die we gemiddeld zagen.
Hypothese 3: _app en _document
Uit de bundle-analyse die was uitgevoerd, werd duidelijk dat onze app heel veel dependencies laadt. Dat bracht het idee op om te verminderen wat er bij elke API-request wordt geladen. Omdat we wisten dat API-routes in Next.js het bestand _app.tsx laden, besloten we een PageWrapper te implementeren die alle dependencies bevat die nodig zijn voor niet-API-routes (PR).
Nogmaals, dit is een mooie verbetering qua dependency-optimalisatie, maar we hadden nog steeds die lange wachttijden.
Hoofdoorzaak
Na het uitbrengen van een reeks perf-specifieke PR's die hielpen met code-structuur, snelheid en bundelgrootte, hadden we nog steeds niet de gouden oplossing gevonden. Het was tijd om weer terug te komen op het uitgangspunt en te denken in termen van bottlenecks, want veel prestatieproblemen hangen samen met bottlenecks, toch?
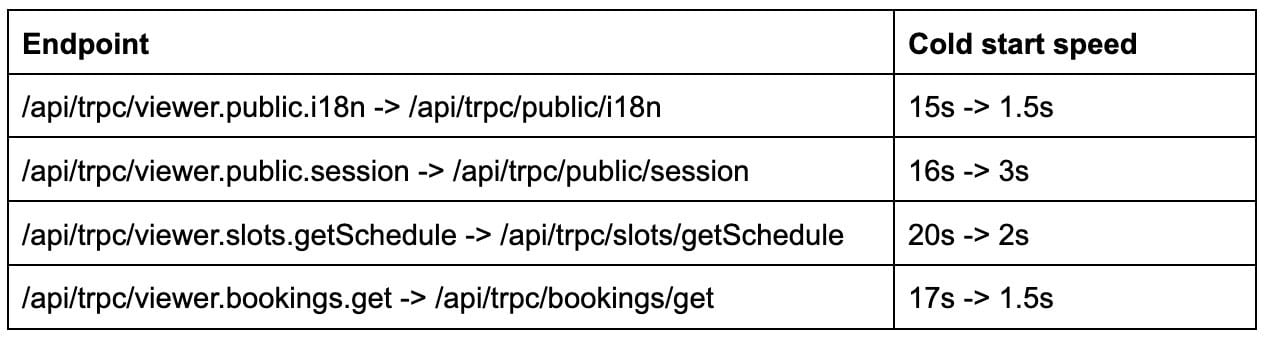
Met die gedachte werd een test uitgevoerd om de eenvoudigste tRPC-router in een eigen API-route onder te brengen. Voor ons was dat onze public router. Na de deployment was het endpoint /api/trpc/viewer.public.i18n nu /api/trpc/public/i18n. We zagen dat de cold start-tijd voor deze route daalde van 15 seconden naar 2 seconden. Dit leek te bevestigen dat onze enkele tRPC-router inderdaad de bottleneck was.
Kort gezegd hadden we te veel tRPC-routers in de hoofd-viewer-router die werd aangeboden op de route /api/trpc/[trpc]. Dat betekende dat de allereerste aanroep van deze functie, of die nu i18n-termen moest laden of het schema van een gebruiker moest ophalen, alle 20 routers en al hun dependencies moest importeren.
Zoals hier te zien is in wat uiteindelijk de PR was die de meeste van onze langdurige cold start-problemen oploste, was er het vermoeden dat de slots-router te groot was en de bron van de problemen vormde. Helaas zagen we, nadat we de slots-router had opgesplitst in een eigen Next.js API-route, nog steeds grote bundelgroottes en lange cold start-tijden. Daarom bleef deze PR onaangeroerd terwijl we andere hypothesen onderzochten.
Nadat bleek dat de i18n-route bij cold starts in 2 seconden laadde, is de eerder genoemde PR verder uitgebreid zodat alle tRPC-routers hun eigen API-route kregen. Bij het opsplitsen maakt Vercel aparte functies per route aan.
Dus waarom lost het opsplitsen van de tRPC-routers in hun eigen Next.js API-routes het probleem op? Het simpele antwoord, in ons geval, is dat zelfs als een pagina 5 verschillende tRPC-routes aanroept om data te laden, die parallel worden uitgevoerd en daardoor het effect van het laden van dependencies voor alle routers niet wordt opgestapeld. We zien nu nog steeds cold start-tijden van 2-3 seconden op een willekeurige tRPC-route, maar omdat ze parallel door de browser worden aangeroepen, kan de totale wachttijd 3 seconden zijn, niet 7-15 seconden (of 30 seconden in extreme gevallen).
We erkennen dat er nog meer werk nodig is om deze snelheden verder te verlagen, maar de verlagingen tot nu toe zijn aanzienlijk geweest.
Hier is een issue om mogelijke wijzigingen voor tRPC in serverless omgevingen te stimuleren.
Belangrijkste resultaten
Huldebetuigingen
Een grote shoutout en dank aan iedereen die heeft bijgedragen aan het oplossen van dit probleem. Van het schrijven van aangepaste scripts die hielpen bepalen welke dependencies ons systeem vertraagden tot het openen van PR's, we waarderen de steun en moeite enorm die in het oplossen van deze problemen is gestoken. We hopen dat deze blog en de PR's wat inzicht kunnen geven in de experimenten die we hebben uitgevoerd en de hoofdoorzaak die we uiteindelijk hebben gevonden.
Speciale dank aan Julius Marminge van tRPC.io, Guillermo Rauch, Malte Ubl en Jimmy Lai van Vercel en Lucas Smith. 🙏
Wat nu
Hoewel dit een enorme mijlpaal is, werken we nog steeds hard om cold starts nog verder te verlagen, maar ook om de self-hosting-ervaring zonder serverless architectuur te verbeteren. Blijf op de hoogte!