Trovare e risolvere i colli di bottiglia delle prestazioni O(n²): lezioni dalle ottimizzazioni degli algoritmi di Cal.com
Un’analisi approfondita di come abbiamo rilevato, analizzato e ottimizzato algoritmi poco performanti in una codebase reale in produzione.
On this page
- Introduzione
- Il problema: come un codice innocente diventa O(n²)
- Caso di studio 1: ottimizzazione del controllo dei conflitti tra slot
- Il problema originale
- Implementazione originale: cicli annidati O(n²)
- Implementazione ottimizzata: O(n log n) con ordinamento e uscita anticipata
- Caso di studio 2: intersezione di intervalli di date usando la tecnica dei due puntatori
- Il problema originale
- Implementazione originale: mapping annidato O(n²)
- Implementazione ottimizzata: O(n log n) con traversamento a due puntatori
- Caso di studio 3: interval tree per il filtraggio di intervalli ridondanti
- Il problema originale
- Implementazione originale: controllo di contenimento O(n²)
- Implementazione ottimizzata: O(n log n) con un interval tree
- Risultati sulle prestazioni: prima e dopo
- Tecniche semplici per rilevare algoritmi O(n²)
- Riconosci i pattern problematici
- Verifica esplicitamente la scalabilità
- Automatizza l’analisi statica
- Strategie collaudate per sostituire codice O(n²)
- Automatizzare i controlli sulle prestazioni
- Punti chiave
- Conclusione
Introduzione
I colli di bottiglia delle prestazioni nei sistemi di scheduling possono fare la differenza tra un’esperienza utente reattiva e utenti che abbandonano la tua piattaforma per frustrazione. In Cal.com abbiamo recentemente scoperto e ottimizzato diversi algoritmi critici O(n²) che causavano rallentamenti man mano che la nostra base utenti e i volumi di dati crescevano.
In questo articolo condividerò quattro ottimizzazioni reali di algoritmi dalla codebase di Cal.com. Imparerai come abbiamo rilevato la complessità O(n²), quali strategie di ottimizzazione hanno funzionato meglio e come abbiamo introdotto controlli automatici per prevenire future regressioni.
Il problema: come un codice innocente diventa O(n²)
Quando le piattaforme di scheduling crescono, è sorprendentemente facile che cicli annidati apparentemente innocui diventino killer silenziosi delle prestazioni. Considera questo esempio reale dalla nostra codebase:
// O(n²): Every available slot is checked against every busy period
availableTimeSlots.map(slot => {
  return busy.some(busyTime => checkOverlap(slot, busyTime));
});
Per 100 slot e 50 periodi occupati, sono 5.000 controlli di sovrapposizione. Su scala maggiore—500 slot e 200 periodi occupati—si arriva a 100.000 operazioni. È un aumento di venti volte del carico computazionale per un aumento di soli cinque volte dei dati.
Caso di studio 1: ottimizzazione del controllo dei conflitti tra slot
Il problema originale
La funzione checkForConflicts usava iterazioni annidate per verificare se gli slot di prenotazione entravano in conflitto con i periodi occupati. Questo è rapidamente diventato un problema di prestazioni con calendari grandi.
Implementazione originale: cicli annidati O(n²)
function checkForConflicts({ busy, time, eventLength }) {
  return busy.some(busyTime => {
    const slotStart = time.valueOf();
    const slotEnd = slotStart + eventLength * 60 * 1000;
    const busyStart = dayjs.utc(busyTime.start).valueOf();
    const busyEnd = dayjs.utc(busyTime.end).valueOf();
    return !(busyEnd <= slotStart || busyStart >= slotEnd);
  });
}

availableTimeSlots = availableTimeSlots
  .map((slot) => {
    if (
      !checkForConflicts({
        time: slot.time,
        busy: busySlotsFromReservedSlots,
        ...availabilityCheckProps,
      })
    ) {
      return slot;
    }
    return undefined;
  })
Implementazione ottimizzata: O(n log n) con ordinamento e uscita anticipata
function checkForConflicts({ sortedBusyTimes, time, eventLength }) {
  const slotStart = time.valueOf();
  const slotEnd = slotStart + eventLength * 60 * 1000;

  for (const busyTime of sortedBusyTimes) {
    if (busyTime.start >= slotEnd) {
      break;
    }
    if (busyTime.end <= slotStart) {
      continue;
    }
    return true;
  }
  return false;
}
Cosa è cambiato:
Abbiamo ordinato gli orari occupati in base all’ora di inizio, il che ci ha permesso di saltare i periodi non sovrapposti e di uscire in anticipo quando non era possibile alcun conflitto. Il risultato è stato un calo drastico del numero di confronti inutili.
Impatto:
La complessità è scesa da O(slot disponibili × periodi occupati) a O(n log n), e nella maggior parte dei casi i controlli sono stati saltati del tutto.
Caso di studio 2: intersezione di intervalli di date usando la tecnica dei due puntatori
Il problema originale
La funzione intersect in precedenza usava cicli annidati per trovare sovrapposizioni tra la disponibilità di più utenti.
Implementazione originale: mapping annidato O(n²)
commonAvailability.forEach(commonRange => {
  userRanges.forEach(userRange => {
    const intersection = getIntersection(commonRange, userRange);
    if (intersection !== null) {
      intersectedRanges.push(intersection);
    }
  });
});
Implementazione ottimizzata: O(n log n) con traversamento a due puntatori
const sortedRanges = ranges.map(userRanges =>
  userRanges
    .map(r => ({
      ...r,
      startValue: r.start.valueOf(),
      endValue: r.end.valueOf()
    }))
    .sort((a, b) => a.startValue - b.startValue)
);

let commonIndex = 0;
let userIndex = 0;

while (commonIndex < commonAvailability.length && userIndex < userRanges.length) {
  const commonRange = commonAvailability[commonIndex];
  const userRange = userRanges[userIndex];

  const intersectStartValue = Math.max(commonRange.startValue, userRange.startValue);
  const intersectEndValue = Math.min(commonRange.endValue, userRange.endValue);

  if (intersectStartValue < intersectEndValue) {
    intersectedRanges.push(createIntersection(commonRange, userRange));
  }

  if (commonRange.endValue <= userRange.endValue) {
    commonIndex++;
  } else {
    userIndex++;
  }
}
Cosa è cambiato:
Ordinando e usando due puntatori per scorrere gli intervalli, abbiamo eliminato la necessità di iterazioni annidate. Questo ha ridotto la complessità da quadratica a quasi lineare per la maggior parte degli input pratici.
Caso di studio 3: interval tree per il filtraggio di intervalli ridondanti
Il problema originale
La funzione filterRedundantDateRanges confrontava ogni intervallo con tutti gli altri per vedere se uno contenesse l’altro. Per calendari grandi, questo diventava dolorosamente lento.
Implementazione originale: controllo di contenimento O(n²)
return dateRanges.filter((range, index) => {
  return !dateRanges.some((otherRange, otherIndex) => {
    if (index === otherIndex) return false;
    return isCompletelyContained(range, otherRange);
  });
});
Implementazione ottimizzata: O(n log n) con un interval tree
export function filterRedundantDateRanges(dateRanges) {
  const sortedRanges = [...dateRanges].sort((a, b) => a.start.valueOf() - b.start.valueOf());
  const intervalNodes = createIntervalNodes(
    sortedRanges,
    (range) => range.start.valueOf(),
    (range) => range.end.valueOf()
  );
  const intervalTree = new IntervalTree(intervalNodes);
  const searchAlgorithm = new ContainmentSearchAlgorithm(intervalTree);

  return sortedRanges.filter((range, index) => {
    const containingIntervals = searchAlgorithm.findContainingIntervals(
      range.start.valueOf(),
      range.end.valueOf(),
      index
    );
    return containingIntervals.length === 0;
  });
}
Cosa è cambiato:
Invece di un confronto forza bruta, abbiamo usato una struttura a interval tree per consentire rapide query di contenimento O(log n). È un approccio classico della geometria computazionale che funziona benissimo per le applicazioni di scheduling.
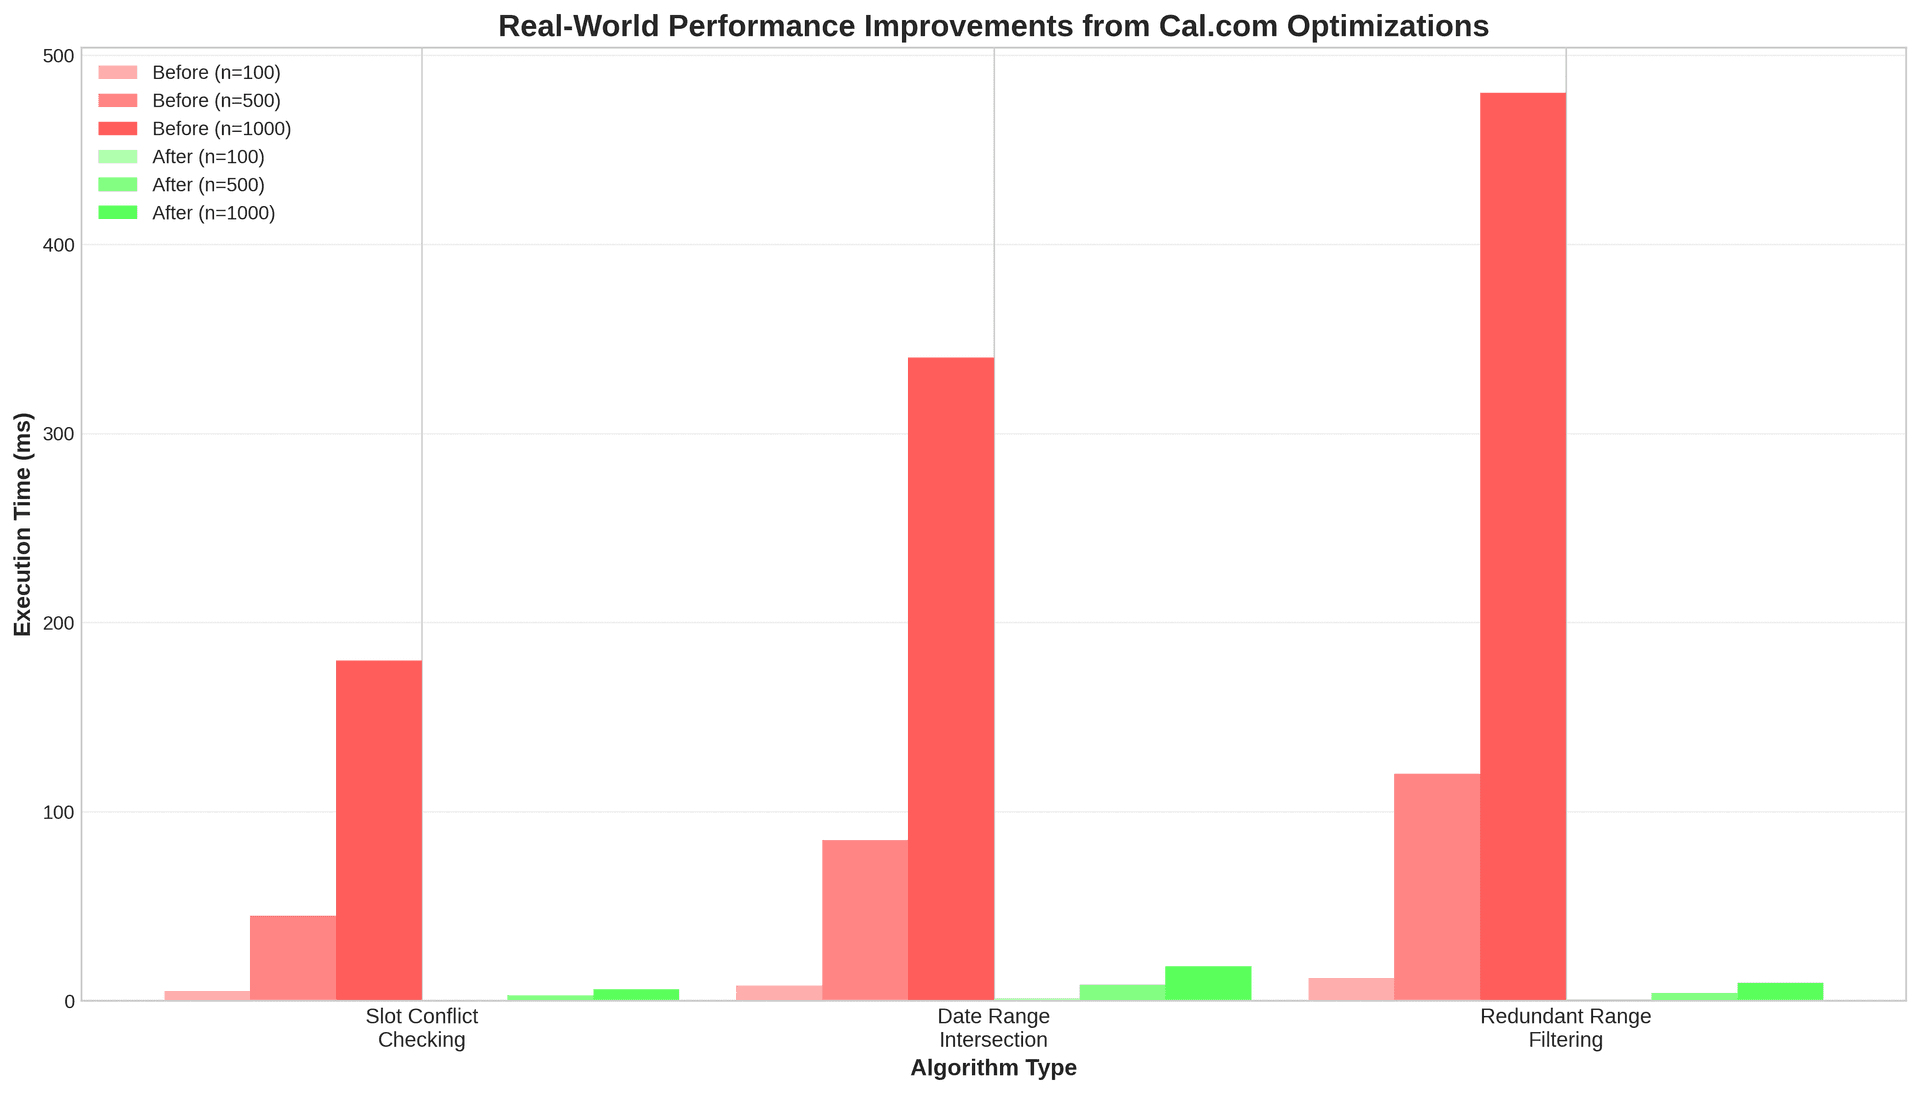
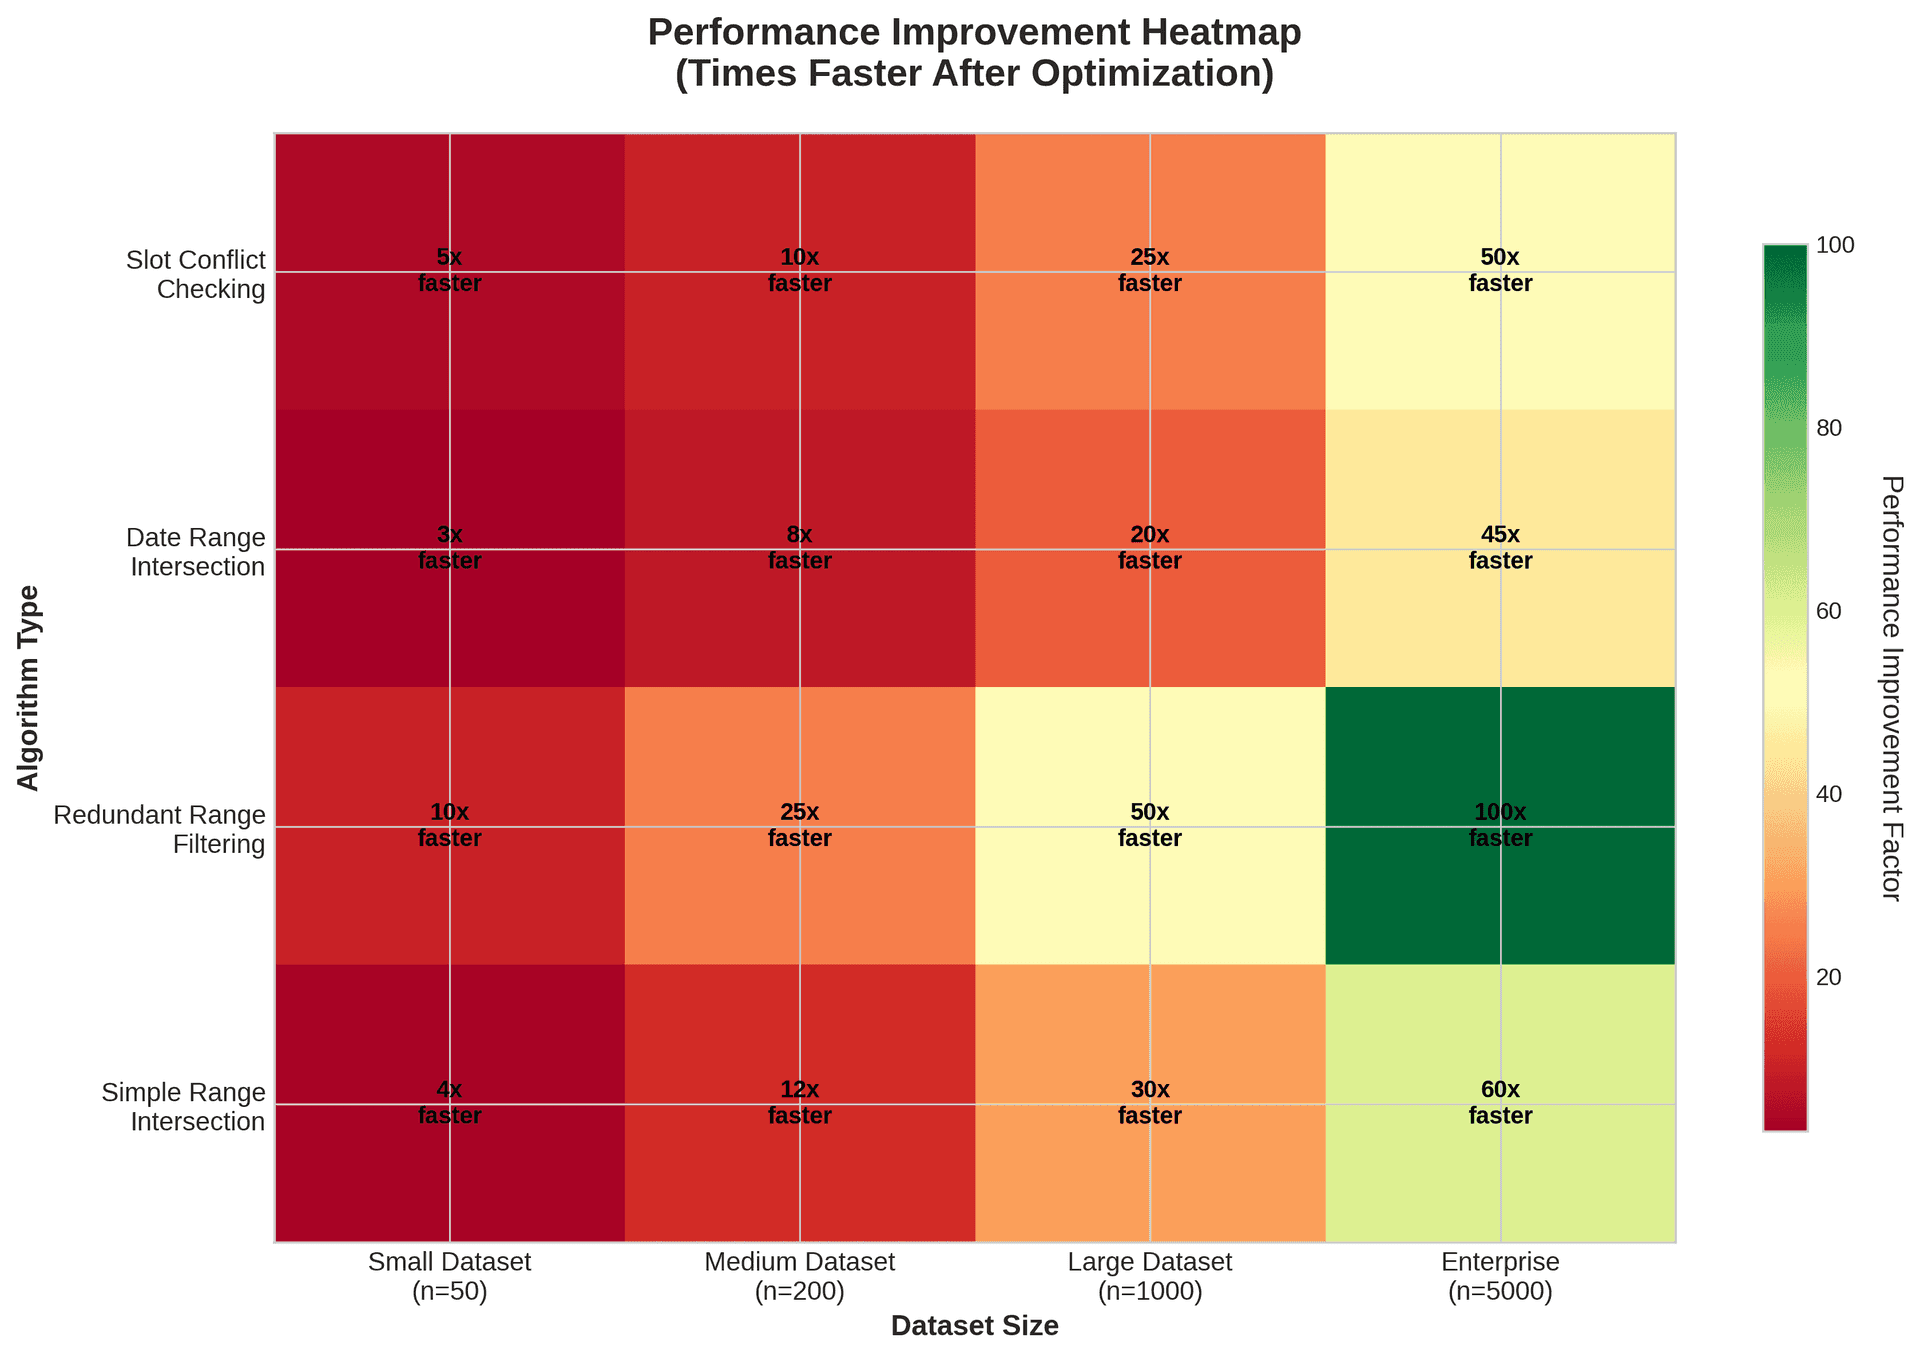
Risultati sulle prestazioni: prima e dopo
I nostri benchmark hanno mostrato miglioramenti significativi:
-
Controllo dei conflitti tra slot: ridotto da O(n²) a O(n log n), rendendo 100 slot e 50 periodi occupati circa dieci volte più veloci.
-
Intersezione di intervalli di date: scesa da O(n²) a O(n log n), consentendo di elaborare centinaia di intervalli di date in millisecondi.
-
Filtraggio di intervalli ridondanti: ridotto da O(n²) a O(n log n), con fino a un aumento di velocità di cinquanta volte per migliaia di intervalli di date.
-
Intersezione generale di intervalli: su molti pattern, abbiamo visto miglioramenti di venticinque volte o più.
Tecniche semplici per rilevare algoritmi O(n²)
Riconosci i pattern problematici
Fai attenzione a:
-
Iterazioni annidate sugli array, soprattutto
.map,.forEach,.filterdentro un altro. -
Metodi di array come
.some,.findo.filterdentro cicli o callback di array. -
Filtri concatenati o mapping annidato su liste grandi.
Verifica esplicitamente la scalabilità
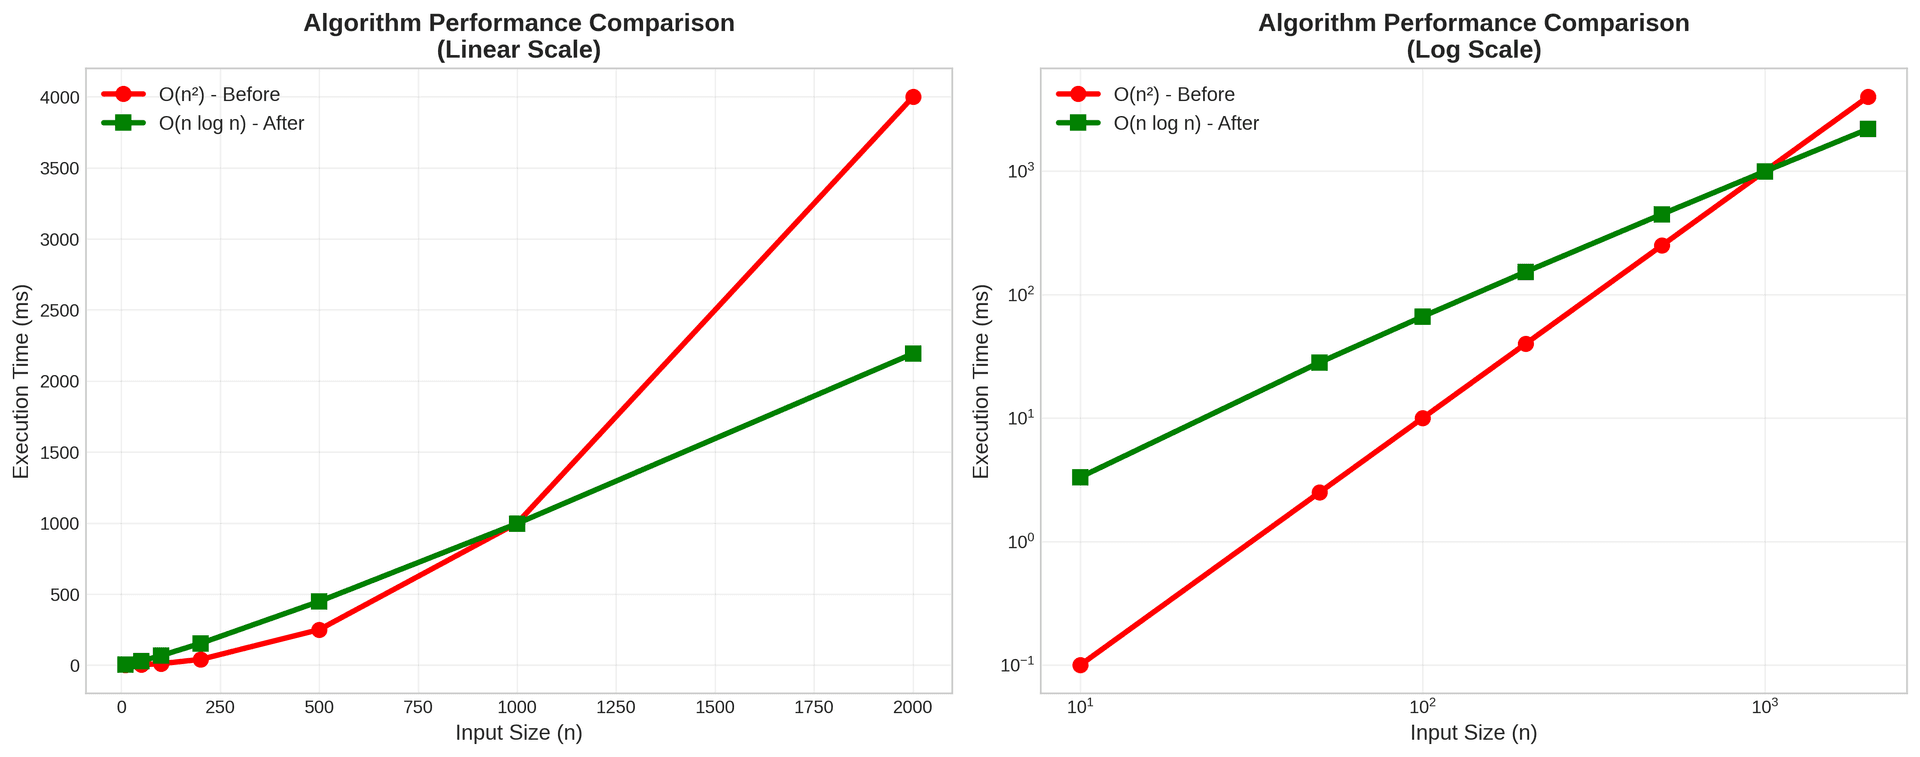
Scrivi test di performance che eseguano la tua funzione su dati di dimensioni crescenti e registrino i tempi di esecuzione. Se il tempo cresce quadraticamente con la dimensione dei dati, hai un problema O(n²).
Automatizza l’analisi statica
Aggiungi regole di lint o analisi statica che:
-
Segnalano funzioni con cicli annidati o metodi di array annidati.
-
Identificano ricorsione senza memoization.
-
Rilevano funzioni con chiamate multiple annidate a
.some,.findo.filter.
Strategie collaudate per sostituire codice O(n²)
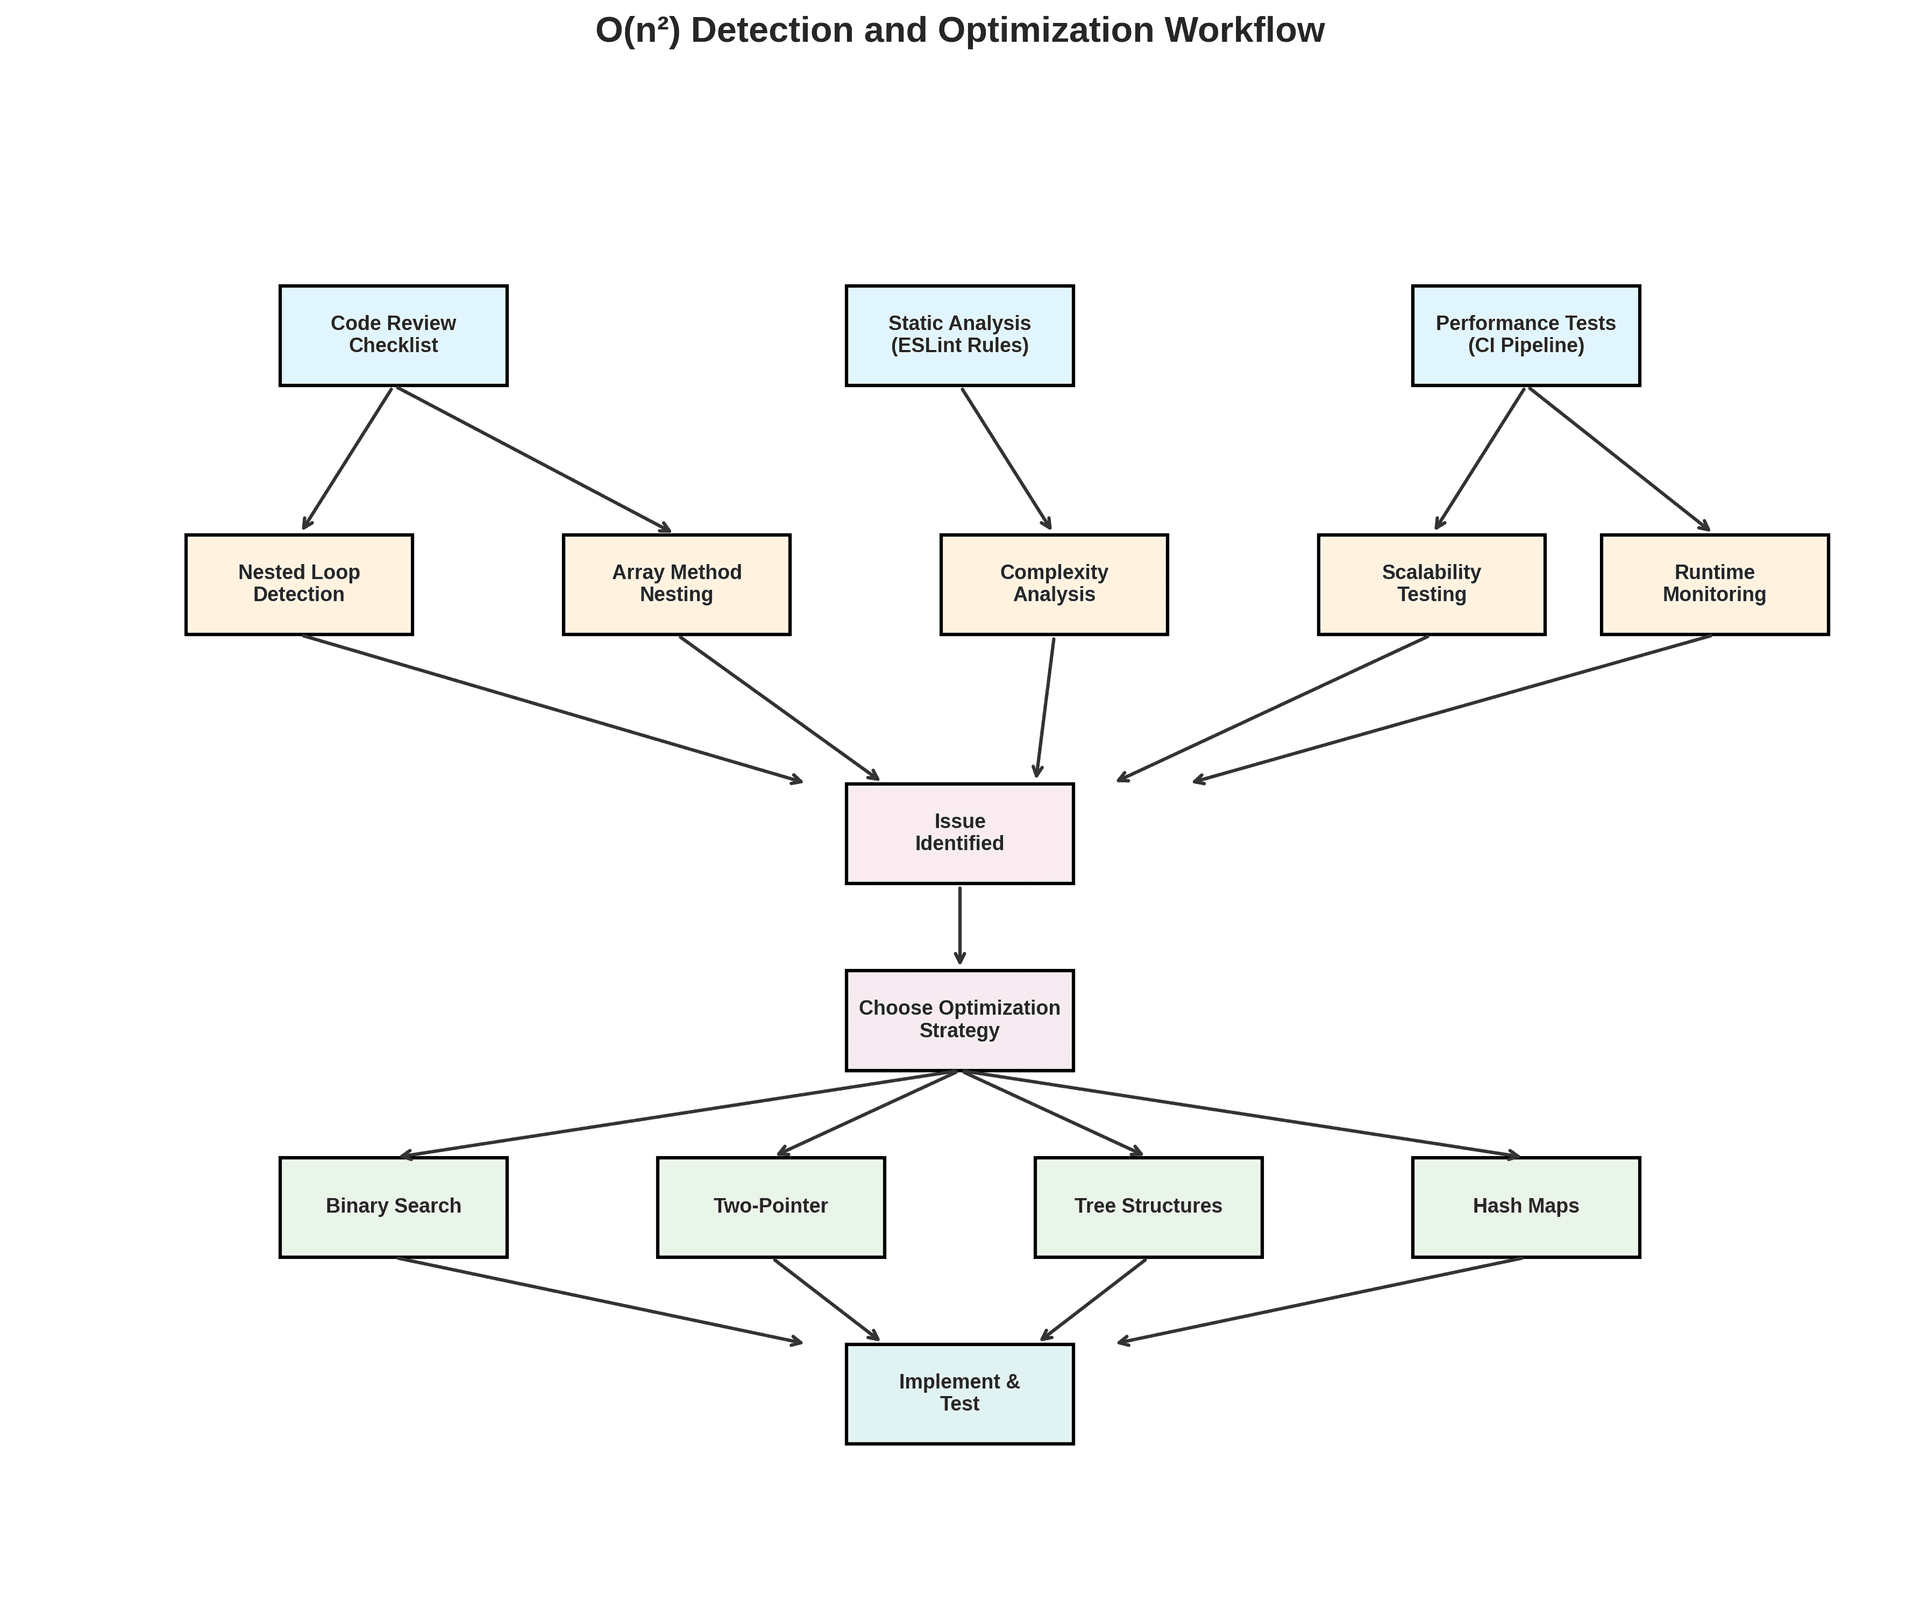
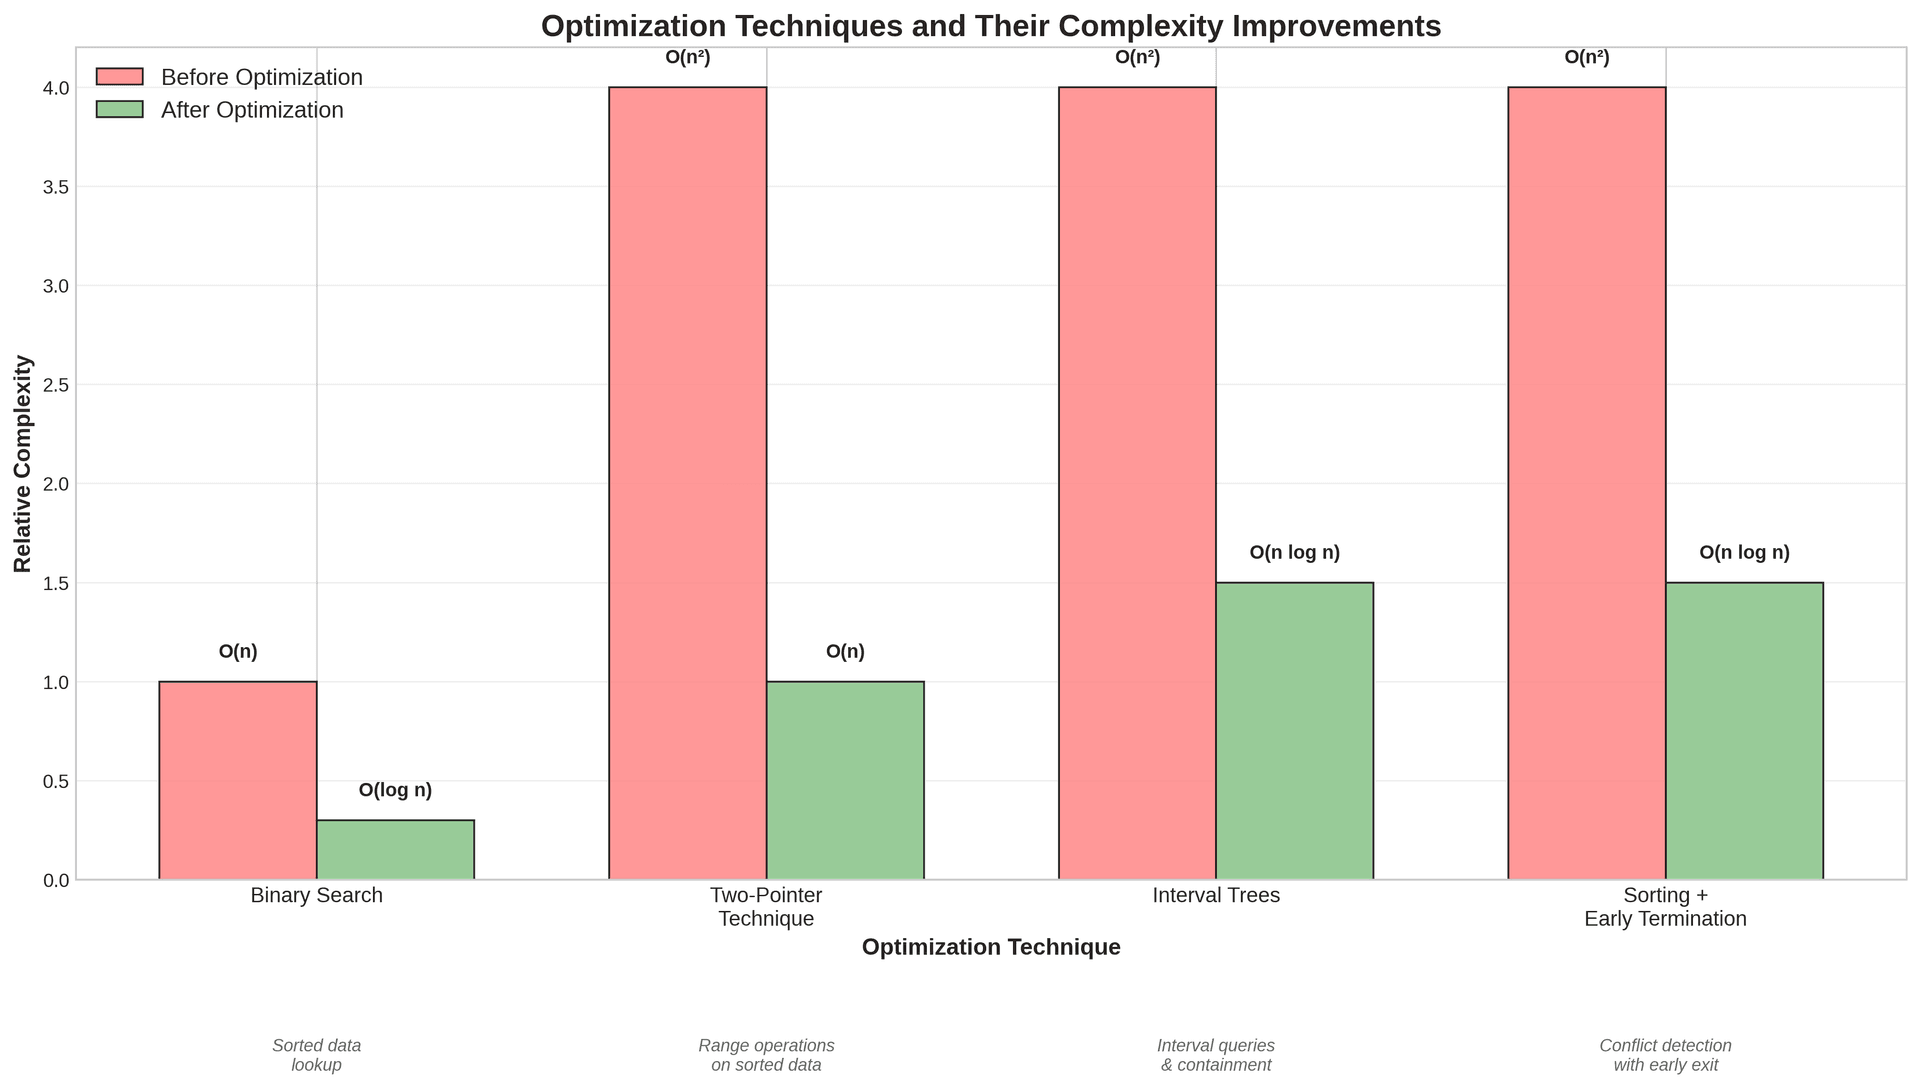
-
Usa la ricerca binaria per le ricerche in array ordinati.
-
Usa tecniche a due puntatori per unire o intersecare sequenze ordinate.
-
Usa strutture dati basate su alberi per query su intervalli o dati gerarchici.
Automatizzare i controlli sulle prestazioni
Aggiungi benchmark di performance alla tua pipeline CI che eseguano gli algoritmi critici su dati realistici. Confronta i tempi di esecuzione a ogni pull request e blocca le merge che introducono regressioni. Aggiungi regole di lint personalizzate per impedire che pattern O(n²) evidenti arrivino in produzione. Implementa il monitoraggio runtime per i percorsi critici, così da intercettare nuove regressioni prima che gli utenti se ne accorgano.
Punti chiave
-
Prevenire è sempre meglio che curare. I controlli automatici intercetteranno gli algoritmi O(n²) prima che causino problemi.
-
Fai sempre il profiling prima di ottimizzare. Usa i test per trovare i veri colli di bottiglia.
-
Scegli le strutture dati giuste per le tue esigenze. Array ordinati, approcci a due puntatori e alberi sono preziosissimi.
-
Testa con dati realistici e su larga scala. I test piccoli possono nascondere grossi problemi.
-
Monitora in produzione. Gli alert automatici possono intercettare le regressioni in anticipo.
Conclusione
Le ottimizzazioni che abbiamo fatto in Cal.com mostrano che sono possibili miglioramenti significativi delle prestazioni applicando tecniche algoritmiche collaudate. Combina code review, strutture dati intelligenti e monitoraggio automatico per mantenere la tua applicazione veloce man mano che scala.
Le prestazioni dovrebbero essere integrate in ogni fase dello sviluppo, dalle code review che segnalano pattern sospetti alle pipeline CI che eseguono test di scalabilità e al monitoraggio runtime che rileva le regressioni.
Un algoritmo veloce oggi può facilmente diventare il collo di bottiglia di domani mentre i tuoi dati crescono. Resta vigile, testa su larga scala e preparati sempre a ottimizzare.