Engineering nel 2026 e oltre
Stiamo costruendo un’infrastruttura che non deve quasi mai fallire. Per riuscirci, ci muoviamo velocemente, rilasciando software di qualità straordinaria senza scorciatoie né compromessi. Questo documento delinea gli standard di engineering che ci guideranno nel 2026 e oltre.
On this page
- Struttura del team
- I nostri risultati finora
- La base di Cal.com abilita l’eccellenza per coss.com
- Principi fondamentali
- 1. Nessuna qualità rimandata
- 2. Standard elevati nella code review
- 3. Spingiamoci a vicenda a fare la cosa giusta
- 4. Punta alla semplicità
- 5. Automatizza tutto
- Standard architetturali
- Vertical Slice Architecture: packages/features
- Perché le slice verticali sono importanti
- Linee guida per l'organizzazione delle funzionalità
- Benefici
- Repository Pattern e Dependency Injection
- Data Transfer Objects (DTOs)
- Pattern di Domain-Driven Design
- Coerenza della codebase
- Sposta le condizioni nel punto di ingresso dell'applicazione
- Perché conta
- Come riuscirci
- Progettazione API: controller sottili e astrazione HTTP
- Versionamento API e breaking change
- Performance e complessità algoritmica
- Pensa alla scala fin dal primo giorno
- Scegli le giuste strutture dati e algoritmi
- Controlli automatici delle performance
- La performance è una funzionalità
- La realtà NP-Hard della pianificazione
- Requisiti di copertura del codice
- Misurare il successo
Struttura del team
La nostra organizzazione engineering è composta da cinque team fondamentali, ognuno con responsabilità distinte:
-
Foundation Team: si concentra sulla definizione e manutenzione degli standard di codice e dei pattern architetturali. Questo team lavora in collaborazione con gli altri team per stabilire le best practice in tutta l’organizzazione.
-
Consumer, Enterprise e Platform Teams: team focalizzati sul prodotto che rilasciano funzionalità rapidamente mantenendo gli standard di qualità definiti in questo documento. Questi team dimostrano che velocità e qualità non si escludono a vicenda.
-
Community Team: responsabile della revisione rapida delle PR provenienti dalla community open source, fornendo feedback e seguendo quel lavoro fino al merge. Questo team garantisce che i nostri contributor open source abbiano un’ottima esperienza e che i loro contributi rispettino i nostri standard di qualità. Mantenere una forte cultura open-source continua a plasmare il modo in cui Cal.com affronta la collaborazione engineering e lo sviluppo del prodotto.
I nostri risultati finora
I dati parlano da soli. Nell’ultimo anno e mezzo abbiamo trasformato in modo fondamentale il modo in cui costruiamo software:

Abbiamo all’incirca raddoppiato la nostra produttività engineering migliorando allo stesso tempo la qualità. Ancora più impressionante è il cambiamento in ciò che stiamo costruendo:

Abbiamo riassegnato con successo circa il 20% dello sforzo engineering lontano dalle correzioni e verso funzionalità, miglioramenti di performance, refactor e attività operative. Questo cambiamento dimostra che investire in qualità e architettura non ti rallenta. Ti accelera.
La base di Cal.com abilita l’eccellenza per coss.com
-
Cal.com è un business stabile e profittevole che continueremo a far crescere.
- Questo successo ci dà un vantaggio unico mentre costruiamo coss.com. A differenza dei primi giorni di Cal.com, quando dovevamo muoverci rapidamente per trovare il product-market fit e costruire un business sostenibile, coss.com parte da una posizione di forza.
-
Non dobbiamo avere fretta con coss.com.
- La stabilità di Cal.com significa che possiamo permetterci di costruire coss.com nel modo giusto fin dal primo giorno. Abbiamo il lusso di implementare questi standard engineering senza la pressione delle esigenze immediate del mercato o dei vincoli di finanziamento. Questa è una posizione di partenza fondamentalmente diversa.
-
La "lentezza" è un investimento, non un costo.
- Sì, seguire questi standard può sembrare inizialmente più lento e potrebbe persino risultare frustrante per alcuni engineer. Scrivere DTO richiede più tempo che passare direttamente i tipi del database al frontend. Creare astrazioni adeguate e dependency injection richiede più progettazione iniziale. Mantenere una copertura test dell’80%+ per il nuovo codice richiede disciplina. Ma questa apparente lentezza è temporanea e il ritorno è esponenziale.
Considera i ritorni composti...
-
Il codice progettato correttamente fin dall’inizio non ha bisogno di grossi refactor in seguito
-
Un’elevata copertura dei test previene bug che altrimenti consumerebbero settimane di debugging e hotfix (vedi 2023 fino a metà 2024)
-
Le astrazioni corrette rendono l’aggiunta di nuove funzionalità drasticamente più veloce nel tempo
-
Confini puliti e DTO impediscono l’erosione architetturale che alla fine richiede riscritture complete
La Cal.com traiettoria mostra cosa succede quando ottimizzi per la velocità immediata. Alta velocità iniziale che si degrada gradualmente man mano che si accumula debito tecnico, le scorciatoie architetturali creano colli di bottiglia e si passa sempre più tempo a risolvere problemi invece che a costruire funzionalità (vedi il grafico precedente in cui spendevamo il 55-60% dello sforzo engineering in correzioni).
La traiettoria di coss.com abbraccerà la potenza di costruire bene fin dal primo giorno. Velocità iniziale leggermente più bassa mentre si definiscono i pattern corretti, seguita da un’accelerazione esponenziale man mano che quei pattern danno frutti e consentono uno sviluppo più rapido e con maggiore fiducia.
Principi fondamentali
1. Nessuna qualità rimandata
-
Ridurremo al minimo il "lo faccio in una PR di follow-up" per i piccoli refactor.
- Le PR di follow-up per piccoli miglioramenti raramente si concretizzano. Invece, si accumulano come debito tecnico che ci pesa addosso mesi o anni dopo. Se un piccolo refactor può essere fatto ora, fallo ora. Le follow-up dovrebbero essere riservate a cambiamenti sostanziali che meritano davvero PR separate o a casi eccezionali e urgenti.
2. Standard elevati nella code review
-
Non far passare PR con una lunga lista di nitpick solo per evitare di essere "quella cattiva".
- È esattamente così che i codebase diventano trascurati nel tempo. La code review non serve a essere gentili. Serve a mantenere gli standard di qualità richiesti dalla nostra infrastruttura. Ogni dettaglio conta. Ogni violazione di pattern conta. Risolvili prima del merge, non dopo.
3. Spingiamoci a vicenda a fare la cosa giusta
-
Ci rendiamo reciprocamente responsabili della qualità
- Prendere scorciatoie può sembrare più veloce nell’immediato, ma crea problemi che rallentano tutti più avanti. Quando vedi un teammate pronto a fare merge di una PR con problemi evidenti, intervieni. Quando qualcuno propone un hack veloce invece della soluzione corretta, fai opposizione. Quando sei tentato di saltare i test o ignorare i pattern architetturali, aspettati che i tuoi teammate ti contestino.
-
Non si tratta di essere difficili o di rallentare le persone
- Si tratta di ownership collettiva del nostro codebase e della nostra reputazione. Ogni scorciatoia presa da una persona diventa un problema di tutti. Ogni taglio agli angoli di oggi significa più sessioni di debugging, più hotfix e più clienti frustrati domani.
-
Rendi normale contestare le decisioni sbagliate, con rispetto
- Se qualcuno dice "facciamolo hard-coded per ora", la risposta attesa dovrebbe essere "cosa servirebbe per farlo nel modo giusto subito?" Se qualcuno vuole commitare codice non testato, il team dovrebbe opporsi. Se qualcuno propone di copiare e incollare invece di creare un’astrazione corretta, chiamalo fuori con rispetto.
-
Stiamo costruendo qualcosa che deve quasi mai fallire
- Quel livello di affidabilità non succede per caso. Succede quando ogni engineer si sente responsabile della qualità, non solo del proprio codice ma dell’intero sistema. Vinciamo come team oppure falliamo come team.
4. Punta alla semplicità
-
Dai priorità alla chiarezza invece che all’astuzia
- L’obiettivo è un codice facile da leggere e capire rapidamente, non una complessità elegante. Sistemi semplici riducono il carico cognitivo per ogni engineer.
-
Fatti le domande giuste
-
Sto davvero risolvendo il problema che ho davanti?
-
Sto pensando troppo a possibili casi d’uso futuri?
-
Ho considerato almeno 1 altra alternativa per risolvere questo problema? Come si confronta?
-
-
Semplice non significa privo di funzionalità
- Solo perché il nostro obiettivo è creare sistemi semplici, non significa che debbano sembrare anemici e privi di funzionalità evidenti.
5. Automatizza tutto
-
Sfrutta l’AI
-
Genera l'80% del codice boilerplate e non critico usando l'AI, permettendoci di concentrarci solo sulla logica di business complessa e sulle architetture critiche. I Teams che adottano flussi di lavoro moderni assistiti dall'AI fanno sempre più affidamento su strumenti come i migliori server MCP per migliorare la produttività degli sviluppatori e l'orchestrazione.
-
Costruisci alerting senza rumore e una gestione intelligente degli errori.
-
Il testing manuale è sempre più un ricordo del passato. L’AI può costruire per noi in modo rapido e intelligente enormi suite di test.
-
-
La nostra CI è il boss finale
-
Tutto in questo documento di standard viene controllato prima che il codice venga mergiato nelle PR
-
Nessuna sorpresa arriva su main
-
I controlli sono veloci e utili
-
Standard architetturali
Stiamo passando a un modello architetturale rigoroso basato su Vertical Slice Architecture e Domain-Driven Design (DDD). I seguenti pattern e principi verranno applicati con rigore nelle code review delle PR e tramite linting.
Vertical Slice Architecture: packages/features
Il nostro codebase è organizzato per dominio, non per livello tecnico. La directory packages/features è il cuore di questo approccio architetturale. Ogni cartella al suo interno rappresenta una slice verticale completa dell’applicazione, guidata dal dominio che tocca.
Struttura:
packages/features/
  availability/
  bookings/
  ooo/
  payments/
  routing/
  scheduling/
  ...
Ogni cartella feature è una slice verticale autosufficiente che include tutto ciò che serve per quel dominio:
-
Logica di dominio: le regole di business e le entità fondamentali specifiche di quella feature
-
Servizi applicativi: orchestrazione dei casi d’uso per quel dominio
-
Repository: accesso ai dati specifico alle esigenze di quella feature
-
DTO: oggetti di trasferimento dati per attraversare i confini
-
Componenti UI: componenti frontend relativi a questa feature (dove applicabile)
-
Test: test unitari, di integrazione ed e2e per questa feature
Perché le slice verticali sono importanti
L’architettura tradizionale a strati organizza per aspetti tecnici:
// Bad: Organized by layer
src/
  controllers/
    AvailabilityController.ts
    BookingController.ts
    OOOController.ts
  services/
    AvailabilityService.ts
    BookingService.ts
    OOOService.ts
  repositories/
    AvailabilityRepository.ts
    BookingRepository.ts
    OOORepository.ts
Questo crea diversi problemi:
-
Le modifiche a una feature richiedono di toccare file sparsi in più directory
-
È difficile capire cosa faccia una funzionalità perché il suo codice è frammentato
-
I Teams si pestano i piedi a vicenda quando lavorano su funzionalità diverse
-
Non puoi estrarre o deprecare facilmente una funzionalità
L'architettura a slice verticali organizza per dominio:
// Good: Organized by domain
packages/features/
  availability/
    services/
      AvailabilityApplicationService.ts
      AvailabilityDomainService.ts
    repositories/
      AvailabilityRepository.ts
    dto/
      AvailabilityDto.ts
bookings/
  services/
    BookingApplicationService.ts
    BookingDomainService.ts
  repositories/
    BookingRepository.ts
  dto/
    BookingDto.ts
Questo risolve questi problemi:
-
Tutto ciò che riguarda la disponibilità vive in
packages/features/availability -
Puoi capire l'intera funzionalità della disponibilità esplorando una sola directory
-
I Teams possono lavorare su funzionalità diverse senza conflitti (se il team di ingegneria di Cal.com cresce, ma molto probabilmente in coss.com faremo sì che i Teams si occupino di grandi pacchetti)
-
Le funzionalità sono debolmente accoppiate e possono evolvere in modo indipendente
Linee guida per l'organizzazione delle funzionalità
In teoria, ogni funzionalità è distribuibile in modo indipendente. Anche se magari non le distribuiremo davvero separatamente, organizzarci così ci obbliga a mantenere chiari i dependency e minimo l'accoppiamento. Questo è il presupposto e il successo dei microservizi, anche se non distribuiremo ancora microservizi.
Le funzionalità comunicano attraverso interfacce ben definite. Se bookings ha bisogno dei dati di availability, importa da @calcom/features/availability tramite interfacce esportate, non andando a toccare i dettagli dell'implementazione interna.
Il codice condiviso vive nei posti giusti:
-
Utility agnostiche rispetto al dominio e preoccupazioni trasversali (auth, logging) :
packages/lib -
Primitive UI condivise:
packages/ui(e presto anche coss.com ui)
I confini di dominio vengono applicati automaticamente. Costruiremo linting che impedisca di entrare negli interni delle funzionalità dove non è consentito. Se packages/features/bookings prova a importare da packages/features/availability/services/internal, il linter lo bloccherà. Tutte le dependency tra funzionalità devono passare attraverso l'API pubblica della funzionalità.
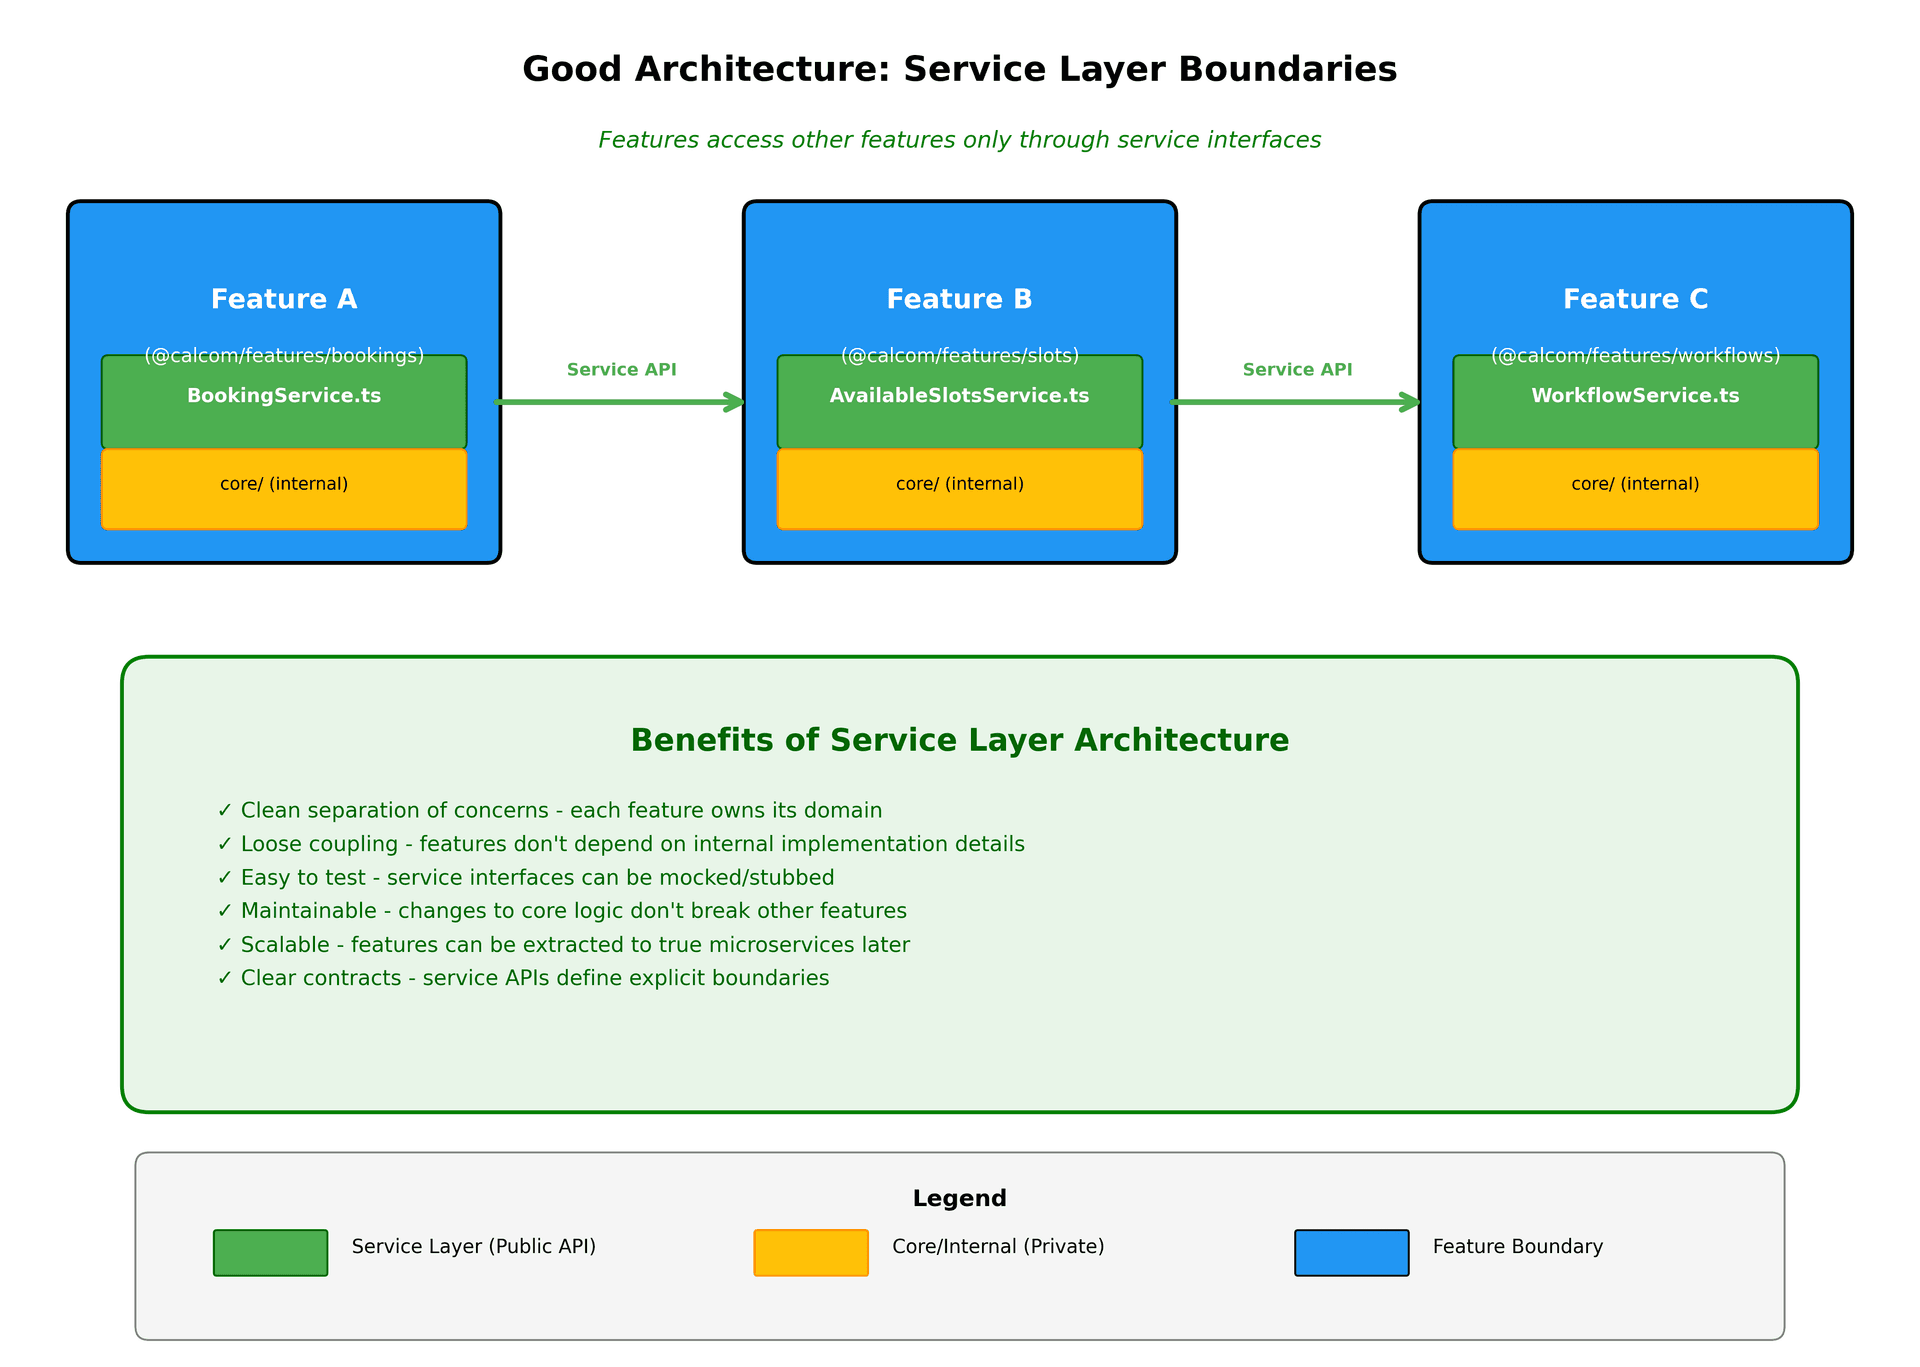
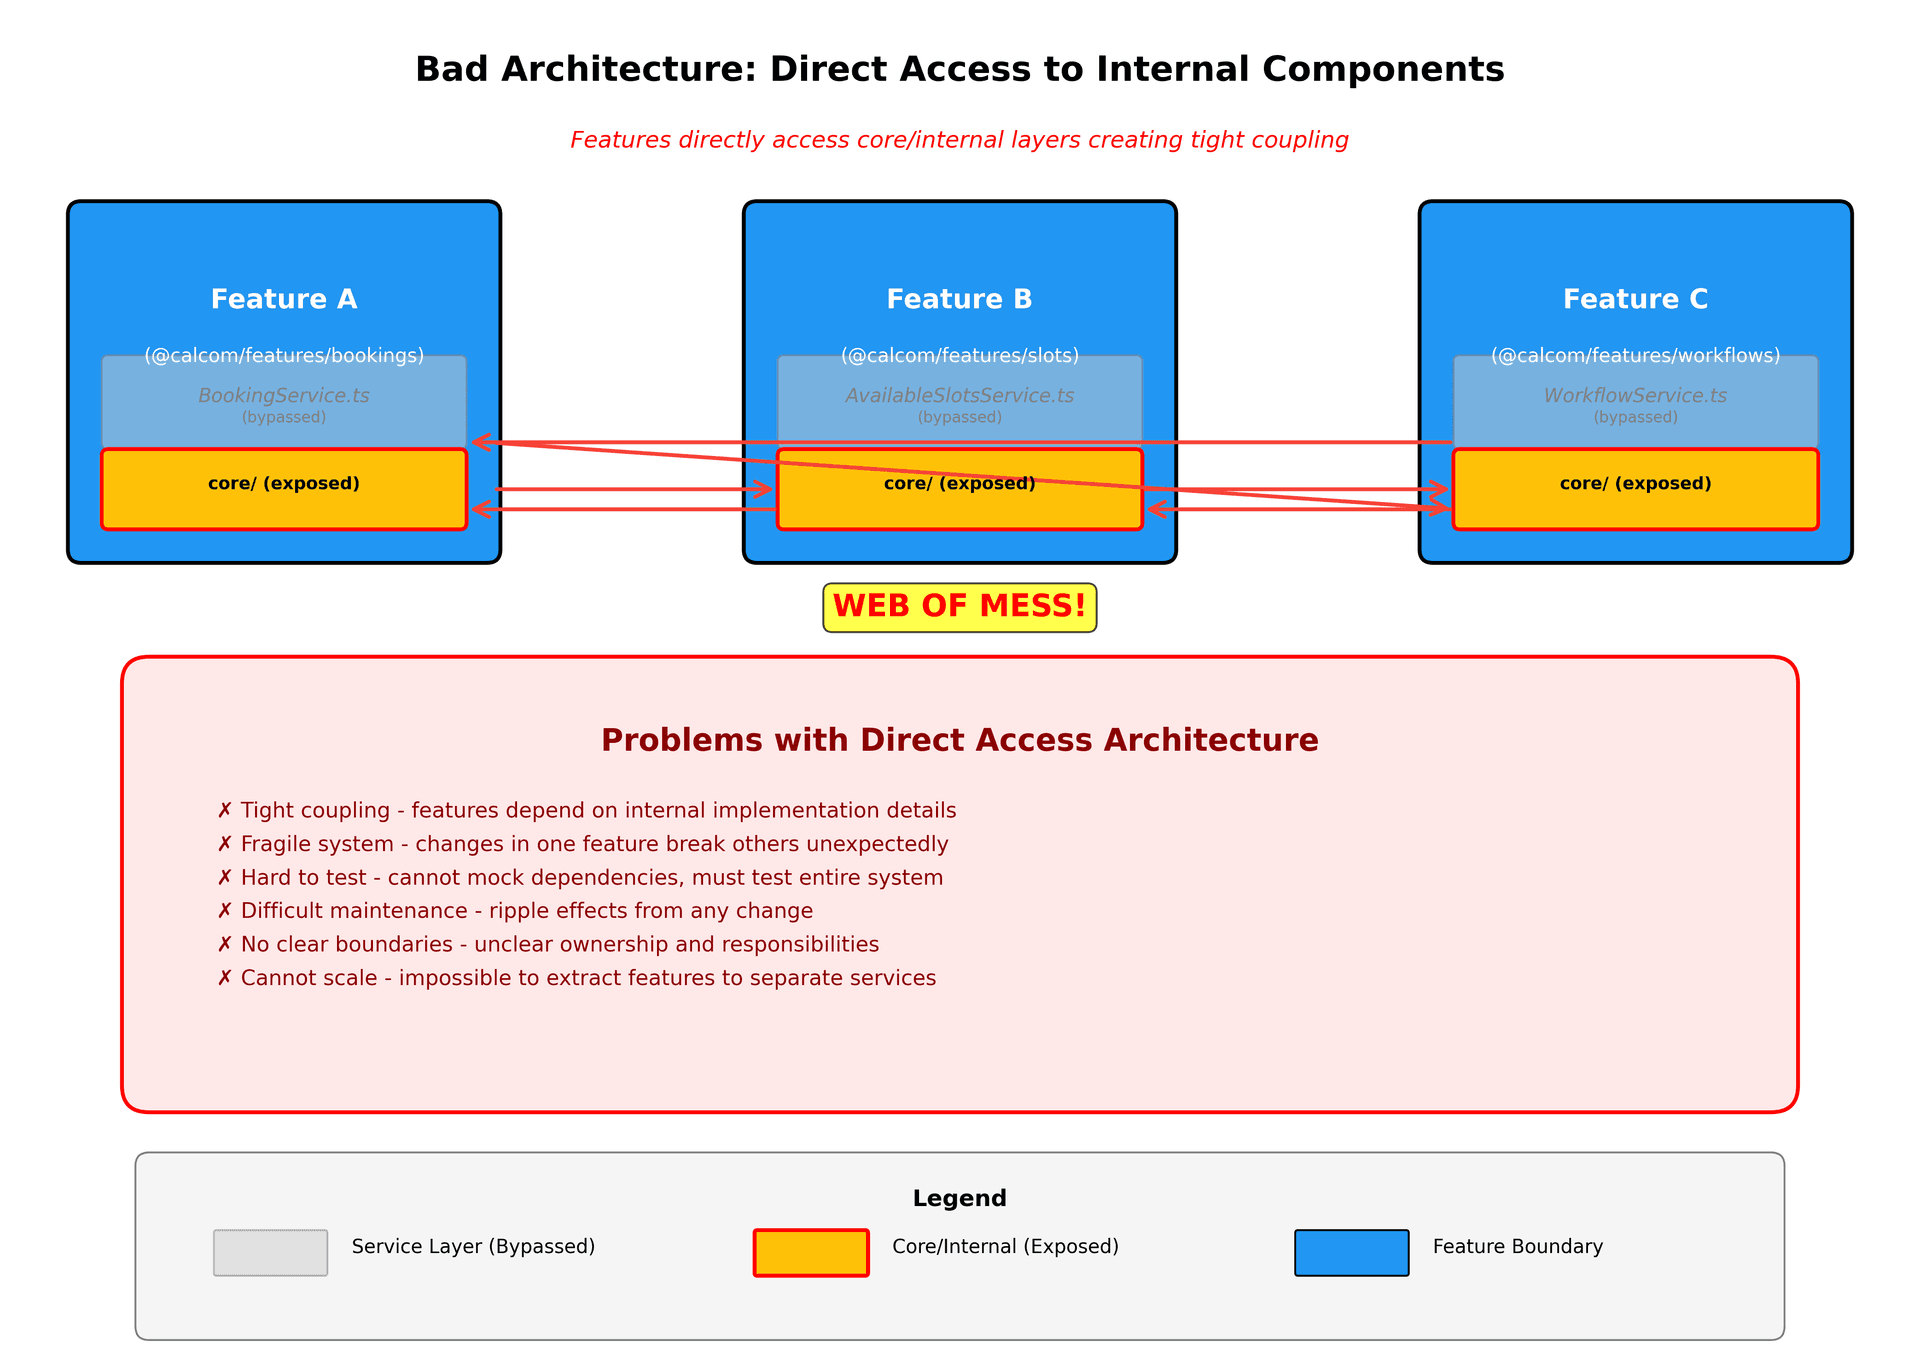
Le nuove funzionalità partono come slice verticali. Quando costruisci qualcosa di nuovo, crea una nuova cartella in packages/features con la slice verticale completa. Così è chiaro cosa stai costruendo e tutto resta organizzato fin dal primo giorno.
Benefici
-
Facilità di scoperta
- Cerchi la logica di booking? È tutta in
packages/features/bookings. Non devi cercare tra controller, service, repository e utility sparse per tutta la codebase.
- Cerchi la logica di booking? È tutta in
-
Test più semplici
- Testa l'intera funzionalità come un'unità. Hai tutti i pezzi in un unico posto, quindi i test di integrazione diventano naturali e diretti.
-
Dependency più chiare
- Quando vedi
import { getAvailability } from '@calcom/features/availability', sai esattamente da quale funzionalità dipendi. Quando le dependency diventano troppo complesse, è evidente e si può intervenire.
- Quando vedi
Repository Pattern e Dependency Injection
Le scelte tecnologiche non devono filtrare attraverso l'applicazione. Il problema di Prisma lo mostra perfettamente. Oggi abbiamo riferimenti a Prisma sparsi in centinaia di file. Questo crea un enorme accoppiamento e rende i cambi di tecnologia proibitivamente costosi. Stiamo sentendo ora il peso dell'upgrade di Prisma a v6.16. Quello che avrebbe dovuto essere solo un refactor localizzato dietro repository schermati è diventato una caccia lunga e quasi infinita a problemi in più app.
Lo standard da qui in avanti:
-
Tutto l'accesso al database deve passare attraverso classi Repository. Siamo già partiti bene su questo.
-
I repository sono l'unico codice che conosce Prisma (o qualsiasi altro ORM). Non devono contenere logica.
-
I repository vengono iniettati tramite container di Dependency Injection
-
Se mai passassimo da Prisma a Drizzle o a un altro ORM, le uniche modifiche richieste saranno:
-
Implementazioni dei repository
-
Cablaggio del container DI per i nuovi repository
-
Nient'altro nella codebase dovrebbe preoccuparsene o cambiare
-
Non è teoria. È così che costruiamo sistemi manutenibili.
Data Transfer Objects (DTOs)
I tipi del database non devono arrivare al frontend. Nello stack tecnologico è diventata una scorciatoia popolare, ma è un code smell che crea diversi problemi.
-
Accoppiamento tecnologico (i tipi Prisma finiscono nei componenti React)
-
Rischi per la sicurezza (fuoriuscita accidentale di campi sensibili)
-
Contratti fragili tra server e client (particolarmente problematico mentre costruiamo molte più API)
-
Impossibilità di evolvere lo schema del database in modo indipendente
-
Tutte le conversioni dei DTO passano da Zod, anche per una risposta API, per garantire che tutti i dati vengano validati prima di essere inviati all'utente. Meglio fallire che restituire qualcosa di sbagliato.
Lo standard da qui in avanti:
Crea DTO espliciti in ogni confine architetturale.
-
Data layer → Application layer → API: Trasforma i modelli del database in DTO del livello applicativo, poi trasforma i DTO applicativi in DTO specifici per l'API
-
API → Application layer → Data layer: Trasforma i DTO dell'API attraverso il livello applicativo e poi in DTO specifici per i dati
Sì, serve più codice. Sì, ne vale la pena. Confini espliciti prevengono l'erosione architetturale che crea incubi di manutenzione a lungo termine.
Pattern di Domain-Driven Design
I seguenti pattern devono essere usati correttamente e in modo coerente:
-
Application Services
- Orchestrano i casi d'uso, coordinano tra domain service e repository
-
Domain Services
- Contengono la logica di business che non appartiene naturalmente a una singola entità
-
Repositories
- Astraggono l'accesso ai dati, isolano le scelte tecnologiche
-
Dependency Injection
- Consentono un accoppiamento debole, facilitano il testing, isolano le responsabilità
-
Caching Proxies
-
Avvolgono repository o service per aggiungere il comportamento di caching in modo trasparente
-
Non è l'unico modo per fare caching, naturalmente, ma è un buon punto di partenza
-
-
Decorators
- Aggiungono responsabilità trasversali (logging, metriche, ecc.) senza contaminare la logica di dominio
Coerenza della codebase
Le nostre codebase dovrebbero sembrare scritte da una sola persona. Questo livello di coerenza richiede un'adesione rigorosa ai pattern stabiliti, regole di linting complete che impongono standard architetturali, code review che respingono le violazioni dei pattern + l'aiuto di revisori del codice AI.
Sposta le condizioni nel punto di ingresso dell'applicazione
Le istruzioni if appartengono al punto di ingresso, non sparse in tutti i tuoi servizi. Questo è uno dei principi architetturali più importanti per mantenere un codice pulito e focalizzato che non degeneri in una complessità ingestibile.
Ecco come il codice si degrada col tempo: un service viene scritto per uno scopo chiaro e specifico. La logica è pulita e focalizzata. Poi arriva un nuovo requisito di prodotto, e qualcuno aggiunge un'istruzione if. Qualche anno e altri requisiti dopo, quel service è pieno di controlli condizionali per scenari diversi. Il service è diventato:
-
Complicato e difficile da leggere
-
Difficile da capire e da valutare
-
Più soggetto a bug
-
In violazione del single responsibility (gestisce troppi casi diversi)
-
Quasi impossibile da testare a fondo
Il service ha oltrepassato i suoi limiti in termini di responsabilità e logica.
Una soluzione: pattern Factory con service specializzati
Usa il pattern factory per prendere decisioni nel punto di ingresso, poi delega a service specializzati che gestiscono la loro logica specifica senza condizioni.
Esempio dalla nostra codebase:
BillingPortalServiceFactory determina se la fatturazione riguarda un'organizzazione, un team o un singolo utente, poi restituisce il service appropriato:
export class BillingPortalServiceFactory {
  static async createService(teamId: number): Promise<BillingPortalService> {
    const team = await teamRepository.findById({ id: teamId });
    if (!team) {
      throw new Error("Team not found");
    }
    // Decision made HERE at the entry point
    if (team.isOrganization) {
      return new OrganizationBillingPortalService();
    }
    return new TeamBillingPortalService();
  }

  static createUserService(): UserBillingPortalService {
    return new UserBillingPortalService();
  }
}
Ogni service poi gestisce la sua logica specifica senza dover controllare "sono un org o un team?":
// OrganizationBillingPortalService handles ONLY organization logic
class OrganizationBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "organization.manageBilling",  // Organization-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more organization-specific logic
}

// TeamBillingPortalService handles ONLY team logic
class TeamBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "team.manageBilling",  // Team-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more team-specific logic
}
Perché conta
-
I service restano focalizzati
- Ogni service ha una sola responsabilità e non deve conoscere altri contesti.
OrganizationBillingPortalServicenon contiene istruzioni if che controllanoif (isTeam)oif (isUser). Sa solo come gestire le organizzazioni.
- Ogni service ha una sola responsabilità e non deve conoscere altri contesti.
-
Le modifiche restano isolate
- Quando devi modificare la logica di fatturazione dell’organizzazione, tocchi solo
OrganizationBillingPortalService. Non rischi di rompere la fatturazione di team o utenti. Non devi seguire condizioni annidate per capire quale percorso prende il tuo codice.
- Quando devi modificare la logica di fatturazione dell’organizzazione, tocchi solo
-
I test sono semplici
- Testa ogni servizio in modo indipendente con i suoi scenari specifici. Non c’è bisogno di testare ogni combinazione di condizioni in contesti diversi.
-
I nuovi requisiti non inquinano il codice esistente
- ad esempio, quando devi aggiungere la fatturazione enterprise con regole diverse, crei
EnterpriseBillingPortalService. La factory guadagna un’altra condizione, ma i servizi esistenti restano intatti e focalizzati.
- ad esempio, quando devi aggiungere la fatturazione enterprise con regole diverse, crei
Come riuscirci
-
Sposta le condizioni verso l’alto, nei controller, nelle factory o nella logica di routing. Lascia che questi punti di ingresso decidano quale servizio usare.
-
Mantieni i servizi puri e concentrati su una sola responsabilità. Se un servizio deve controllare "di che tipo sono?", probabilmente ti servono più servizi.
-
Preferisci il polimorfismo alle condizioni
- Le interfacce definiscono il contratto. Le implementazioni concrete forniscono i dettagli.
-
Fai attenzione all’accumulo di if
- Durante il code review, se vedi un servizio che accumula condizioni per scenari diversi, è un segnale per refactorarlo in servizi specializzati.
Progettazione API: controller sottili e astrazione HTTP
-
I controller sono strati sottili che gestiscono solo le preoccupazioni HTTP.
- Ricevono le richieste, le elaborano e mappano i dati in DTO passati alla logica applicativa core. Da qui in avanti, nessuna logica applicativa o core dovrebbe comparire nelle route API o negli handler tRPC.
-
Dobbiamo separare la tecnologia HTTP dalla nostra applicazione.
- Il modo in cui trasferiamo i dati tra client e server (REST, tRPC, ecc.) non dovrebbe influenzare il funzionamento della nostra applicazione core. HTTP è un meccanismo di consegna, non un motore architetturale.
Responsabilità dei controller (e SOLO queste):
-
Ricevere e validare le richieste in arrivo
-
Estrarre i dati da parametri, body e header della richiesta
-
Trasformare i dati della richiesta in DTO
-
Chiamare i servizi applicativi appropriati con quei DTO
-
Trasformare le risposte dei servizi applicativi in DTO di risposta
-
Restituire risposte HTTP con i codici di stato corretti
I controller NON devono:
-
Contenere logica di business o regole di dominio
-
Accedere direttamente a database o servizi esterni
-
Eseguire trasformazioni complesse dei dati o calcoli
-
Prendere decisioni su cosa debba fare l’applicazione
-
Conoscere i dettagli di implementazione del dominio
Esempio di pattern di controller sottile:
// Good: Thin controller
export async function createBookingHandler(req: Request, res: Response) {
  // Extract and validate request data
  const createBookingRequest = validateCreateBookingRequest(req.body);
  // Transform to DTO
  const createBookingDto = {
    userId: req.user.id,
    eventTypeId: createBookingRequest.eventTypeId,
    startTime: createBookingRequest.startTime,
    // ... other fields
  };
  // Delegate to application service
  const result = await bookingApplicationService.createBooking(createBookingDto);
  // Transform response and return
  const responseDto = mapBookingToResponseDto(result);
  res.status(201).json(responseDto);
}

// Bad: Fat controller with business logic
export async function createBookingHandler(req: Request, res: Response) {
  // This is wrong - business logic in controller
  if (req.body.startTime < new Date()) {
    return res.status(400).json({ error: "Cannot book in the past" });
  }

  // This is wrong - direct database access
  const existingBooking = await prisma.booking.findFirst({
    where: { eventTypeId: req.body.eventTypeId, startTime: req.body.startTime }
  });

  // This is wrong - complex business calculations
  const duration = calculateBookingDuration(req.body.eventTypeId);
  // ... more business logic
}
Versionamento API e breaking change
Nessun breaking change. Questo è fondamentale. Una volta che un endpoint API è pubblico, deve restare stabile. I breaking change distruggono la fiducia degli sviluppatori e creano incubi di integrazione per i nostri utenti.
Strategie per evitare i breaking change:
-
Aggiungi sempre i nuovi campi come opzionali
-
Usa il versionamento API quando devi cambiare il comportamento esistente
-
Depreca con grazia i vecchi endpoint con percorsi di migrazione chiari
-
Mantieni la compatibilità all’indietro per almeno due major version
Quando devi fare breaking change:
-
Crea una nuova versione API usando il versionamento basato sulla data in API v2 (forse daremo un’occhiata anche al versionamento con nome introdotto di recente da Stripe)
-
Esegui entrambe le versioni contemporaneamente durante la transizione (lo facciamo già in API v2)
-
Fornisci strumenti di migrazione automatizzati quando possibile
-
Dai agli utenti tutto il tempo necessario per migrare (minimo 6 mesi per le API pubbliche)
-
Documenta esattamente cosa è cambiato e perché
Performance e complessità algoritmica
Costruiamo per grandi organizzazioni e team. Quello che funziona bene con 10 utenti o 50 record può crollare sotto il peso della scala enterprise. Le performance non sono qualcosa da ottimizzare più tardi. Sono qualcosa che costruiamo bene fin dall’inizio.
Pensa alla scala fin dal primo giorno
Quando costruisci funzionalità, chiediti sempre: "Come si comporta con 1.000 utenti? 10.000 record? 100.000 operazioni?" La differenza tra algoritmi O(n) e O(n²) può essere impercettibile in sviluppo, ma catastrofica in produzione.
Pattern O(n²) comuni da evitare:
-
Iterazioni annidate su array (
.mapdentro.map,.forEachdentro.forEach) -
Metodi array come
.some,.findo.filterdentro cicli o callback -
Controllare ogni elemento contro ogni altro senza ottimizzazione
-
Filtri concatenati o mapping annidati su liste grandi
Esempio reale: Per 100 slot disponibili e 50 periodi occupati, un algoritmo O(n²) esegue 5.000 controlli. Portalo a 500 slot e 200 periodi occupati, e fai 100.000 operazioni. È un aumento del carico computazionale di 20x per un aumento dei dati di solo 5x.
Scegli le giuste strutture dati e algoritmi
La maggior parte dei problemi di performance si risolve scegliendo strutture dati e algoritmi migliori:
-
Ordinamento + uscita anticipata: ordina i tuoi dati una volta, poi esci dai cicli quando sai che gli elementi rimanenti non corrisponderanno
-
Ricerca binaria: usa la ricerca binaria per le ricerche in array ordinati invece delle scansioni lineari
-
Tecniche a due puntatori: per unire o intersecare sequenze ordinate, scorrile entrambe con puntatori invece di cicli annidati
-
Hash map/set: usa oggetti o Set per ricerche O(1) invece di
.findo.includessugli array -
Interval tree: per scheduling, disponibilità e query su intervalli, usa strutture ad albero adeguate invece del confronto brute force
Trasformazione di esempio:
// Bad: O(n²) - checks every slot against every busy time
availableSlots.filter(slot => {
  return !busyTimes.some(busy => checkOverlap(slot, busy));
});

// Good: O(n log n) - sort once, break early
const sortedBusy = [...busyTimes].sort((a, b) => a.start - b.start);
availableSlots.filter(slot => {
  for (const busy of sortedBusy) {
    if (busy.start >= slot.end) break; // No more overlaps possible
    if (busy.end <= slot.start) continue; // This one doesn't overlap
    return false; // Overlap found
  }
  return true;
});
Controlli automatici delle performance
Implementeremo più livelli di difesa contro le regressioni di performance:
Regole di lint che segnalano:
-
Funzioni con cicli annidati o metodi array annidati
-
Più chiamate annidate a
.some,.findo.filter -
Ricorsione senza memoizzazione
-
Anti-pattern noti per il nostro dominio (scheduling, controlli di disponibilità, ecc.)
Benchmark di performance in CI che:
-
Eseguono gli algoritmi critici su dati realistici e di grande scala
-
Confrontano i tempi di esecuzione con la baseline a ogni PR
-
Bloccano le merge che introducono regressioni di performance
-
Testano con dati su scala enterprise (migliaia di utenti, decine di migliaia di record)
Monitoraggio in produzione che:
-
Traccia i tempi di esecuzione per i percorsi critici
-
Avvisa quando gli algoritmi rallentano mentre i dati crescono
-
Individua le regressioni prima che se ne accorgano gli utenti
-
Fornisce dati reali sulle performance per guidare le ottimizzazioni
La performance è una funzionalità
Le prestazioni non sono opzionali. Non è qualcosa che "rimandiamo a più tardi". Per i clienti enterprise che prenotano su team grandi, risposte lente significano produttività persa e utenti frustrati (la nostra esperienza con alcuni clienti enterprise più grandi può esserne una prova).
Ogni engineer dovrebbe:
-
Profilare il codice prima di ottimizzarlo, ma pensare alla complessità fin dall'inizio
-
Testare con dati realistici e su larga scala (non solo 5 record di test). Abbiamo già script di seed pronti. Probabilmente dobbiamo estenderli.
-
Scegliere in anticipo algoritmi e strutture dati efficienti
-
Fare attenzione alle iterazioni annidate in code review
-
Mettere in discussione qualsiasi algoritmo che scala con il prodotto di due variabili
La realtà NP-Hard della pianificazione
I problemi di pianificazione sono fondamentalmente NP-hard. Questo significa che, man mano che aumenta il numero di vincoli, partecipanti o slot orari, la complessità computazionale può esplodere in modo esponenziale. La maggior parte degli algoritmi di pianificazione ottimali ha una complessità temporale esponenziale nel caso peggiore, quindi la scelta dell'algoritmo è assolutamente critica.
Implicazioni nel mondo reale:
-
Trovare l'orario ottimale per una riunione con 10 persone distribuite su 3 fusi orari e con vincoli di disponibilità individuali è computazionalmente costoso
-
Aggiungere rilevamento dei conflitti, buffer e una miriade di altre opzioni amplifica il problema
-
Scelte di algoritmo sbagliate che vanno bene per team piccoli diventano completamente inutilizzabili per grandi organizzazioni
-
Ciò che richiede millisecondi per 5 utenti potrebbe richiedere molti secondi per le organizzazioni
Strategie per gestire la complessità NP-hard:
-
Usa algoritmi di approssimazione che trovano soluzioni "abbastanza buone" rapidamente invece di soluzioni perfette lentamente
-
Implementa un caching aggressivo di pianificazioni e disponibilità calcolate
-
Precalcola gli scenari comuni durante le ore di minor carico
-
Suddividi i grandi problemi di pianificazione in blocchi più piccoli e più gestibili
-
Imposta limiti di timeout ragionevoli e passa ad algoritmi più semplici quando serve
Ecco perché le prestazioni non sono solo un optional nel software di pianificazione. Sono la base che determina se il tuo sistema può scalare fino alle esigenze enterprise o crolla sotto i modelli d'uso del mondo reale.
Requisiti di copertura del codice
-
Tracciamento globale della copertura
- Tracciamo la copertura complessiva della codebase come metrica chiave che migliora nel tempo. Questo ci dà visibilità sulla maturità dei nostri test e aiuta a identificare le aree che richiedono attenzione. La percentuale di copertura globale viene mostrata in evidenza nei nostri dashboard.
-
Copertura 80%+ per il nuovo codice
- Ogni PR deve avere una copertura dei test vicina all'80%+ per il codice che introduce o modifica. Questo viene applicato automaticamente nella nostra pipeline CI. Se aggiungi 50 righe di nuovo codice, quelle 50 righe devono essere coperte dai test. Se modifichi una funzione esistente, le tue modifiche devono essere testate. Questa è la copertura complessiva dei test. La copertura dei test unitari deve essere vicina al 100%, soprattutto con la possibilità di sfruttare l'AI per aiutare a generarli.
Affrontare l'argomento "la copertura non racconta tutta la storia": Sì, sappiamo che la copertura non garantisce test perfetti. Sappiamo che puoi scrivere test insignificanti che toccano ogni riga ma non testano nulla di utile. Sappiamo che la copertura è solo una metrica tra le tante. Ma è certamente meglio puntare a una percentuale alta che non avere alcuna idea di dove ti trovi.
Misurare il successo
-
"Velocity" (rubato dallo Scrum anche se non useremo Scrum)
- Crescita continua delle statistiche mensili (funzionalità, miglioramenti, refactor)
-
Qualità
- Ridurre la quota di effort delle PR spesa per correzioni dall'attuale 35% al 20% o meno entro la fine del 2026 (calcolato in base alle modifiche ai file e ad aggiunte/eliminazioni)
-
Salute architetturale
- Metriche su aderenza ai pattern, accoppiamento tecnologico, violazioni dei confini
-
Efficienza di review
- PR più piccole, review più veloci, meno round di feedback
-
Uptime dell'applicazione e dell'API
- Quanto siamo vicini al 99.99%?