Engineering in 2026 en daarna
We bouwen aan infrastructuur die bijna nooit mag uitvallen. Om dat te bereiken, gaan we snel vooruit terwijl we geweldige software van hoge kwaliteit opleveren, zonder shortcuts of compromissen. Dit document schetst de engineeringstandaarden die ons door 2026 en daarna zullen leiden.
On this page
- Teamstructuur
- Onze resultaten tot nu toe
- Cal.com's fundament maakt uitmuntendheid mogelijk voor coss.com
- Kernprincipes
- 1. Geen uitgestelde kwaliteit
- 2. Hoge standaarden in code review
- 3. Spoor elkaar aan om het juiste te doen
- 4. Streef naar eenvoud
- 5. Automatiseer alles
- Architectuurstandaarden
- Vertical Slice Architecture: packages/features
- Waarom verticale slices belangrijk zijn
- Richtlijnen voor functie-ordening
- Voordelen
- Repository-pattern en dependency injection
- Data Transfer Objects (DTO's)
- Domain-Driven Design-patronen
- Consistentie van de codebase
- Zet conditionals aan het begin van de applicatie
- Waarom dit belangrijk is
- Hoe je dit bereikt
- API-ontwerp: dunne controllers en HTTP-abstrahering
- API-versiebeheer en breaking changes
- Prestaties en algoritmische complexiteit
- Denk vanaf dag één aan schaal
- Kies de juiste datastructuren en algoritmen
- Geautomatiseerde prestatiecontroles
- Prestaties zijn een functie
- De NP-harde realiteit van planning
- Vereisten voor code coverage
- Succes meten
Teamstructuur
Onze engineeringorganisatie bestaat uit vijf kernteams, elk met eigen verantwoordelijkheden:
-
Foundation Team: Richt zich op het vastleggen en onderhouden van codestandaarden en architectuurpatronen. Dit team werkt nauw samen met andere teams om best practices binnen de organisatie vast te leggen.
-
Consumer, Enterprise, and Platform Teams: Productgerichte teams die snel functies lanceren terwijl ze voldoen aan de kwaliteitsnormen die in dit document zijn vastgelegd. Deze teams bewijzen dat snelheid en kwaliteit elkaar niet uitsluiten.
-
Community Team: Verantwoordelijk voor het snel reviewen van PR's uit de open source-community, feedback geven en dat werk begeleiden tot aan de merge. Dit team zorgt ervoor dat onze open source-bijdragers een geweldige ervaring hebben en dat hun bijdragen aan onze kwaliteitsstandaarden voldoen. Het onderhouden van een sterke open-source-cultuur blijft bepalen hoe Cal.com engineering-samenwerking en productontwikkeling aanpakt.
Onze resultaten tot nu toe
De cijfers spreken voor zich. In het afgelopen anderhalf jaar hebben we de manier waarop we software bouwen fundamenteel veranderd:

We hebben onze engineeringoutput ongeveer verdubbeld en tegelijk de kwaliteit verbeterd. Nog indrukwekkender is de verschuiving in wat we bouwen:

We hebben met succes ongeveer 20% van de engineeringinspanning verplaatst van fixes naar features, prestatieverbeteringen, refactors en chores. Deze verschuiving laat zien dat investeren in kwaliteit en architectuur je niet vertraagt. Het versnelt je.
Cal.com's fundament maakt uitmuntendheid mogelijk voor coss.com
-
Cal.com is een stabiel, winstgevend bedrijf dat we blijven laten groeien.
- Dit succes geeft ons een uniek voordeel terwijl we coss.com bouwen. Anders dan in de beginjaren van Cal.com, waarin we snel moesten bewegen om product-market fit te bereiken en een duurzaam bedrijf op te bouwen, begint coss.com vanuit een sterke positie.
-
We hoeven coss.com niet te haasten.
- De stabiliteit van Cal.com betekent dat we coss.com vanaf dag één op de juiste manier kunnen bouwen. We hebben de luxe om deze engineeringstandaarden door te voeren zonder de druk van directe marktvraag of financieringsbeperkingen. Dat is een fundamenteel andere startpositie.
-
De "traagheid" is een investering, geen kostenpost.
- Ja, het volgen van deze standaarden kan in eerste instantie trager aanvoelen en voor sommige engineers zelfs frustrerend zijn. DTO's schrijven kost meer tijd dan database types direct doorgeven aan de frontend. Goede abstracties en dependency injection maken meer ontwerpwerk vooraf nodig. Voor nieuwe code 80%+ testdekking aanhouden vraagt discipline. Maar deze schijnbare traagheid is tijdelijk, en de opbrengst is exponentieel.
Denk aan de samengestelde opbrengst...
-
Code die vanaf het begin goed is ontworpen, heeft later geen grote refactors nodig
-
Hoge testdekking voorkomt bugs die anders weken aan debugging en hotfixes zouden kosten (zie 2023 tot midden 2024)
-
Goede abstracties maken het toevoegen van nieuwe features in de loop van de tijd enorm veel sneller
-
Schone grenzen en DTO's voorkomen de architecturale erosie die uiteindelijk complete herschrijvingen vereist
Het Cal.com traject laat zien wat er gebeurt als je optimaliseert voor directe snelheid. Hoge beginsnelheid die geleidelijk afneemt naarmate technische schuld zich opstapelt, architecturale shortcuts knelpunten creëren en er meer tijd wordt besteed aan het oplossen van problemen dan aan het bouwen van features (zie de vorige grafiek waar we 55-60% van de engineeringinspanning aan fixes besteedden).
Het traject van coss.com omarmt de kracht van vanaf dag één goed bouwen. Iets lagere beginsnelheid terwijl we de juiste patronen neerzetten, gevolgd door exponentiële versnelling zodra die patronen hun vruchten afwerpen en snellere ontwikkeling met meer vertrouwen mogelijk maken.
Kernprincipes
1. Geen uitgestelde kwaliteit
-
We zullen "dat doe ik in een follow-up PR wel" voor kleine refactors minimaliseren.
- Follow-up PR's voor kleine verbeteringen komen zelden echt van de grond. In plaats daarvan stapelen ze zich op als technische schuld die ons maanden of jaren later belast. Als een kleine refactor nu kan worden gedaan, doe het dan nu. Follow-ups zijn alleen bedoeld voor substantiële wijzigingen die echt een aparte PR rechtvaardigen of voor uitzonderlijke, urgente gevallen.
2. Hoge standaarden in code review
-
Laat PR's niet door met heel veel nits alleen maar om niet "de lastige persoon" te zijn.
- Zo worden codebases na verloop van tijd juist slordig. Code review draait niet om aardig zijn. Het gaat om het handhaven van de kwaliteitsstandaarden die onze infrastructuur vereist. Elke nitpick telt. Elke schending van een patroon telt. Pak ze aan vóór de merge, niet erna.
3. Spoor elkaar aan om het juiste te doen
-
We houden elkaar verantwoordelijk voor kwaliteit
- Shortcuts nemen voelt op dat moment misschien sneller, maar het creëert problemen die iedereen later vertragen. Als je ziet dat een teamgenoot op het punt staat een PR met duidelijke problemen te mergen, zeg er dan iets van. Als iemand een snelle hack voorstelt in plaats van de juiste oplossing, geef dan tegenwicht. Als je in de verleiding komt om tests over te slaan of architectuurpatronen te negeren, reken er dan op dat je teamgenoten je daarop aanspreken.
-
Dit gaat er niet om lastig te doen of mensen te vertragen
- Het gaat om collectief eigenaarschap van onze codebase en onze reputatie. Elke shortcut die één persoon neemt, wordt ieders probleem. Elke hoek die vandaag wordt afgesneden betekent morgen meer debug-sessies, meer hotfixes en meer gefrustreerde klanten.
-
Maak het normaal om slechte beslissingen respectvol uit te dagen
- Als iemand zegt "laten we dit voor nu gewoon hardcoden", zou het verwachte antwoord moeten zijn: "wat kost het om het meteen op de juiste manier te doen?" Als iemand ongecontroleerde code wil committen, moet het team daar tegenin gaan. Als iemand voorstelt om te kopiëren en plakken in plaats van een goede abstractie te maken, kaart dat dan respectvol aan.
-
We bouwen iets dat bijna nooit mag uitvallen
- Dat niveau van betrouwbaarheid ontstaat niet per ongeluk. Het gebeurt wanneer elke engineer zich verantwoordelijk voelt voor kwaliteit, niet alleen voor eigen code maar voor het hele systeem. We slagen als team of we falen als team.
4. Streef naar eenvoud
-
Geef duidelijkheid voorrang op slimdoenerij
- Het doel is code die makkelijk en snel te lezen en te begrijpen is, niet elegante complexiteit. Eenvoudige systemen verlagen de cognitieve belasting voor elke engineer.
-
Stel jezelf de juiste vragen
-
Los ik daadwerkelijk het probleem op dat voor me ligt?
-
Denk ik niet te veel na over mogelijke toekomstige use cases?
-
Heb ik minstens 1 andere alternatieve oplossing overwogen? Hoe verhoudt die zich tot deze?
-
-
Eenvoud betekent niet dat er functies ontbreken
- Alleen omdat ons doel is om eenvoudige systemen te maken, betekent dat nog niet dat ze futloos of zonder duidelijke functionaliteit moeten aanvoelen.
5. Automatiseer alles
-
Maak gebruik van AI
-
Genereer 80% van de boilerplate en niet-kritieke code met AI, zodat we ons volledig kunnen richten op complexe bedrijfslogica en kritieke architectuur. Teams die moderne AI-ondersteunde workflows omarmen, vertrouwen steeds vaker op tools zoals de best MCP servers om developerproductiviteit en orkestratie te verbeteren.
-
Bouw alerting zonder ruis en slimme foutafhandeling.
-
Handmatig testen wordt steeds meer iets van het verleden. AI kan snel en slim enorme testsuites voor ons bouwen.
-
-
Onze CI is de eindbaas
-
Alles in dit standaarden-document wordt gecontroleerd voordat code in PR's wordt gemerged
-
Er komen geen verrassingen in main
-
Checks zijn snel en nuttig
-
Architectuurstandaarden
We stappen over op een strikt architectuurmodel op basis van Vertical Slice Architecture en Domain-Driven Design (DDD). De volgende patronen en principes worden streng gehandhaafd in PR-reviews en via linting.
Vertical Slice Architecture: packages/features
Onze codebase is georganiseerd op domein, niet op technische laag. De map packages/features is de kern van deze architecturale aanpak. Elke map daarin vertegenwoordigt een complete verticale slice van de applicatie, gestuurd door het domein dat ze raakt.
Structuur:
packages/features/
  availability/
  bookings/
  ooo/
  payments/
  routing/
  scheduling/
  ...
Elke featuremap is een zelfstandige verticale slice die alles bevat wat nodig is voor dat domein:
-
Domeinlogica: De kern van bedrijfsregels en entiteiten die specifiek zijn voor die feature
-
Applicatieservices: Orchestratie van use cases voor dat domein
-
Repositories: Datatoegang specifiek voor de behoeften van die feature
-
DTO's: Data transfer objects voor het overbruggen van grenzen
-
UI-componenten: Frontendcomponenten die bij deze feature horen (waar van toepassing)
-
Tests: Unit-, integratie- en e2e-tests voor deze feature
Waarom verticale slices belangrijk zijn
Traditionele gelaagde architectuur organiseert op technische verantwoordelijkheden:
// Bad: Organized by layer
src/
  controllers/
    AvailabilityController.ts
    BookingController.ts
    OOOController.ts
  services/
    AvailabilityService.ts
    BookingService.ts
    OOOService.ts
  repositories/
    AvailabilityRepository.ts
    BookingRepository.ts
    OOORepository.ts
Dit zorgt voor meerdere problemen:
-
Wijzigingen aan één feature vereisen het aanpassen van bestanden die verspreid staan over meerdere mappen
-
Het is lastig te begrijpen wat een functie doet, omdat de code gefragmenteerd is
-
Teams zitten elkaar in de weg wanneer ze aan verschillende functies werken
-
Je kunt een functie niet eenvoudig eruit halen of afschaffen
Vertical slice-architectuur ordent per domein:
// Good: Organized by domain
packages/features/
  availability/
    services/
      AvailabilityApplicationService.ts
      AvailabilityDomainService.ts
    repositories/
      AvailabilityRepository.ts
    dto/
      AvailabilityDto.ts
bookings/
  services/
    BookingApplicationService.ts
    BookingDomainService.ts
  repositories/
    BookingRepository.ts
  dto/
    BookingDto.ts
Dit lost deze problemen op:
-
Alles wat met beschikbaarheid te maken heeft, staat in
packages/features/availability -
Je kunt de hele beschikbaarheidsfunctie begrijpen door één map te verkennen
-
Teams kunnen aan verschillende functies werken zonder conflicten (als het engineeringteam van Cal.com groeit, maar in coss.com zullen we vrijwel zeker teams grote packages laten oppakken)
-
Functies zijn los gekoppeld en kunnen onafhankelijk evolueren
Richtlijnen voor functie-ordening
In theorie is elke functie afzonderlijk uitrolbaar. Ook al deployen we ze misschien niet echt apart, dwingt deze manier van ordenen ons om afhankelijkheden duidelijk te houden en koppelingen minimaal. Dit is het uitgangspunt en succes van microservices, hoewel we nog geen microservices zullen deployen.
Functies communiceren via duidelijk gedefinieerde interfaces. Als bookings beschikbaarheidsgegevens nodig heeft, importeert het uit @calcom/features/availability via geëxporteerde interfaces, in plaats van in interne implementatiedetails te graven.
Gedeelde code staat op de juiste plek:
-
Domeinonafhankelijke utilities en cross-cutting concerns (auth, logging):
packages/lib -
Gedeelde UI-primitives:
packages/ui(en binnenkort coss.com ui)
Domeingrenzen worden automatisch gehandhaafd. We gaan linting bouwen die voorkomt dat je in de interne delen van functies grijpt waar dat niet mag. Als packages/features/bookings probeert te importeren uit packages/features/availability/services/internal, blokkeert de linter dat. Alle afhankelijkheden tussen functies moeten via de openbare API van die functie lopen.
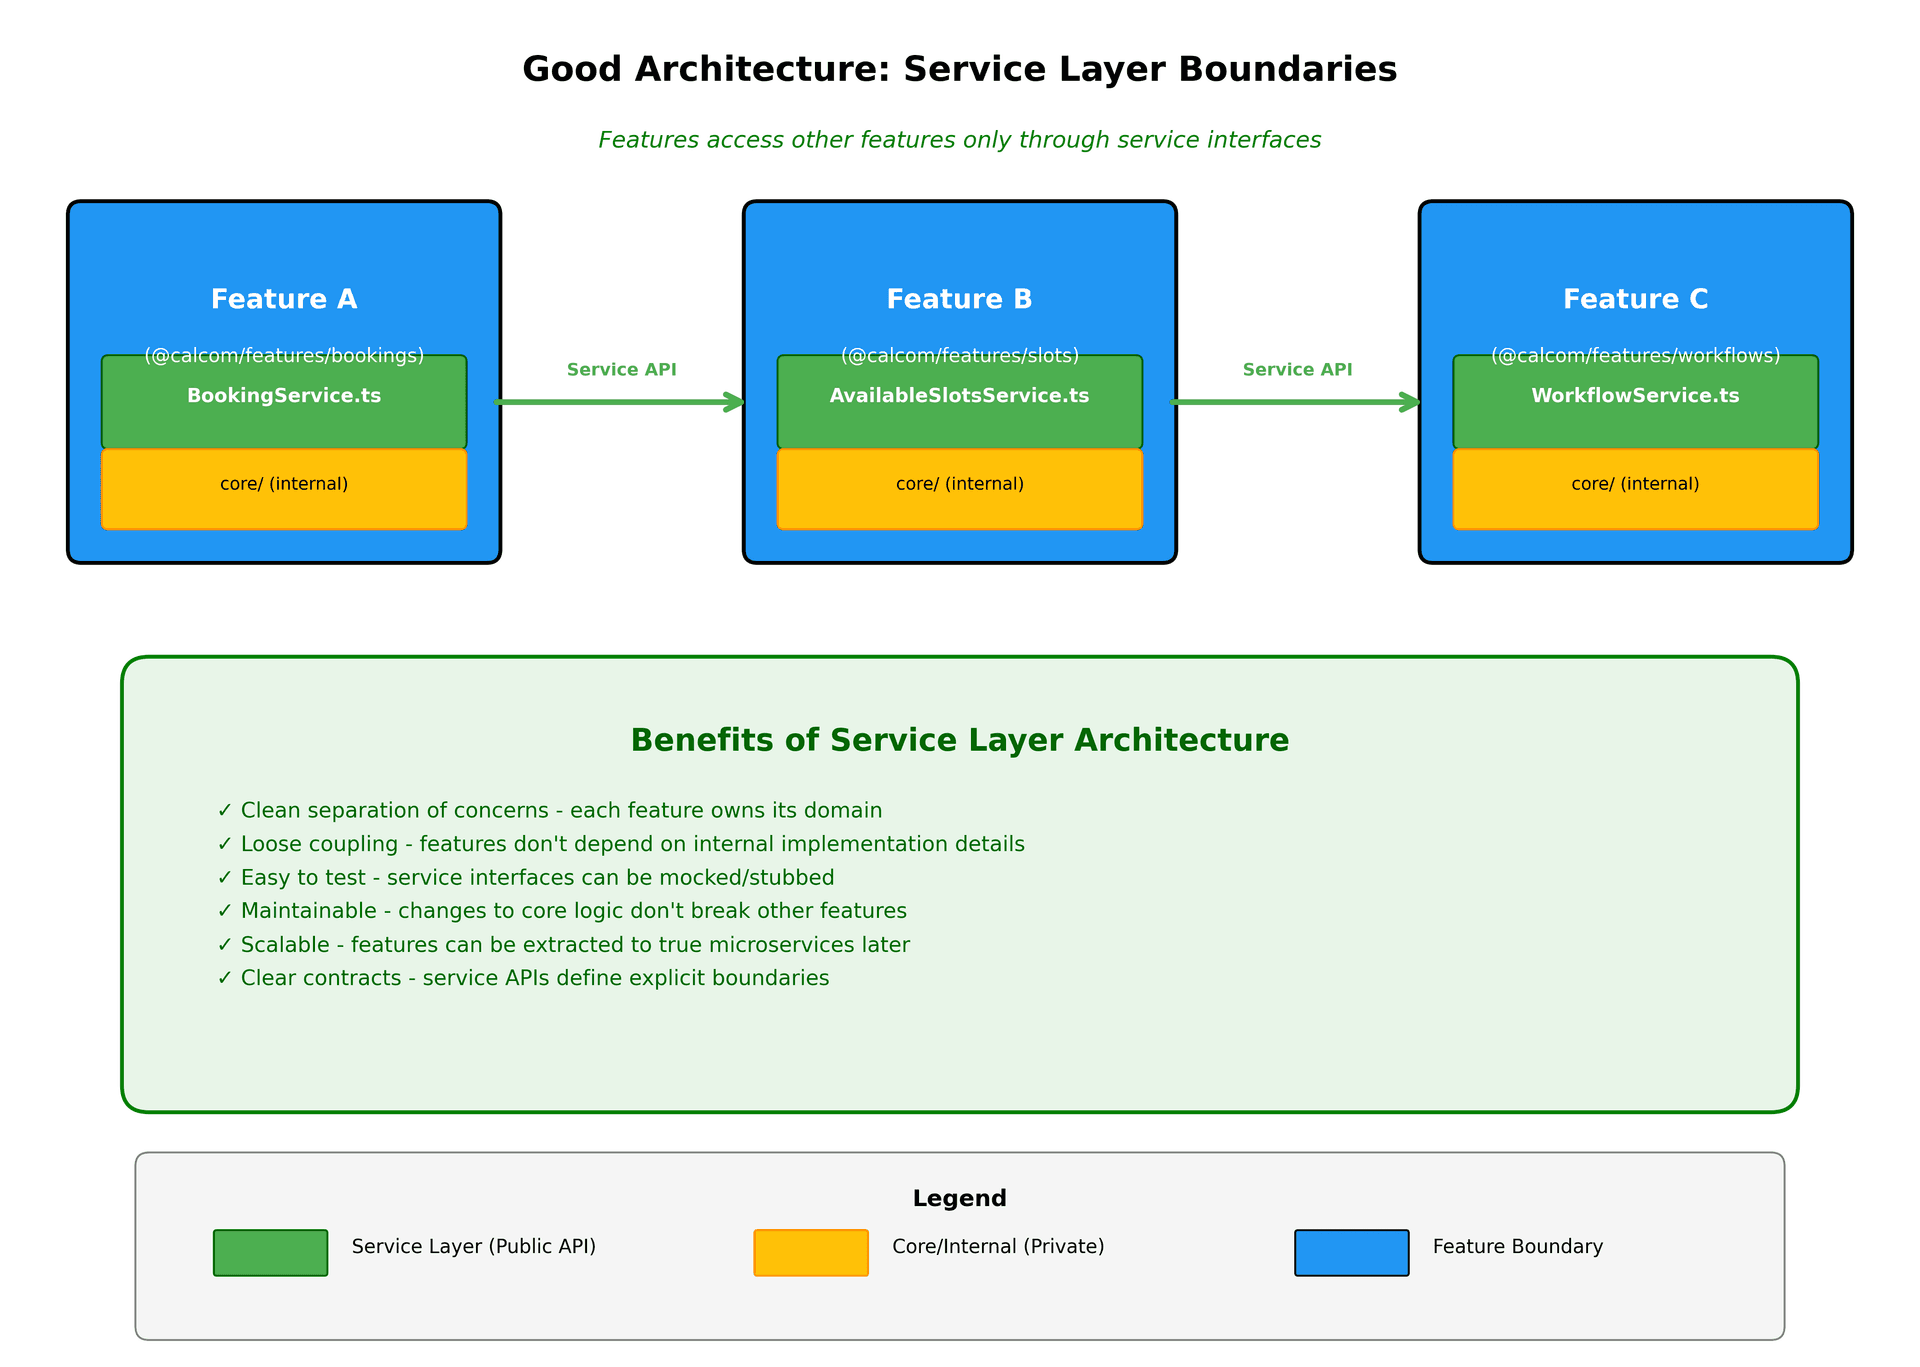
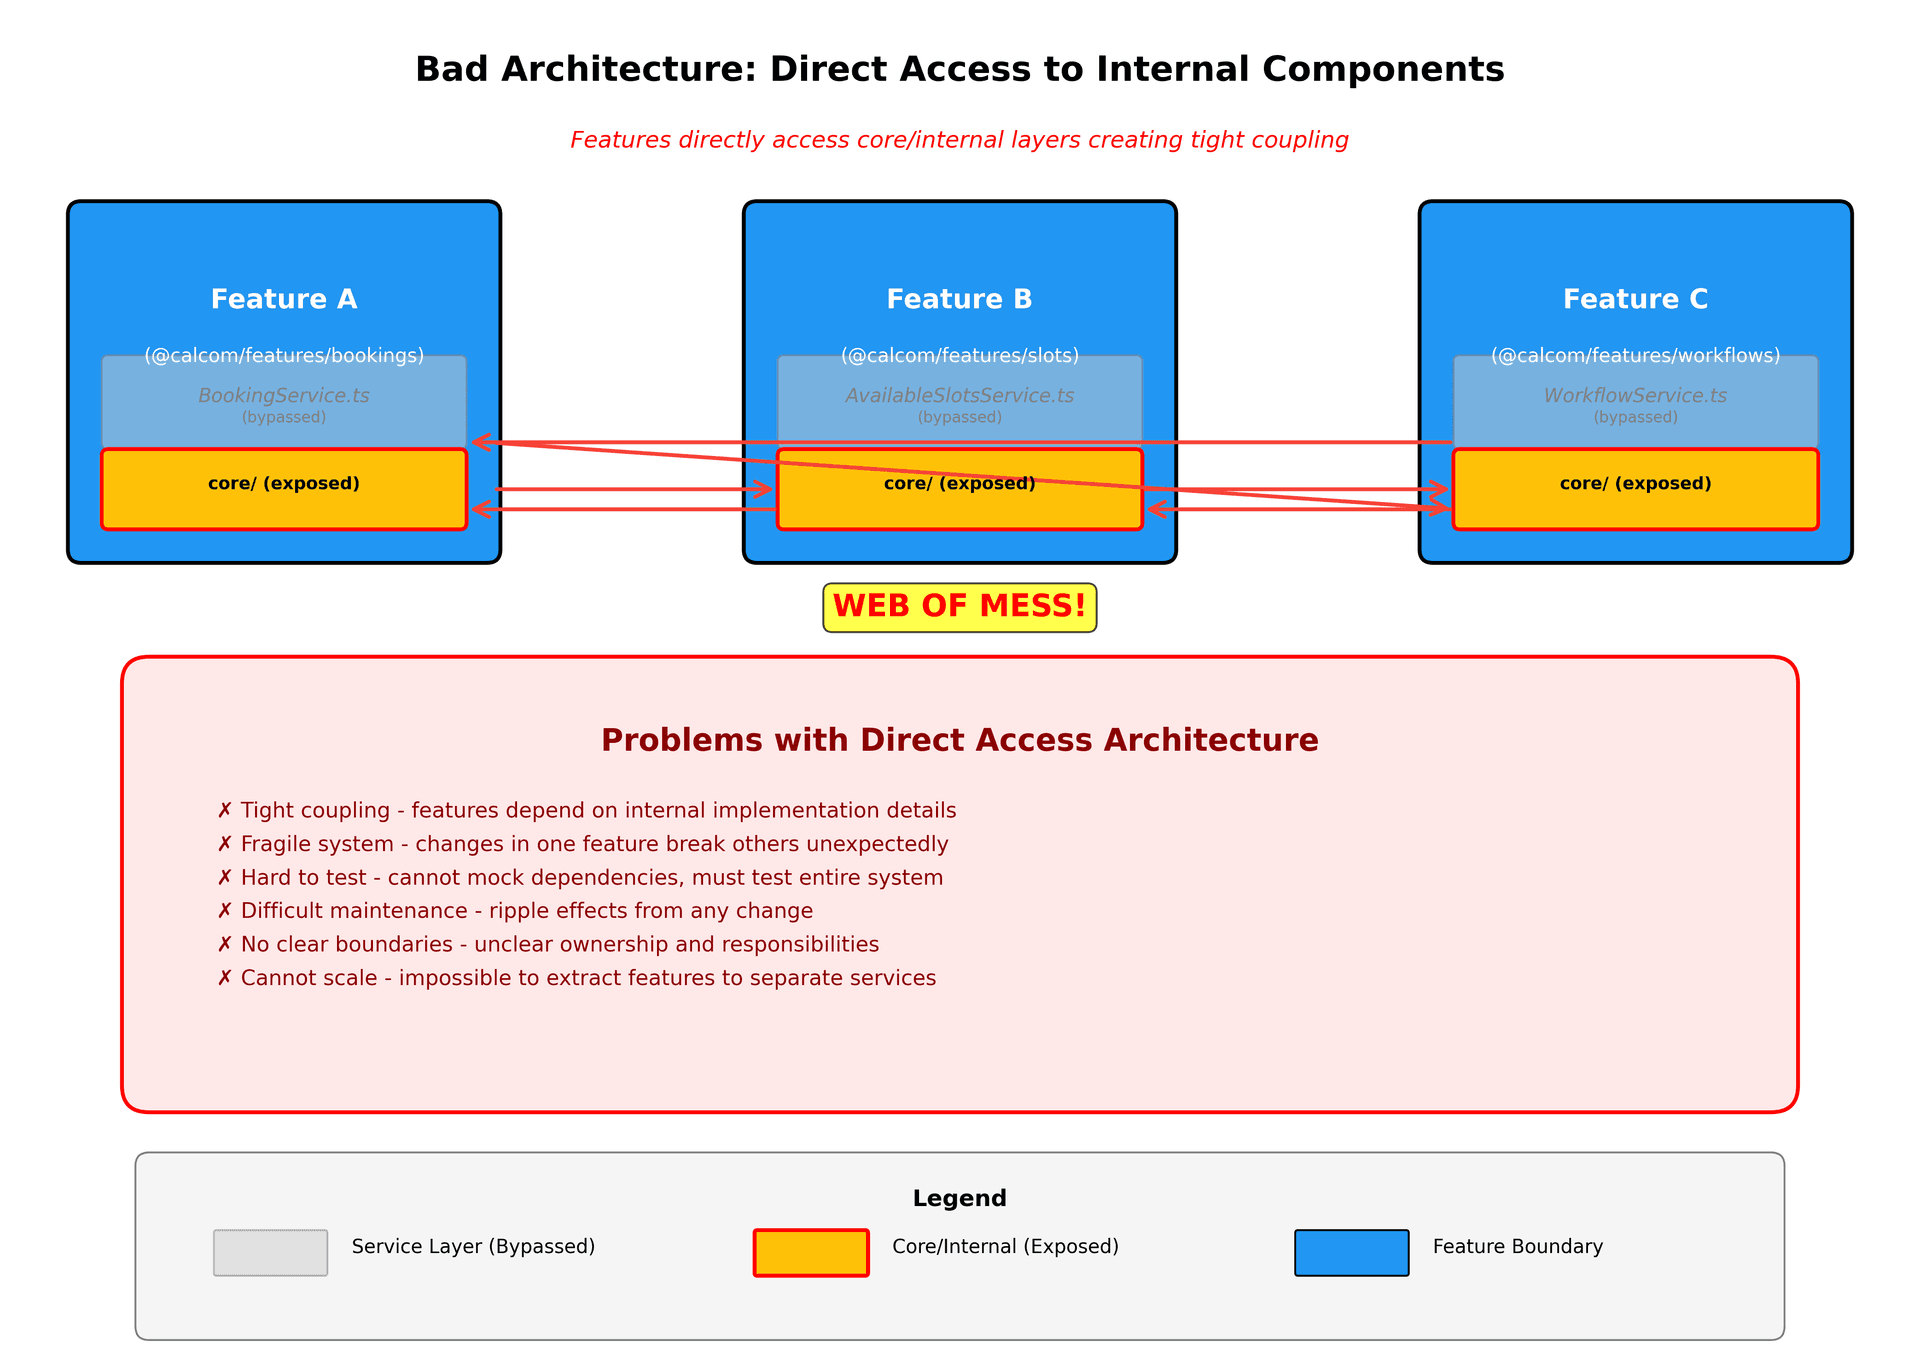
Nieuwe functies beginnen als vertical slices. Als je iets nieuws bouwt, maak dan een nieuwe map in packages/features met de complete vertical slice. Zo is duidelijk wat je bouwt en blijft alles vanaf dag één georganiseerd.
Voordelen
-
Vindbaarheid
- Op zoek naar bookinglogica? Die staat allemaal in
packages/features/bookings. Je hoeft niet te zoeken door controllers, services, repositories en utilities die verspreid zijn over de codebase.
- Op zoek naar bookinglogica? Die staat allemaal in
-
Eenvoudiger testen
- Test de hele functie als één geheel. Je hebt alle onderdelen op één plek, waardoor integratietesten natuurlijk en rechttoe rechtaan worden.
-
Duidelijkere afhankelijkheden
- Als je
import { getAvailability } from '@calcom/features/availability'ziet, weet je precies van welke functie je afhankelijk bent. Als afhankelijkheden te complex worden, is dat meteen duidelijk en kun je het aanpakken.
- Als je
Repository-pattern en dependency injection
Technologiekeuzes mogen niet door de applicatie heen sijpelen. Het Prisma-probleem laat dit perfect zien. We hebben momenteel verwijzingen naar Prisma verspreid over honderden bestanden. Dat zorgt voor enorme koppeling en maakt technologische veranderingen onbetaalbaar. We voelen nu de pijn bij het upgraden van Prisma naar v6.16. Iets dat gewoon een lokale refactor achter afgeschermde repositories had moeten zijn, is een kronische, bijna eindeloze zoektocht naar issues over meerdere apps geworden.
De norm vanaf nu:
-
Alle database-toegang moet via Repository-klassen lopen. We hebben hier al een mooie voorsprong op.
-
Repositories zijn de enige code die iets weet van Prisma (of een andere ORM). Daarin hoort geen logica te zitten.
-
Repositories worden geïnjecteerd via Dependency Injection-containers
-
Als we ooit overstappen van Prisma naar Drizzle of een andere ORM, zijn dit de enige vereiste wijzigingen:
-
Implementaties van repositories
-
Bekabeling van de DI-container voor nieuwe repositories
-
De rest van de codebase hoeft zich nergens om te bekommeren en hoeft niet te veranderen
-
Dit is niet theoretisch. Zo bouwen we onderhoudbare systemen.
Data Transfer Objects (DTO's)
Databasetypes mogen niet lekken naar de frontend. Dit is een populaire shortcut in onze tech stack geworden, maar het is een code smell die meerdere problemen veroorzaakt.
-
Technologische koppeling (Prisma-types belanden in React-componenten)
-
Beveiligingsrisico's (per ongeluk lekken van gevoelige velden)
-
Breekbare contracten tussen server en client (dit is vooral problematisch terwijl we veel meer API's bouwen)
-
Onvermogen om het databaseschema onafhankelijk te laten evolueren
-
Alle DTO-conversies verlopen via Zod, zelfs voor een API-response, om ervoor te zorgen dat alle data wordt gevalideerd voordat die naar de gebruiker wordt gestuurd. Liever falen dan iets verkeerds teruggeven.
De norm vanaf nu:
Maak expliciete DTO's op elke architecturale grens.
-
Datalaag → applicatielaag → API: Transformeer databasemodellen naar DTO's in de applicatielaag en transformeer vervolgens applicatie-DTO's naar API-specifieke DTO's
-
API → applicatielaag → datalaag: Transformeer API-DTO's via de applicatielaag naar data-specifieke DTO's
Ja, dit vereist meer code. Ja, het is de moeite waard. Expliciete grenzen voorkomen de architecturale erosie die op de lange termijn onderhoudsnachtmerries veroorzaakt.
Domain-Driven Design-patronen
De volgende patronen moeten correct en consistent worden gebruikt:
-
Application Services
- Orkestreren use-cases en coördineren tussen domeinservices en repositories
-
Domain Services
- Bevatten bedrijfslogica die niet natuurlijk bij één entiteit hoort
-
Repositories
- Abstracteren datatoegang en isoleren technologiekeuzes
-
Dependency Injection
- Maakt losse koppeling mogelijk, vergemakkelijkt testen, isoleert verantwoordelijkheden
-
Caching Proxies
-
Omhullen repositories of services om cachinggedrag transparant toe te voegen
-
Niet de enige manier om caching te doen, natuurlijk, maar wel een mooi startpunt
-
-
Decorators
- Voegen cross-cutting concerns toe (logging, metrics, enz.) zonder domeinlogica te vervuilen
Consistentie van de codebase
Onze codebases moeten aanvoelen alsof één persoon ze heeft geschreven. Dit niveau van consistentie vereist strikte naleving van vastgelegde patronen, uitgebreide lintregels die architecturale standaarden afdwingen, code reviews die patroonfouten afwijzen + de hulp van AI-code reviewers.
Zet conditionals aan het begin van de applicatie
If-statements horen aan het begin, niet verspreid door je services. Dit is een van de belangrijkste architecturale principes om schone, gefocuste code te behouden die niet ontaardt in onbeheerste complexiteit.
Zo gaat code in de loop van de tijd achteruit: een service wordt geschreven voor een duidelijk, specifiek doel. De logica is schoon en gefocust. Dan komt er een nieuwe producteis, en iemand voegt een if-statement toe. Een paar jaar en meerdere eisen later staat die service vol conditionele checks voor verschillende scenario's. De service is nu:
-
Complex en lastig te lezen
-
Moeilijk te begrijpen en te beredeneren
-
Gevoeliger voor bugs
-
In strijd met single responsibility (te veel verschillende gevallen afhandelen)
-
Bijna onmogelijk om grondig te testen
De service is buiten zijn boekje gegaan qua verantwoordelijkheden en logica.
Een oplossing: Factory Pattern met gespecialiseerde services
Gebruik het factory pattern om beslissingen aan het begin te nemen en geef daarna door aan gespecialiseerde services die hun eigen logica afhandelen zonder conditionals.
Voorbeeld uit onze codebase:
De BillingPortalServiceFactory bepaalt of facturatie voor een organisatie, team of individuele gebruiker is, en geeft daarna de juiste service terug:
export class BillingPortalServiceFactory {
  static async createService(teamId: number): Promise<BillingPortalService> {
    const team = await teamRepository.findById({ id: teamId });
    if (!team) {
      throw new Error("Team not found");
    }
    // Decision made HERE at the entry point
    if (team.isOrganization) {
      return new OrganizationBillingPortalService();
    }
    return new TeamBillingPortalService();
  }

  static createUserService(): UserBillingPortalService {
    return new UserBillingPortalService();
  }
}
Elke service behandelt vervolgens zijn eigen logica zonder te hoeven checken "ben ik een org of een team?":
// OrganizationBillingPortalService handles ONLY organization logic
class OrganizationBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "organization.manageBilling",  // Organization-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more organization-specific logic
}

// TeamBillingPortalService handles ONLY team logic
class TeamBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "team.manageBilling",  // Team-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more team-specific logic
}
Waarom dit belangrijk is
-
Services blijven gefocust
- Elke service heeft één verantwoordelijkheid en hoeft niets te weten over andere contexten. De
OrganizationBillingPortalServicebevat geen if-statements die controleren opif (isTeam)ofif (isUser). Hij weet alleen hoe hij organisaties moet afhandelen.
- Elke service heeft één verantwoordelijkheid en hoeft niets te weten over andere contexten. De
-
Wijzigingen blijven geïsoleerd
- Wanneer je de afrekenlogica voor organisaties moet aanpassen, raak je alleen
OrganizationBillingPortalServiceaan. Je loopt niet het risico de afrekening voor teams of gebruikers te breken. Je hoeft niet door geneste conditionals te sporen om uit te zoeken welk pad je code neemt.
- Wanneer je de afrekenlogica voor organisaties moet aanpassen, raak je alleen
-
Testen is eenvoudig
- Test elke service onafhankelijk met de specifieke scenario’s. Geen nood om elke combinatie van conditionals over verschillende contexten heen te testen.
-
Nieuwe vereisten vervuilen bestaande code niet
- Bijvoorbeeld: wanneer je enterprise-billing met andere regels moet toevoegen, maak je
EnterpriseBillingPortalServiceaan. De factory krijgt één extra conditional, maar bestaande services blijven onaangetast en gefocust.
- Bijvoorbeeld: wanneer je enterprise-billing met andere regels moet toevoegen, maak je
Hoe je dit bereikt
-
Duw conditionals omhoog naar controllers, factories of routeringslogica. Laat deze toegangspunten beslissen welke service gebruikt wordt.
-
Houd services puur en gefocust op één verantwoordelijkheid. Als een service moet checken "welk type ben ik?", heb je waarschijnlijk meerdere services nodig.
-
Geef de voorkeur aan polymorfisme boven conditionals
- Interfaces definiëren het contract. Concrete implementaties leveren de details.
-
Let op opstapeling van if-statements
- Zie je tijdens code review dat een service conditionals krijgt voor verschillende scenario’s, dan is dat een signaal om te refactoren naar gespecialiseerde services.
API-ontwerp: dunne controllers en HTTP-abstrahering
-
Controllers zijn dunne lagen die alleen HTTP-zaken afhandelen.
- Ze nemen requests aan, verwerken ze en mappen data naar DTO's die worden doorgegeven aan de kernlogica van de applicatie. Vanaf nu hoort er geen applicatie- of kernlogica meer zichtbaar te zijn in API-routes of tRPC-handlers.
-
We moeten HTTP-technologie loskoppelen van onze applicatie.
- De manier waarop we data tussen client en server overdragen (REST, tRPC, enz.) mag geen invloed hebben op hoe onze kernapplicatie werkt. HTTP is een leveringsmechanisme, geen architectuurdrijver.
Verantwoordelijkheden van controllers (en ALLEEN deze):
-
Binnenkomende requests ontvangen en valideren
-
Data uit requestparameters, body en headers halen
-
Requestdata omzetten naar DTO's
-
De juiste applicatieservices aanroepen met die DTO's
-
Antwoorden van applicatieservices omzetten naar response-DTO's
-
HTTP-responses teruggeven met de juiste statuscodes
Controllers mogen NIET:
-
Businesslogica of domeinregels bevatten
-
Direct databases of externe services benaderen
-
Complexe datatransformaties of berekeningen uitvoeren
-
Beslissingen nemen over wat de applicatie moet doen
-
Op de hoogte zijn van implementatiedetails van het domein
Voorbeeld van het dunne-controllerpatroon:
// Good: Thin controller
export async function createBookingHandler(req: Request, res: Response) {
  // Extract and validate request data
  const createBookingRequest = validateCreateBookingRequest(req.body);
  // Transform to DTO
  const createBookingDto = {
    userId: req.user.id,
    eventTypeId: createBookingRequest.eventTypeId,
    startTime: createBookingRequest.startTime,
    // ... other fields
  };
  // Delegate to application service
  const result = await bookingApplicationService.createBooking(createBookingDto);
  // Transform response and return
  const responseDto = mapBookingToResponseDto(result);
  res.status(201).json(responseDto);
}

// Bad: Fat controller with business logic
export async function createBookingHandler(req: Request, res: Response) {
  // This is wrong - business logic in controller
  if (req.body.startTime < new Date()) {
    return res.status(400).json({ error: "Cannot book in the past" });
  }

  // This is wrong - direct database access
  const existingBooking = await prisma.booking.findFirst({
    where: { eventTypeId: req.body.eventTypeId, startTime: req.body.startTime }
  });

  // This is wrong - complex business calculations
  const duration = calculateBookingDuration(req.body.eventTypeId);
  // ... more business logic
}
API-versiebeheer en breaking changes
Geen breaking changes. Dit is cruciaal. Zodra een API-endpoint openbaar is, moet het stabiel blijven. Breaking changes vernietigen het vertrouwen van ontwikkelaars en zorgen voor integratienachtmerries voor onze gebruikers.
Strategieën om breaking changes te vermijden:
-
Voeg nieuwe velden altijd als optioneel toe
-
Gebruik API-versiebeheer wanneer je bestaand gedrag moet wijzigen
-
Deprecate oude endpoints op een nette manier met duidelijke migratiepaden
-
Behoud achterwaartse compatibiliteit voor minstens twee majorversies
Wanneer je toch breaking changes moet maken:
-
Maak een nieuwe API-versie aan met de datum-specifieke versioning in API v2 (misschien kijken we later ook nog naar de benoemde versioning die Stripe onlangs introduceerde)
-
Draai beide versies tegelijk tijdens de overgang (dat doen we in API v2 al)
-
Bied waar mogelijk geautomatiseerde migratietools aan
-
Geef gebruikers ruim de tijd om te migreren (minimaal 6 maanden voor publieke API's)
-
Documenteer precies wat er is veranderd en waarom
Prestaties en algoritmische complexiteit
We bouwen voor grote organisaties en teams. Wat prima werkt met 10 gebruikers of 50 records kan instorten onder de zwaarte van enterprise-schaal. Prestaties zijn geen iets wat we later optimaliseren. Ze zijn iets wat we vanaf het begin goed bouwen.
Denk vanaf dag één aan schaal
Wanneer je functies bouwt, vraag altijd: "Hoe gedraagt dit zich met 1.000 gebruikers? 10.000 records? 100.000 bewerkingen?" Het verschil tussen O(n) en O(n²)-algoritmen is misschien nauwelijks merkbaar in ontwikkeling, maar rampzalig in productie.
Veelvoorkomende O(n²)-patronen om te vermijden:
-
Geneste array-iteraties (
.mapbinnen.map,.forEachbinnen.forEach) -
Array-methoden zoals
.some,.findof.filterbinnen loops of callbacks -
Elk item met elk ander item vergelijken zonder optimalisatie
-
Geketende filters of geneste mapping over grote lijsten
Praktijkvoorbeeld: Voor 100 beschikbare slots en 50 bezette periodes voert een O(n²)-algoritme 5.000 controles uit. Schaal dat op naar 500 slots en 200 bezette periodes, en je doet 100.000 bewerkingen. Dat is een toename van 20x in rekenlast voor maar een 5x toename in data.
Kies de juiste datastructuren en algoritmen
De meeste prestatieproblemen los je op door betere datastructuren en algoritmen te kiezen:
-
Sorteren + vroeg stoppen: sorteer je data één keer en breek vervolgens uit loops zodra je weet dat de resterende items geen match zullen zijn
-
Binaire zoekactie: gebruik binary search voor opzoekingen in gesorteerde arrays in plaats van lineaire scans
-
Tweepijlertechnieken: voor het samenvoegen of kruisen van gesorteerde reeksen loop je met pointers door beide heen in plaats van geneste loops
-
Hashmaps/sets: gebruik objecten of Sets voor O(1)-opzoekingen in plaats van
.findof.includesop arrays -
Interval trees: gebruik voor planning, beschikbaarheid en range queries de juiste boomstructuren in plaats van brute-force vergelijkingen
Voorbeeldtransformatie:
// Bad: O(n²) - checks every slot against every busy time
availableSlots.filter(slot => {
  return !busyTimes.some(busy => checkOverlap(slot, busy));
});

// Good: O(n log n) - sort once, break early
const sortedBusy = [...busyTimes].sort((a, b) => a.start - b.start);
availableSlots.filter(slot => {
  for (const busy of sortedBusy) {
    if (busy.start >= slot.end) break; // No more overlaps possible
    if (busy.end <= slot.start) continue; // This one doesn't overlap
    return false; // Overlap found
  }
  return true;
});
Geautomatiseerde prestatiecontroles
We gaan meerdere verdedigingslagen implementeren tegen prestatieregressies:
Lintregels die signaleren:
-
Functies met geneste loops of geneste array-methoden
-
Meerdere geneste
.some,.findof.filter-aanroepen -
Recursie zonder memoization
-
Bekende anti-patronen voor ons domein (planning, beschikbaarheidscontroles, enz.)
Prestatiebenchmarks in CI die:
-
Kritieke algoritmen uitvoeren op realistische data op grote schaal
-
Uitvoeringstijden bij elke PR vergelijken met de baseline
-
Merges blokkeren die prestatieregressies introduceren
-
Testen met data op enterpriseniveau (duizenden gebruikers, tienduizenden records)
Productiemonitoring die:
-
Uitvoeringstijd voor kritieke paden bijhoudt
-
Waarschuwt wanneer algoritmen trager worden naarmate data groeit
-
Regressies opvangt voordat gebruikers het merken
-
Praktische prestatiegegevens levert om optimalisaties te sturen
Prestaties zijn een functie
Prestatie is niet optioneel. Het is niet iets wat we "later wel doen." Voor enterpriseklanten die over grote teams heen boeken, betekenen trage reacties verlies aan productiviteit en gefrustreerde gebruikers (onze ervaring met sommige grotere enterpriseklanten kan daarvan getuigen).
Elke engineer zou:
-
Profiel je code voordat je optimaliseert, maar denk vanaf het begin na over complexiteit
-
Test met realistische data op grote schaal (niet alleen 5 testrecords). We hebben al seed-scripts gebouwd. We moeten die waarschijnlijk uitbreiden.
-
Kies vooraf efficiënte algoritmen en datastructuren
-
Let op geneste iteraties in code review
-
Vraag elk algoritme in twijfel dat schaalt met het product van twee variabelen
De NP-harde realiteit van planning
Planningsproblemen zijn van nature NP-hard. Dat betekent dat naarmate het aantal beperkingen, deelnemers of tijdslots groeit, de computationele complexiteit exponentieel kan exploderen. De meeste optimale planningsalgoritmen hebben in het slechtste geval een exponentiële tijdscomplexiteit, waardoor de keuze van het algoritme absoluut cruciaal is.
Implicaties in de praktijk:
-
Het vinden van het optimale vergadermoment voor 10 mensen over 3 tijdzones met individuele beschikbaarheidsbeperkingen is computationeel kostbaar
-
Het toevoegen van conflictdetectie, buffers en een hele reeks andere opties vergroot het probleem enorm
-
Slechte algoritmekeuzes die prima werken voor kleine teams, worden volledig onbruikbaar voor grote organisaties
-
Wat voor 5 gebruikers milliseconden kost, kan voor organisaties vele seconden duren
Strategieën om NP-harde complexiteit te beheersen:
-
Gebruik benaderingsalgoritmen die snel "goed genoeg"-oplossingen vinden in plaats van perfecte oplossingen langzaam
-
Implementeer agressieve caching van berekende planningen en beschikbaarheid
-
Bereken veelvoorkomende scenario's vooraf tijdens daluren
-
Splits grote planningsproblemen op in kleinere, beter beheersbare stukken
-
Stel redelijke time-outlimieten in en val terug op eenvoudigere algoritmen wanneer dat nodig is
Daarom is performance in planningssoftware niet zomaar een nice-to-have. Het is de basis die bepaalt of je systeem kan opschalen naar enterprisebehoeften of instort onder gebruikspatronen uit de praktijk.
Vereisten voor code coverage
-
Globale coverage-tracking
- We volgen de totale coverage van de codebase als een belangrijke metriek die in de loop van de tijd verbetert. Dat geeft ons inzicht in onze testvolwassenheid en helpt gebieden te identificeren die aandacht nodig hebben. Het globale coveragepercentage wordt prominent weergegeven in onze dashboards.
-
80%+ coverage voor nieuwe code
- Elke PR moet bijna 80%+ testcoverage hebben voor de code die wordt toegevoegd of aangepast. Dit wordt automatisch afgedwongen in onze CI-pipeline. Als je 50 regels nieuwe code toevoegt, moeten die 50 regels door tests gedekt zijn. Als je een bestaande functie wijzigt, moeten je wijzigingen getest worden. Dit is de totale testcoverage. Unit test coverage moet bijna 100% zijn, zeker omdat je AI kunt inzetten om deze te helpen genereren.
Het argument "coverage vertelt niet het hele verhaal" beantwoorden: Ja, we weten dat coverage geen perfecte tests garandeert. We weten dat je zinloze tests kunt schrijven die elke regel raken maar niets betekenisvols testen. We weten dat coverage slechts één metriek is tussen vele. Maar het is zeker beter om naar een hoog percentage te streven dan helemaal geen idee te hebben waar je staat.
Succes meten
-
"Velocity" (geleend van Scrum, ook al gaan we Scrum niet gebruiken)
- Voortdurende groei in maandelijkse statistieken (features, verbeteringen, refactors)
-
Kwaliteit
- Verminder de PR-inspanning die aan fixes wordt besteed van de huidige 35% naar 20% of lager tegen eind 2026 (berekend op basis van bestandswijzigingen en toevoegingen/verwijderingen)
-
Architecturale gezondheid
- Metrieken voor naleving van patronen, technologische koppeling, schendingen van grenzen
-
Reviewefficiëntie
- Kleinere PR's, snellere reviews, minder feedbackrondes
-
Beschikbaarheid van applicatie en API
- Hoe dicht zitten we bij 99.99%?