Ingeniería en 2026 y más allá
Estamos construyendo una infraestructura que casi nunca debe fallar. Para conseguirlo, avanzamos rápido mientras lanzamos software de una calidad increíble, sin atajos ni compromisos. Este documento describe los estándares de ingeniería que nos guiarán a lo largo de 2026 y más allá.
On this page
- Estructura del equipo
- Nuestros resultados hasta ahora
- La base de Cal.com permite la excelencia para coss.com
- Principios fundamentales
- 1. No posponer la calidad
- 2. Altos estándares en la revisión de código
- 3. Empujarnos unos a otros a hacer lo correcto
- 4. Busca la simplicidad
- 5. Automatiza todo
- Estándares arquitectónicos
- Vertical Slice Architecture: packages/features
- Por qué importan las vertical slices
- Directrices para organizar las funcionalidades
- Beneficios
- Patrón Repository e Inyección de Dependencias
- Objetos de transferencia de datos (DTOs)
- Patrones de Domain-Driven Design
- Consistencia de la codebase
- Mueve los condicionales al punto de entrada de la aplicación
- Por qué esto importa
- Cómo conseguirlo
- Diseño de API: controladores ligeros y abstracción HTTP
- Versionado de API y cambios incompatibles
- Rendimiento y complejidad algorítmica
- Piensa en la escala desde el primer día
- Elige las estructuras de datos y los algoritmos adecuados
- Comprobaciones automáticas de rendimiento
- El rendimiento es una funcionalidad
- La realidad NP-hard de la planificación
- Requisitos de cobertura de código
- Medir el éxito
Estructura del equipo
Nuestra organización de ingeniería consta de cinco equipos principales, cada uno con responsabilidades distintas:
-
Equipo Foundation: Se centra en establecer y mantener los estándares de código y los patrones arquitectónicos. Este equipo trabaja en colaboración con otros equipos para establecer las mejores prácticas en toda la organización.
-
Consumer, Enterprise, and Platform Teams: Equipos centrados en el producto que lanzan funciones rápidamente mientras mantienen los estándares de calidad establecidos en este documento. Estos equipos demuestran que la velocidad y la calidad no se excluyen mutuamente.
-
Equipo Community: Responsable de revisar rápidamente los PRs de la comunidad open source, dar feedback y acompañar ese trabajo hasta que se mergee. Este equipo se asegura de que quienes contribuyen al open source tengan una gran experiencia y de que sus aportaciones cumplan nuestros estándares de calidad. Mantener una fuerte cultura open-source sigue dando forma a cómo Cal.com aborda la colaboración en ingeniería y el desarrollo de producto.
Nuestros resultados hasta ahora
Los datos hablan por sí solos. En los últimos un año y medio, hemos transformado de forma radical cómo construimos software:

Hemos aproximadamente duplicado nuestra producción de ingeniería al mismo tiempo que mejorábamos la calidad. Aún más impresionante es el cambio en lo que estamos construyendo:

Hemos reasignado con éxito aproximadamente un 20 % del esfuerzo de ingeniería lejos de las correcciones y hacia funcionalidades, mejoras de rendimiento, refactors y tareas menores. Este cambio demuestra que invertir en calidad y arquitectura no te ralentiza. Te acelera.
La base de Cal.com permite la excelencia para coss.com
-
Cal.com es un negocio estable y rentable que seguiremos haciendo crecer.
- Este éxito nos da una ventaja única mientras construimos coss.com. A diferencia de los primeros días de Cal.com, cuando necesitábamos avanzar rápido para conseguir encaje producto-mercado y construir un negocio sostenible, coss.com parte desde una posición de fuerza.
-
No necesitamos correr con coss.com.
- La estabilidad de Cal.com significa que podemos permitirnos construir coss.com bien desde el primer día. Tenemos el lujo de aplicar estos estándares de ingeniería sin la presión de unas demandas inmediatas del mercado ni de limitaciones de financiación. Es una posición de partida fundamentalmente distinta.
-
La "lentitud" es una inversión, no un coste.
- Sí, seguir estos estándares puede parecer más lento al principio e incluso puede frustrar a algunos ingenieros. Escribir DTOs lleva más tiempo que pasar tipos de base de datos directamente al frontend. Crear abstracciones adecuadas e inyección de dependencias requiere más diseño previo. Mantener una cobertura de tests del 80 % o más para el nuevo código exige disciplina. Pero esta aparente lentitud es temporal, y el beneficio es exponencial.
Piensa en los retornos compuestos...
-
El código que está bien arquitecturado desde el principio no necesita grandes refactors después
-
Una alta cobertura de tests evita bugs que, de otro modo, consumirían semanas de depuración y hotfixes (ver 2023 a mediados de 2024)
-
Las abstracciones adecuadas hacen que añadir nuevas funcionalidades sea drásticamente más rápido con el tiempo
-
Las fronteras limpias y los DTOs evitan la erosión arquitectónica que con el tiempo exige reescrituras completas
La trayectoria de Cal.com muestra lo que pasa cuando optimizas para la velocidad inmediata. Una velocidad inicial alta que se degrada poco a poco a medida que se acumula la deuda técnica, los atajos arquitectónicos crean cuellos de botella y se dedica cada vez más tiempo a arreglar problemas que a construir funciones (ver el gráfico anterior, donde estábamos gastando entre el 55 y el 60 % del esfuerzo de ingeniería en correcciones).
La trayectoria de coss.com adoptará el poder de construir bien desde el primer día. Un poco menos de velocidad al principio mientras se establecen patrones correctos, seguida de una aceleración exponencial a medida que esos patrones dan frutos y permiten un desarrollo más rápido con mayor confianza.
Principios fundamentales
1. No posponer la calidad
-
Minimizaremos el "lo dejo para un PR de seguimiento" en los pequeños refactors.
- Los PRs de seguimiento para mejoras menores rara vez llegan a materializarse. En lugar de eso, se acumulan como deuda técnica que nos lastra meses o años después. Si un pequeño refactor se puede hacer ahora, hazlo ahora. Los seguimientos deben reservarse para cambios sustanciales que realmente justifiquen PRs separados o para casos excepcionales y urgentes.
2. Altos estándares en la revisión de código
-
No dejes pasar PRs con muchos detalles menores solo para evitar ser "la persona mala".
- Así es precisamente como los codebases se vuelven chapuceros con el tiempo. La revisión de código no va de ser amable. Va de mantener los estándares de calidad que exige nuestra infraestructura. Cada detalle importa. Cada violación de patrón importa. Corrígelos antes de mergear, no después.
3. Empujarnos unos a otros a hacer lo correcto
-
Nos responsabilizamos mutuamente por la calidad
- Recortar por lo sano puede parecer más rápido en el momento, pero crea problemas que luego ralentizan a todo el mundo. Cuando veas a un compañero a punto de mergear un PR con problemas evidentes, dilo. Cuando alguien sugiera un apaño rápido en lugar de la solución adecuada, opónte. Cuando te tiente saltarte tests o ignorar patrones arquitectónicos, espera que tus compañeros te cuestionen.
-
No se trata de ser difícil ni de frenar a la gente
- Se trata de la propiedad colectiva de nuestro codebase y de nuestra reputación. Cada atajo que toma una persona se convierte en un problema para todos. Cada esquina recortada hoy significa más sesiones de depuración, más hotfixes y más clientes frustrados mañana.
-
Haz normal cuestionar decisiones malas, con respeto
- Si alguien dice "vamos a hardcodear esto por ahora", la respuesta esperada debería ser "¿qué haría falta para hacerlo bien a la primera?". Si alguien quiere commitear código sin tests, el equipo debería oponerse. Si alguien sugiere copiar y pegar en lugar de crear una abstracción adecuada, señálalo con respeto.
-
Estamos construyendo algo que casi nunca debe fallar
- Ese nivel de fiabilidad no ocurre por casualidad. Ocurre cuando cada ingeniero se siente responsable de la calidad, no solo de su propio código sino de todo el sistema. Salimos adelante como equipo o fracasamos como equipo.
4. Busca la simplicidad
-
Prioriza la claridad sobre la brillantez
- El objetivo es un código fácil de leer y de entender rápidamente, no una complejidad elegante. Los sistemas simples reducen la carga cognitiva de cada ingeniero.
-
Hazte las preguntas correctas
-
¿Estoy resolviendo de verdad el problema que tengo delante?
-
¿Estoy pensando demasiado en posibles casos de uso futuros?
-
¿He considerado al menos otra alternativa para resolver esto? ¿Cómo se compara?
-
-
Simple no significa carente de funciones
- Solo porque nuestro objetivo sea crear sistemas simples, esto no significa que deban parecer anémicos y faltarles funcionalidades obvias.
5. Automatiza todo
-
Aprovecha la IA
-
Genera el 80% del código repetitivo y no crítico usando IA, lo que nos permite centrarnos únicamente en la lógica empresarial compleja y en arquitecturas críticas. Los Teams que adoptan flujos de trabajo modernos asistidos por IA recurren cada vez más a herramientas como los mejores servidores MCP para mejorar la productividad y la orquestación de los desarrolladores.
-
Crea alertas sin ruido y un manejo inteligente de errores.
-
Las pruebas manuales son cada vez más cosa del pasado. La IA puede construir para nosotros suites de tests enormes de forma rápida e inteligente.
-
-
Nuestro CI es el jefe final
-
Todo lo que aparece en este documento de estándares se comprueba antes de que el código se mergee en los PRs
-
No entra ninguna sorpresa en main
-
Las comprobaciones son rápidas y útiles
-
Estándares arquitectónicos
Estamos pasando a un modelo arquitectónico estricto basado en Vertical Slice Architecture y Domain-Driven Design (DDD). Los siguientes patrones y principios se aplicarán con rigor en las revisiones de PRs y mediante linting.
Vertical Slice Architecture: packages/features
Nuestro codebase está organizado por dominio, no por capa técnica. El directorio packages/features es el corazón de este enfoque arquitectónico. Cada carpeta dentro representa una vertical slice completa de la aplicación, impulsada por el dominio al que da servicio.
Estructura:
packages/features/
  availability/
  bookings/
  ooo/
  payments/
  routing/
  scheduling/
  ...
Cada carpeta de feature es una vertical slice autosuficiente que incluye todo lo necesario para ese dominio:
-
Lógica de dominio: Las reglas de negocio y entidades principales específicas de esa feature
-
Servicios de aplicación: Orquestación de casos de uso para ese dominio
-
Repositorios: Acceso a datos específico de las necesidades de esa feature
-
DTOs: Objetos de transferencia de datos para cruzar fronteras
-
Componentes de UI: Componentes de frontend relacionados con esta feature (cuando aplique)
-
Tests: Tests unitarios, de integración y e2e para esta feature
Por qué importan las vertical slices
La arquitectura tradicional por capas organiza según preocupaciones técnicas:
// Bad: Organized by layer
src/
  controllers/
    AvailabilityController.ts
    BookingController.ts
    OOOController.ts
  services/
    AvailabilityService.ts
    BookingService.ts
    OOOService.ts
  repositories/
    AvailabilityRepository.ts
    BookingRepository.ts
    OOORepository.ts
Esto crea varios problemas:
-
Los cambios en una feature requieren tocar archivos repartidos por múltiples directorios
-
Es difícil entender qué hace una funcionalidad porque su código está fragmentado
-
Los Teams se pisan los talones cuando trabajan en distintas funciones
-
No puedes extraer ni deprecar fácilmente una funcionalidad
La arquitectura de fragmentos verticales organiza por dominio:
// Good: Organized by domain
packages/features/
  availability/
    services/
      AvailabilityApplicationService.ts
      AvailabilityDomainService.ts
    repositories/
      AvailabilityRepository.ts
    dto/
      AvailabilityDto.ts
bookings/
  services/
    BookingApplicationService.ts
    BookingDomainService.ts
  repositories/
    BookingRepository.ts
  dto/
    BookingDto.ts
Esto resuelve estos problemas:
-
Todo lo relacionado con la disponibilidad vive en
packages/features/availability -
Puedes entender toda la funcionalidad de disponibilidad explorando un solo directorio
-
Los Teams pueden trabajar en distintas funciones sin conflictos (si el equipo de ingeniería de Cal.com crece, pero sin duda en coss.com tendremos Teams encargados de paquetes principales)
-
Las funcionalidades están poco acopladas y pueden evolucionar de forma independiente
Directrices para organizar las funcionalidades
En teoría, cada funcionalidad se puede desplegar de forma independiente. Aunque quizá no las despleguemos por separado de verdad, organizarlas así nos obliga a mantener claras las dependencias y el acoplamiento al mínimo. Este es el principio y el éxito de los microservicios, aunque todavía no vayamos a desplegar microservicios.
Las funcionalidades se comunican mediante interfaces bien definidas. Si bookings necesita datos de disponibilidad, los importa desde @calcom/features/availability a través de interfaces exportadas, no entrando en detalles internos de implementación.
El código compartido vive en los lugares adecuados:
-
Utilidades agnósticas al dominio y preocupaciones transversales (auth, logging):
packages/lib -
Piezas UI compartidas:
packages/ui(y pronto coss.com ui)
Los límites del dominio se hacen cumplir automáticamente. Vamos a construir linting que impida entrar en los entresijos internos de funcionalidades a las que no deberías acceder. Si packages/features/bookings intenta importar desde packages/features/availability/services/internal, el linter lo bloqueará. Todas las dependencias entre funcionalidades deben pasar por la API pública de la funcionalidad.
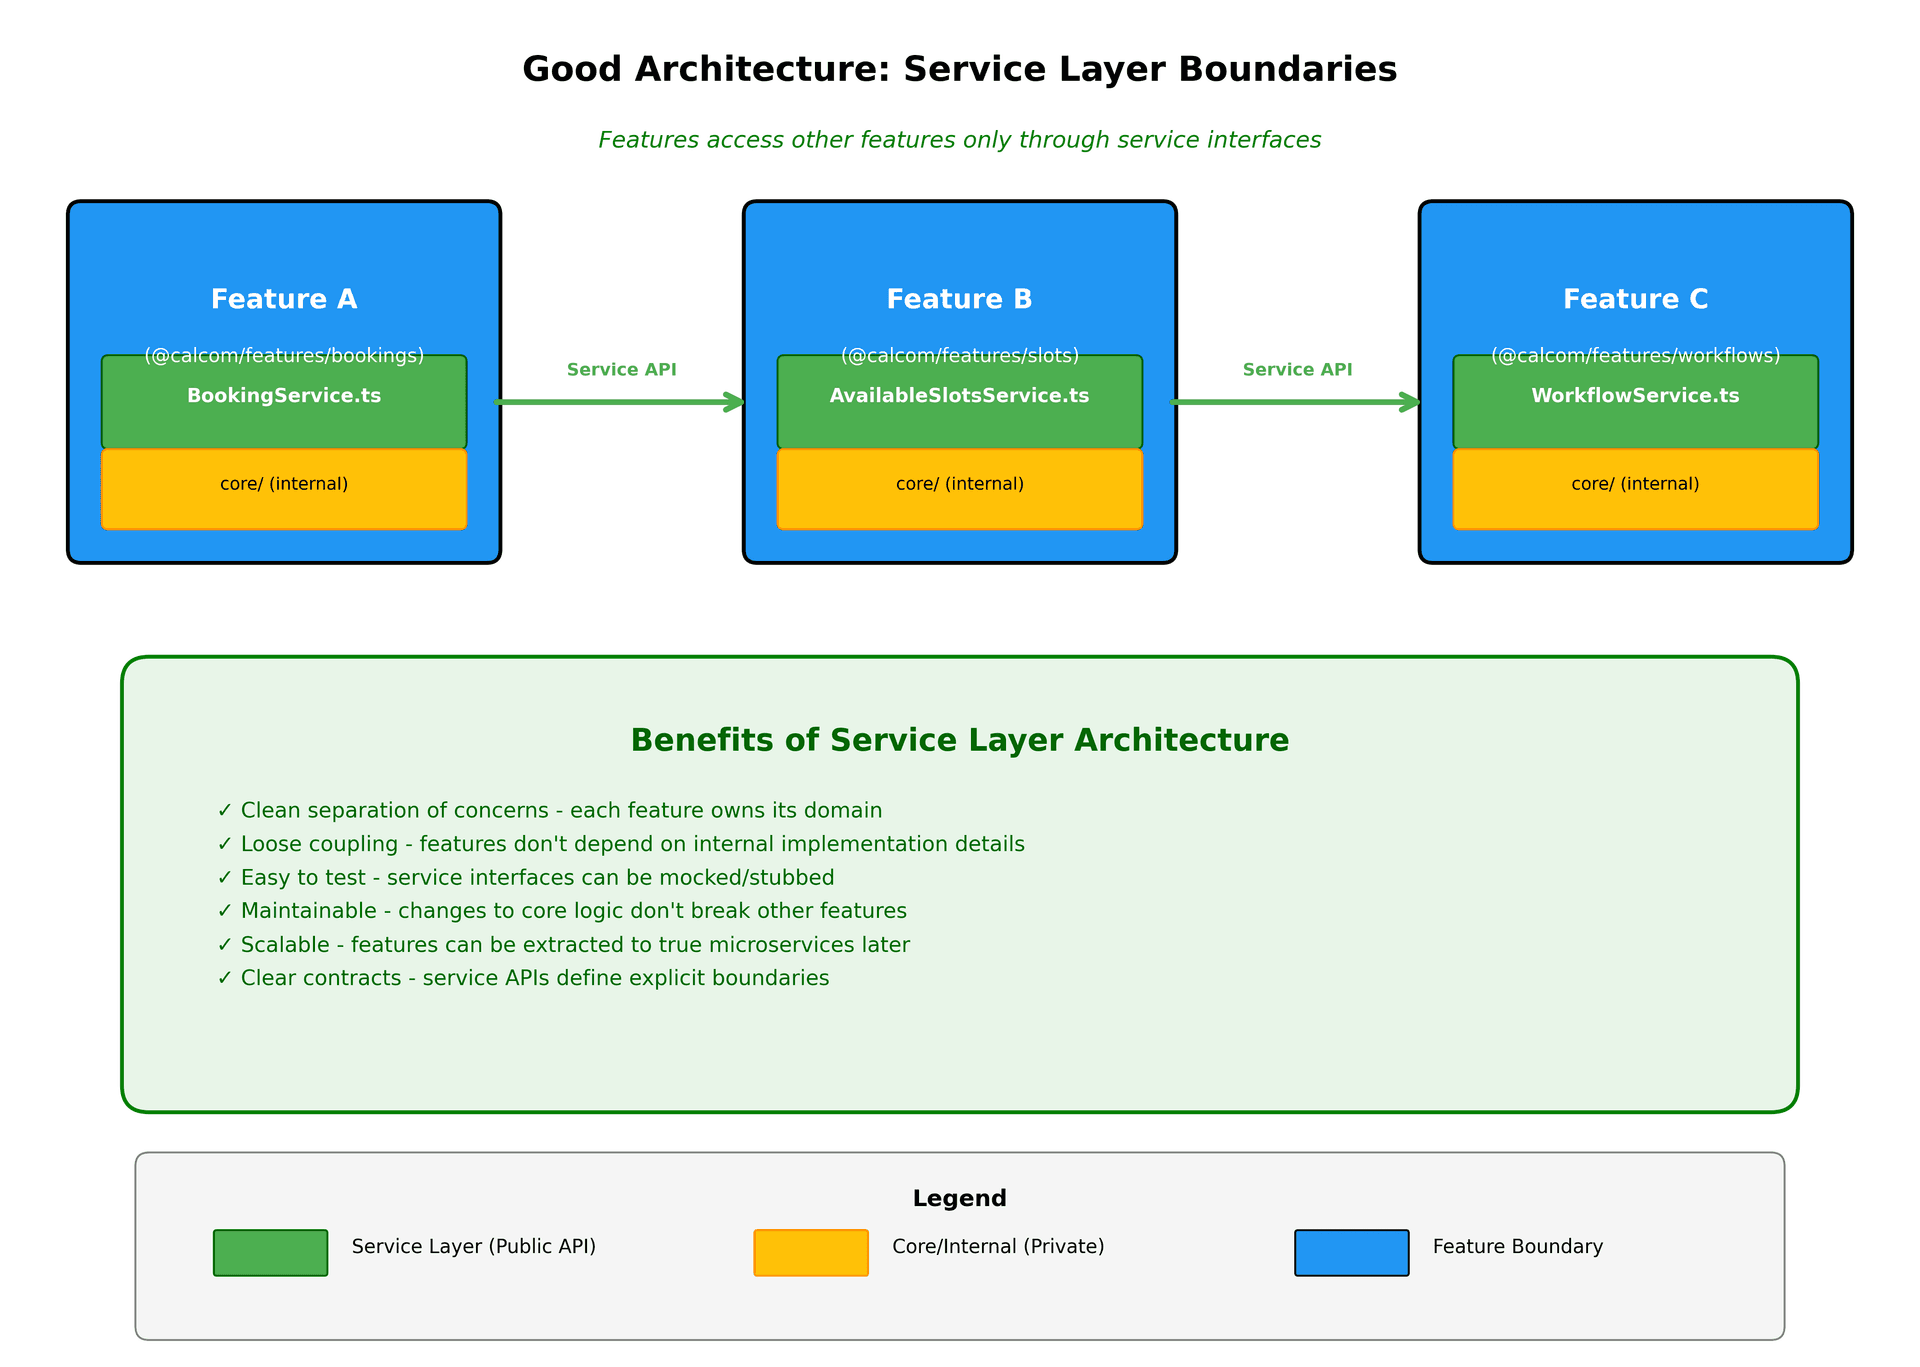
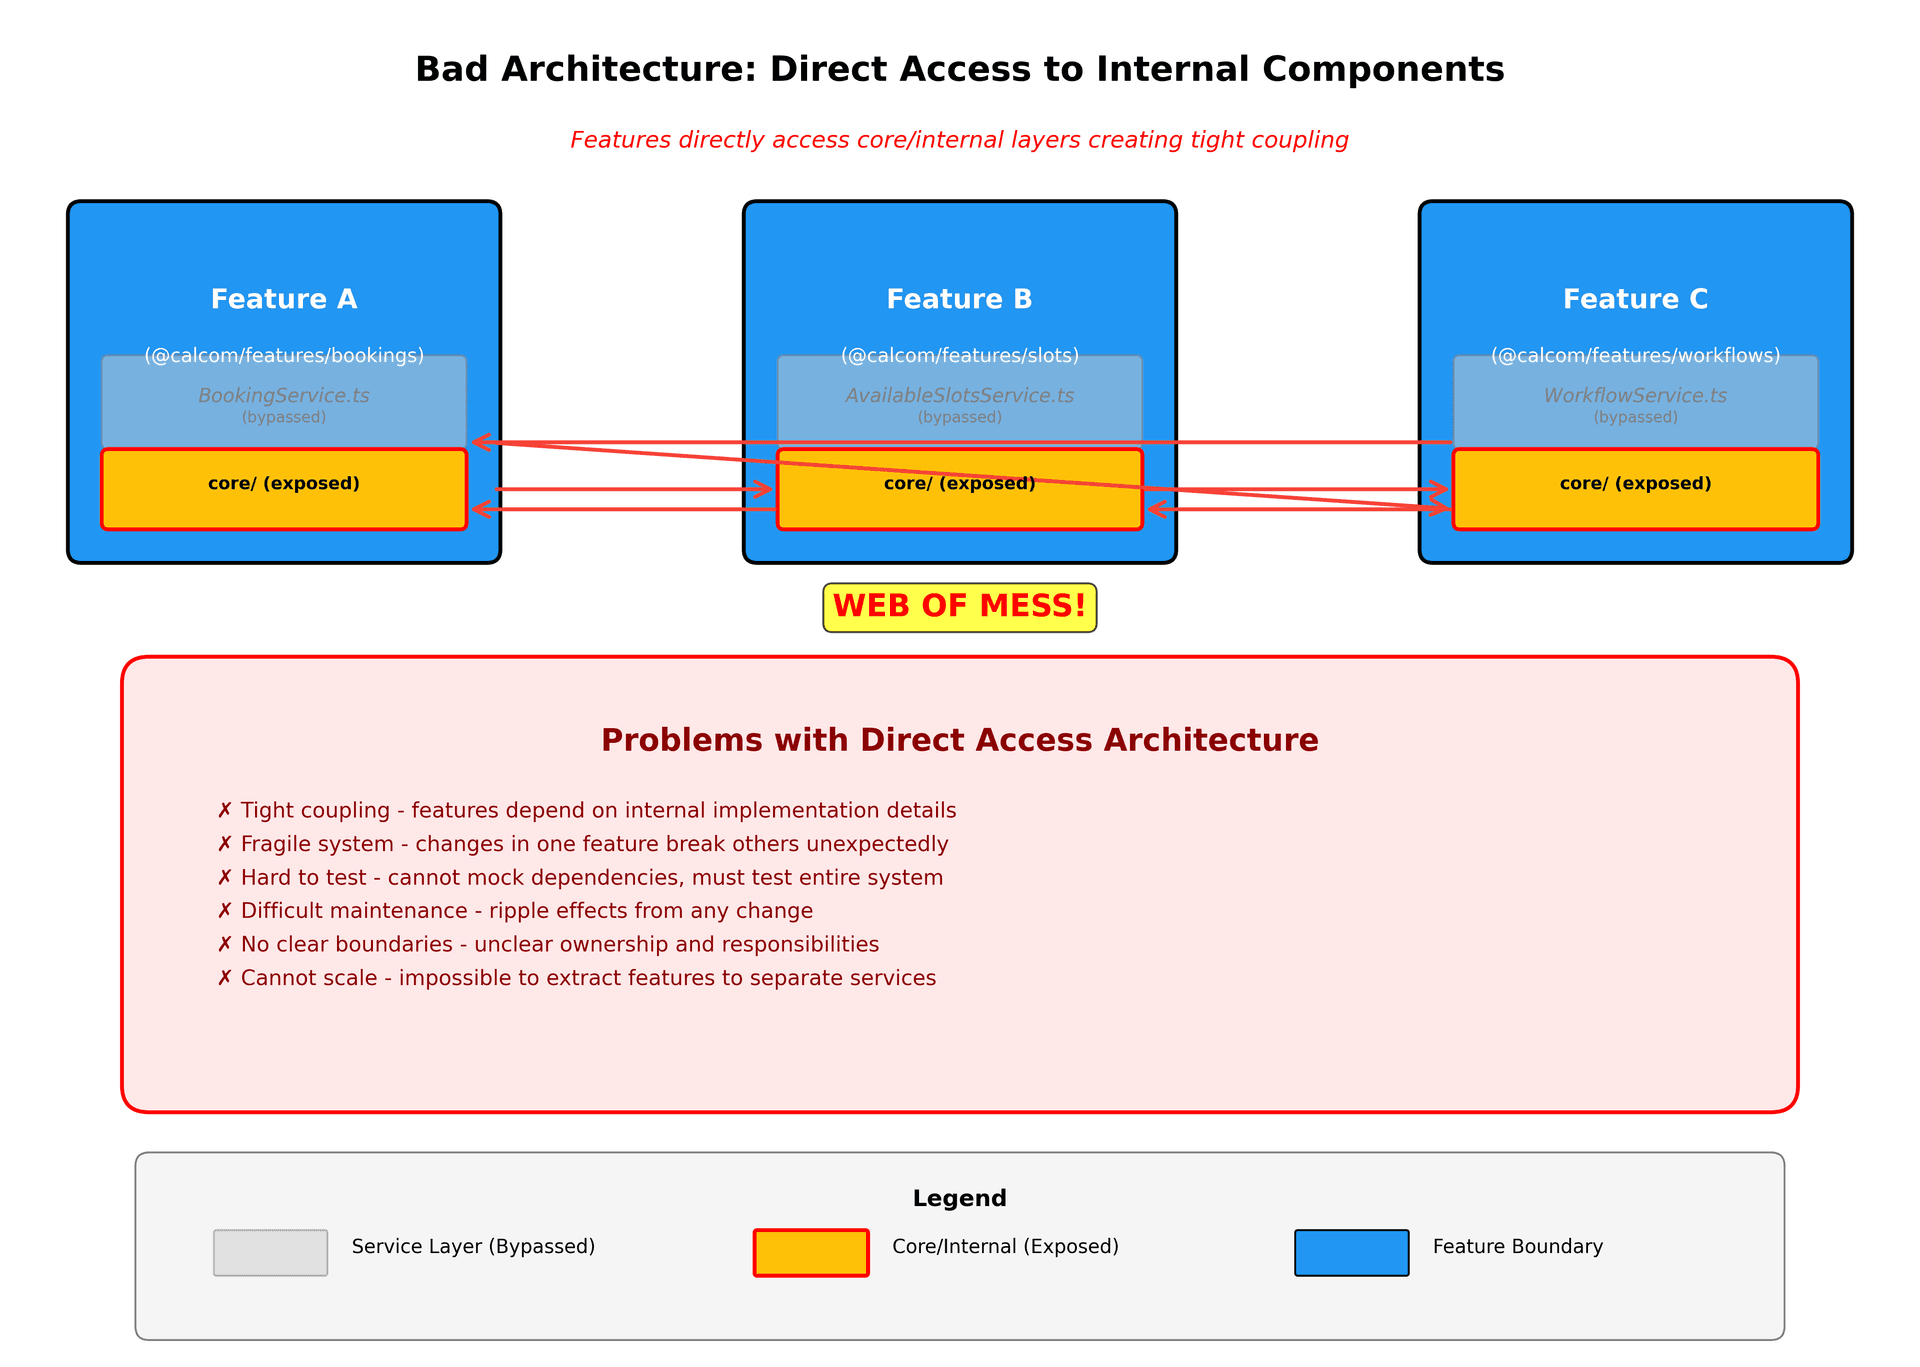
Las nuevas funcionalidades empiezan como fragmentos verticales. Cuando construyas algo nuevo, crea una nueva carpeta en packages/features con el fragmento vertical completo. Así queda claro qué estás construyendo y todo se mantiene organizado desde el primer día.
Beneficios
-
Descubribilidad
- ¿Buscas la lógica de reservas? Está toda en
packages/features/bookings. No hace falta buscar entre controllers, services, repositories y utilities dispersos por toda la codebase.
- ¿Buscas la lógica de reservas? Está toda en
-
Pruebas más fáciles
- Prueba toda la funcionalidad como una unidad. Tienes todas las piezas en un solo sitio, lo que hace que las pruebas de integración sean naturales y sencillas.
-
Dependencias más claras
- Cuando ves
import { getAvailability } from '@calcom/features/availability', sabes exactamente de qué funcionalidad dependes. Cuando las dependencias se vuelven demasiado complejas, se ve claro y se puede solucionar.
- Cuando ves
Patrón Repository e Inyección de Dependencias
Las decisiones tecnológicas no deben filtrarse por toda la aplicación. El problema de Prisma lo ilustra perfectamente. Ahora mismo tenemos referencias a Prisma repartidas por cientos de archivos. Esto genera un acoplamiento enorme y hace que los cambios tecnológicos sean prohibitivamente caros. Estamos notando ese dolor ahora al actualizar Prisma a v6.16. Algo que debería haber sido solo una refactorización localizada detrás de repositorios protegidos ha sido una búsqueda sinuosa y casi interminable de incidencias a través de varias apps.
El estándar a partir de ahora:
-
Todo acceso a la base de datos debe pasar por clases Repository. Ya llevamos una buena ventaja en esto.
-
Los repositories son el único código que sabe sobre Prisma (o cualquier otro ORM). No debería haber lógica en ellos.
-
Los repositories se inyectan mediante contenedores de Dependency Injection
-
Si alguna vez cambiamos de Prisma a Drizzle u otro ORM, los únicos cambios necesarios serán:
-
Implementaciones de Repository
-
Cableado del contenedor DI para los nuevos repositories
-
Nada más en la codebase debería importarle ni cambiar
-
Esto no es teórico. Así es como construimos sistemas mantenibles.
Objetos de transferencia de datos (DTOs)
Los tipos de base de datos no deberían filtrarse al frontend. Esto se ha convertido en un atajo popular en nuestro stack tecnológico, pero es un code smell que crea múltiples problemas.
-
Acoplamiento tecnológico (los tipos de Prisma acaban en componentes de React)
-
Riesgos de seguridad (fuga accidental de campos sensibles)
-
Contratos frágiles entre servidor y cliente (esto es especialmente problemático a medida que construimos muchas más APIs)
-
Incapacidad de evolucionar el esquema de la base de datos de forma independiente
-
Todas las conversiones de DTOs pasan por Zod, incluso para una respuesta de API, para garantizar que todos los datos se validan antes de enviarlos al usuario. Es mejor fallar que devolver algo incorrecto.
El estándar a partir de ahora:
Crea DTOs explícitos en cada frontera arquitectónica.
-
Capa de datos → Capa de aplicación → API: transforma los modelos de base de datos en DTOs de la capa de aplicación y luego transforma los DTOs de aplicación en DTOs específicos de la API
-
API → Capa de aplicación → Capa de datos: transforma los DTOs de la API a través de la capa de aplicación y en DTOs específicos de datos
Sí, esto requiere más código. Sí, merece la pena. Los límites explícitos evitan la erosión arquitectónica que crea pesadillas de mantenimiento a largo plazo.
Patrones de Domain-Driven Design
Los siguientes patrones deben usarse correctamente y de forma consistente:
-
Application Services
- Orquestan casos de uso, coordinan entre domain services y repositories
-
Domain Services
- Contienen lógica de negocio que no pertenece de forma natural a una sola entidad
-
Repositories
- Abstraen el acceso a datos, aíslan las decisiones tecnológicas
-
Dependency Injection
- Permite un acoplamiento débil, facilita las pruebas, aísla las preocupaciones
-
Proxies de caché
-
Envolven repositories o services para añadir comportamiento de caché de forma transparente
-
No es la única forma de hacer caché, por supuesto, pero sí un buen punto de partida
-
-
Decorators
- Añaden preocupaciones transversales (logging, métricas, etc.) sin contaminar la lógica de dominio
Consistencia de la codebase
Nuestras codebases deberían dar la sensación de que las escribió una sola persona. Este nivel de consistencia requiere una adhesión estricta a los patrones establecidos, reglas exhaustivas de linting que hagan cumplir los estándares arquitectónicos, code reviews que rechacen violaciones de patrones y la ayuda de revisores de código con IA.
Mueve los condicionales al punto de entrada de la aplicación
Las sentencias if pertenecen al punto de entrada, no repartidas por todos tus services. Este es uno de los principios arquitectónicos más importantes para mantener un código limpio y centrado que no derive en una complejidad inmantenible.
Así es como el código se deteriora con el tiempo: se escribe un service para un propósito claro y específico. La lógica es limpia y está centrada. Luego llega un nuevo requisito de producto y alguien añade una sentencia if. Unos años y varios requisitos más tarde, ese service está lleno de comprobaciones condicionales para distintos escenarios. El service se ha convertido en:
-
Complicado y difícil de leer
-
Difícil de entender y razonar sobre él
-
Más propenso a errores
-
Violando la responsabilidad única (gestionando demasiados casos distintos)
-
Casi imposible de probar a fondo
El service ha sobrepasado sus límites en cuanto a responsabilidades y lógica.
Una solución: patrón Factory con servicios especializados
Usa el patrón factory para tomar decisiones en el punto de entrada y luego delega en servicios especializados que gestionen su lógica específica sin condicionales.
Ejemplo de nuestra codebase:
BillingPortalServiceFactory determina si la facturación es para una organización, un equipo o un usuario individual, y luego devuelve el servicio adecuado:
export class BillingPortalServiceFactory {
  static async createService(teamId: number): Promise<BillingPortalService> {
    const team = await teamRepository.findById({ id: teamId });
    if (!team) {
      throw new Error("Team not found");
    }
    // Decision made HERE at the entry point
    if (team.isOrganization) {
      return new OrganizationBillingPortalService();
    }
    return new TeamBillingPortalService();
  }

  static createUserService(): UserBillingPortalService {
    return new UserBillingPortalService();
  }
}
Luego cada service gestiona su lógica específica sin necesidad de comprobar "¿soy una org o un team?":
// OrganizationBillingPortalService handles ONLY organization logic
class OrganizationBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "organization.manageBilling",  // Organization-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more organization-specific logic
}

// TeamBillingPortalService handles ONLY team logic
class TeamBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "team.manageBilling",  // Team-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more team-specific logic
}
Por qué esto importa
-
Los services se mantienen centrados
- Cada service tiene una sola responsabilidad y no necesita saber nada de otros contextos.
OrganizationBillingPortalServiceno contiene sentencias if que compruebenif (isTeam)oif (isUser). Solo sabe cómo gestionar organizaciones.
- Cada service tiene una sola responsabilidad y no necesita saber nada de otros contextos.
-
Los cambios quedan aislados
- Cuando necesites modificar la lógica de facturación de la organización, solo tocas
OrganizationBillingPortalService. No te arriesgas a romper la facturación del equipo o del usuario. No necesitas rastrear condicionales anidados para averiguar qué ruta toma tu código.
- Cuando necesites modificar la lógica de facturación de la organización, solo tocas
-
Probarlo es sencillo
- Prueba cada servicio de forma independiente con sus casos concretos. No hace falta probar todas las combinaciones de condicionales entre distintos contextos.
-
Los nuevos requisitos no ensucian el código existente
- Por ejemplo, cuando necesites añadir facturación Enterprise con reglas distintas, creas
EnterpriseBillingPortalService. La fábrica gana un condicional más, pero los servicios existentes siguen intactos y centrados.
- Por ejemplo, cuando necesites añadir facturación Enterprise con reglas distintas, creas
Cómo conseguirlo
-
Lleva los condicionales hacia arriba, a los controladores, las fábricas o la lógica de routing. Deja que esos puntos de entrada decidan qué servicio usar.
-
Mantén los servicios puros y centrados en una sola responsabilidad. Si un servicio necesita comprobar "¿qué tipo soy?", probablemente necesitas varios servicios.
-
Prefiere el polimorfismo a los condicionales
- Las interfaces definen el contrato. Las implementaciones concretas aportan los detalles.
-
Vigila la acumulación de if
- Durante la revisión de código, si ves que un servicio va ganando condicionales para distintos escenarios, es señal de que hay que refactorizarlo en servicios especializados.
Diseño de API: controladores ligeros y abstracción HTTP
-
Los controladores son capas ligeras que solo gestionan las preocupaciones de HTTP.
- Reciben peticiones, las procesan y mapean los datos a DTOs que se pasan a la lógica principal de la aplicación. A partir de ahora, no debería verse lógica de la aplicación ni del core en las rutas de la API ni en los handlers de tRPC.
-
Debemos desacoplar la tecnología HTTP de nuestra aplicación.
- La forma en que transferimos datos entre cliente y servidor (ya sea REST, tRPC, etc.) no debería influir en cómo funciona nuestra aplicación principal. HTTP es un mecanismo de entrega, no un motor arquitectónico.
Responsabilidades del controlador (y SOLO estas):
-
Recibir y validar las peticiones entrantes
-
Extraer datos de los parámetros, el cuerpo y las cabeceras de la petición
-
Transformar los datos de la petición en DTOs
-
Llamar a los servicios de aplicación adecuados con esos DTOs
-
Transformar las respuestas de los servicios de aplicación en DTOs de respuesta
-
Devolver respuestas HTTP con los códigos de estado correctos
Los controladores NO deberían:
-
Contener lógica de negocio ni reglas de dominio
-
Acceder directamente a bases de datos o servicios externos
-
Realizar transformaciones de datos o cálculos complejos
-
Tomar decisiones sobre lo que debe hacer la aplicación
-
Conocer detalles de implementación del dominio
Ejemplo de patrón de controlador delgado:
// Good: Thin controller
export async function createBookingHandler(req: Request, res: Response) {
  // Extract and validate request data
  const createBookingRequest = validateCreateBookingRequest(req.body);
  // Transform to DTO
  const createBookingDto = {
    userId: req.user.id,
    eventTypeId: createBookingRequest.eventTypeId,
    startTime: createBookingRequest.startTime,
    // ... other fields
  };
  // Delegate to application service
  const result = await bookingApplicationService.createBooking(createBookingDto);
  // Transform response and return
  const responseDto = mapBookingToResponseDto(result);
  res.status(201).json(responseDto);
}

// Bad: Fat controller with business logic
export async function createBookingHandler(req: Request, res: Response) {
  // This is wrong - business logic in controller
  if (req.body.startTime < new Date()) {
    return res.status(400).json({ error: "Cannot book in the past" });
  }

  // This is wrong - direct database access
  const existingBooking = await prisma.booking.findFirst({
    where: { eventTypeId: req.body.eventTypeId, startTime: req.body.startTime }
  });

  // This is wrong - complex business calculations
  const duration = calculateBookingDuration(req.body.eventTypeId);
  // ... more business logic
}
Versionado de API y cambios incompatibles
No hay cambios incompatibles. Esto es crítico. Una vez que un endpoint de la API es público, debe seguir siendo estable. Los cambios incompatibles destruyen la confianza de los desarrolladores y crean pesadillas de integración para nuestros usuarios.
Estrategias para evitar cambios incompatibles:
-
Añade siempre los nuevos campos como opcionales
-
Usa versionado de API cuando tengas que cambiar el comportamiento existente
-
Obsoleta los endpoints antiguos de forma gradual, con rutas de migración claras
-
Mantén la compatibilidad hacia atrás durante al menos dos versiones principales
Cuando tengas que hacer cambios incompatibles:
-
Crea una nueva versión de API usando el versionado con fecha en API v2 (quizá también investiguemos el versionado por nombre que Stripe ha introducido recientemente)
-
Ejecuta ambas versiones simultáneamente durante la transición (ya hacemos esto en API v2)
-
Proporciona herramientas automáticas de migración cuando sea posible
-
Da a los usuarios tiempo suficiente para migrar (mínimo 6 meses para APIs públicas)
-
Documenta exactamente qué cambió y por qué
Rendimiento y complejidad algorítmica
Construimos para organizaciones y equipos grandes. Lo que funciona bien con 10 usuarios o 50 registros puede hundirse bajo el peso de una escala empresarial. El rendimiento no es algo que optimizamos más tarde. Es algo que construimos bien desde el principio.
Piensa en la escala desde el primer día
Cuando construyas funcionalidades, pregúntate siempre: "¿Cómo se comporta esto con 1.000 usuarios? ¿10.000 registros? ¿100.000 operaciones?" La diferencia entre algoritmos O(n) y O(n²) puede ser imperceptible en desarrollo, pero catastrófica en producción.
Patrones O(n²) comunes que debes evitar:
-
Iteraciones anidadas de arrays (
.mapdentro de.map,.forEachdentro de.forEach) -
Métodos de array como
.some,.findo.filterdentro de bucles o callbacks -
Comprobar cada elemento contra todos los demás sin optimización
-
Filtros encadenados o mapeos anidados sobre listas grandes
Ejemplo real: Para 100 franjas disponibles y 50 periodos ocupados, un algoritmo O(n²) hace 5.000 comprobaciones. Llévalo a 500 franjas y 200 periodos ocupados, y estarás haciendo 100.000 operaciones. Eso supone un aumento de 20x en la carga computacional por solo un aumento de 5x en los datos.
Elige las estructuras de datos y los algoritmos adecuados
La mayoría de los problemas de rendimiento se resuelven eligiendo mejores estructuras de datos y algoritmos:
-
Ordenación + salida anticipada: ordena tus datos una sola vez y luego sal de los bucles cuando sepas que los elementos restantes no van a coincidir
-
Búsqueda binaria: usa búsqueda binaria para consultas en arrays ordenados en lugar de recorridos lineales
-
Técnicas de dos punteros: para fusionar o intersectar secuencias ordenadas, recórrelas ambas con punteros en lugar de bucles anidados
-
Mapas/conjuntos hash: usa objetos o Sets para búsquedas O(1) en lugar de
.findo.includessobre arrays -
Árboles de intervalos: para scheduling, disponibilidad y consultas por rangos, usa estructuras de árbol adecuadas en lugar de comparaciones a fuerza bruta
Transformación de ejemplo:
// Bad: O(n²) - checks every slot against every busy time
availableSlots.filter(slot => {
  return !busyTimes.some(busy => checkOverlap(slot, busy));
});

// Good: O(n log n) - sort once, break early
const sortedBusy = [...busyTimes].sort((a, b) => a.start - b.start);
availableSlots.filter(slot => {
  for (const busy of sortedBusy) {
    if (busy.start >= slot.end) break; // No more overlaps possible
    if (busy.end <= slot.start) continue; // This one doesn't overlap
    return false; // Overlap found
  }
  return true;
});
Comprobaciones automáticas de rendimiento
Vamos a implementar varias capas de defensa contra regresiones de rendimiento:
Reglas de linting que detecten:
-
Funciones con bucles anidados o métodos de array anidados
-
Varias llamadas anidadas a
.some,.findo.filter -
Recursión sin memoización
-
Anti-patrones conocidos para nuestro dominio (scheduling, comprobaciones de disponibilidad, etc.)
Benchmarks de rendimiento en CI que:
-
Ejecuten algoritmos críticos con datos realistas y a gran escala
-
Comparen los tiempos de ejecución con una base de referencia en cada PR
-
Bloqueen merges que introduzcan regresiones de rendimiento
-
Prueben con datos a escala Enterprise (miles de usuarios, decenas de miles de registros)
Monitorización en producción que:
-
Haga seguimiento del tiempo de ejecución de rutas críticas
-
Alerta cuando los algoritmos se ralentizan a medida que crecen los datos
-
Detecte regresiones antes de que los usuarios las noten
-
Proporcione datos de rendimiento del mundo real para guiar las optimizaciones
El rendimiento es una funcionalidad
El rendimiento no es opcional. No es algo que "dejemos para más tarde". Para clientes enterprise que hacen reservas en equipos grandes, las respuestas lentas significan pérdida de productividad y usuarios frustrados (nuestra experiencia con algunos clientes enterprise más grandes puede dar fe de ello).
Todo ingeniero debería:
-
Perfila tu código antes de optimizar, pero piensa en la complejidad desde el principio
-
Prueba con datos realistas y a gran escala (no solo 5 registros de prueba). Ya tenemos scripts de semilla creados. Probablemente haya que ampliarlos.
-
Elige de entrada algoritmos y estructuras de datos eficientes
-
Fíjate en iteraciones anidadas en las revisiones de código
-
Pon en duda cualquier algoritmo que escale con el producto de dos variables
La realidad NP-hard de la planificación
Los problemas de planificación son fundamentalmente NP-hard. Esto significa que, a medida que crece el número de restricciones, participantes o franjas horarias, la complejidad computacional puede dispararse de forma exponencial. La mayoría de los algoritmos óptimos de planificación tienen una complejidad temporal exponencial en el peor caso, así que elegir bien el algoritmo es absolutamente crítico.
Implicaciones en el mundo real:
-
Encontrar la hora óptima de reunión para 10 personas en 3 zonas horarias con restricciones de disponibilidad individuales es computacionalmente costoso
-
Añadir detección de conflictos, búferes y una gran cantidad de otras opciones amplifica el problema
-
Las malas elecciones de algoritmos que van bien para equipos pequeños se vuelven completamente inutilizables para organizaciones grandes
-
Lo que tarda milisegundos para 5 usuarios puede tardar muchos segundos para organizaciones
Estrategias para gestionar la complejidad NP-hard:
-
Usa algoritmos de aproximación que encuentren soluciones "lo bastante buenas" rápido en lugar de soluciones perfectas lentamente
-
Implementa una caché agresiva de horarios y disponibilidad calculados
-
Precálcula los escenarios comunes en horas de baja actividad
-
Divide los grandes problemas de planificación en bloques más pequeños y manejables
-
Establece límites razonables de tiempo de espera y recurre a algoritmos más sencillos cuando haga falta
Por eso el rendimiento no es solo un extra agradable en el software de planificación. Es la base que determina si tu sistema puede escalar para cubrir las necesidades enterprise o si se derrumba con los patrones de uso del mundo real.
Requisitos de cobertura de código
-
Seguimiento global de cobertura
- Hacemos seguimiento de la cobertura global de la base de código como una métrica clave que mejora con el tiempo. Esto nos da visibilidad sobre la madurez de nuestras pruebas y ayuda a identificar las áreas que necesitan atención. El porcentaje de cobertura global se muestra de forma destacada en nuestros paneles.
-
Cobertura del 80%+ para código nuevo
- Toda PR debe tener una cobertura de pruebas cercana al 80%+ para el código que introduce o modifica. Esto se aplica automáticamente en nuestro pipeline de CI. Si añades 50 líneas de código nuevas, esas 50 líneas deben estar cubiertas por pruebas. Si modificas una función existente, tus cambios deben probarse. Esto es cobertura de pruebas global. La cobertura de pruebas unitarias debe estar cerca del 100%, especialmente con la posibilidad de aprovechar la IA para ayudar a generarlas.
Abordando el argumento de que "la cobertura no cuenta toda la historia": Sí, sabemos que la cobertura no garantiza pruebas perfectas. Sabemos que puedes escribir pruebas sin sentido que cubran cada línea pero no prueben nada relevante. Sabemos que la cobertura es solo una métrica entre muchas. Pero, sin duda, es mejor aspirar a un porcentaje alto que no tener ni idea de dónde estás.
Medir el éxito
-
"Velocidad" (lo tomo prestado de Scrum aunque no vayamos a usar Scrum)
- Crecimiento continuo en las estadísticas mensuales (funcionalidades, mejoras, refactorizaciones)
-
Calidad
- Reducir el esfuerzo de PR dedicado a correcciones del 35% actual al 20% o menos antes de finales de 2026 (calculado en función de cambios y altas/bajas de archivos)
-
Salud arquitectónica
- Métricas sobre adhesión a patrones, acoplamiento tecnológico, violaciones de límites
-
Eficiencia de revisión
- PR más pequeños, revisiones más rápidas, menos rondas de feedback
-
Disponibilidad de la aplicación y de la API
- ¿Qué tan cerca estamos del 99.99%?