Engenharia em 2026 e além
Estamos a construir infraestrutura que quase nunca pode falhar. Para conseguir isto, movemo-nos depressa enquanto lançamos software de qualidade incrível sem atalhos nem compromissos. Este documento define os padrões de engenharia que nos vão guiar por 2026 e além.
On this page
- Estrutura da equipa
- Os nossos resultados até agora
- A base da Cal.com permite excelência para coss.com
- Princípios centrais
- 1. Sem qualidade adiada
- 2. Padrões elevados na code review
- 3. Usem-se uns aos outros para fazer o que é certo
- 4. Procura simplicidade
- 5. Automatiza tudo
- Padrões arquitetónicos
- Vertical Slice Architecture: packages/features
- Porque é que as fatias verticais importam
- Diretrizes para a Organização de Funcionalidades
- Benefícios
- Padrão de Repositório e Injeção de Dependências
- Data Transfer Objects (DTOs)
- Padrões de Domain-Driven Design
- Consistência da Codebase
- Move as condicionais para o ponto de entrada da aplicação
- Porque é que isto importa
- Como conseguir
- Design da API: Controllers leves e abstração HTTP
- Versionamento da API e breaking changes
- Desempenho e complexidade algorítmica
- Pensa na escala desde o primeiro dia
- Escolhe as estruturas de dados e os algoritmos certos
- Verificações automáticas de desempenho
- O desempenho é uma funcionalidade
- A realidade NP-difícil do agendamento
- Requisitos de cobertura de código
- Medir o sucesso
Estrutura da equipa
A nossa organização de engenharia é composta por cinco equipas centrais, cada uma com responsabilidades distintas:
-
Foundation Team: Foca-se em estabelecer e manter padrões de código e padrões arquitetónicos. Esta equipa trabalha em colaboração com outras equipas para definir melhores práticas em toda a organização.
-
Consumer, Enterprise, and Platform Teams: Equipas focadas no produto que lançam funcionalidades rapidamente, mantendo os padrões de qualidade definidos neste documento. Estas equipas provam que velocidade e qualidade não são mutuamente exclusivas.
-
Community Team: Responsável por rever rapidamente PRs da comunidade open source, dar feedback e acompanhar esse trabalho até ao merge. Esta equipa garante que os nossos contribuidores open source têm uma ótima experiência e que as suas contribuições cumprem os nossos padrões de qualidade. Manter uma forte cultura de open-source continua a moldar a forma como a Cal.com aborda a colaboração em engenharia e o desenvolvimento de produto.
Os nossos resultados até agora
Os dados falam por si. Ao longo do último ano e meio, transformámos profundamente a forma como construímos software:

Aproximadamente duplicámos o nosso output de engenharia enquanto melhorávamos simultaneamente a qualidade. Ainda mais impressionante é a mudança no que estamos a construir:

Conseguimos realocar cerca de 20% do esforço de engenharia para fora de correções e para funcionalidades, melhorias de performance, refactors e tarefas operacionais. Esta mudança demonstra que investir em qualidade e arquitetura não te atrasa. Acelera-te.
A base da Cal.com permite excelência para coss.com
-
Cal.com é um negócio estável e lucrativo que vamos continuar a fazer crescer.
- Este sucesso dá-nos uma vantagem única enquanto construímos a coss.com. Ao contrário dos primeiros dias da Cal.com, em que precisávamos de avançar depressa para encontrar product-market fit e construir um negócio sustentável, a coss.com começa de uma posição de força.
-
Não precisamos de apressar a coss.com.
- A estabilidade da Cal.com significa que nos podemos permitir construir a coss.com da forma certa desde o primeiro dia. Temos o luxo de implementar estes padrões de engenharia sem a pressão de exigências imediatas do mercado ou restrições de financiamento. Esta é uma posição de partida fundamentalmente diferente.
-
A "lentidão" é um investimento, não um custo.
- Sim, seguir estes padrões pode parecer mais lento no início e até frustrante para alguns engenheiros. Escrever DTOs leva mais tempo do que passar tipos da base de dados diretamente para o frontend. Criar abstrações corretas e injeção de dependências exige mais design inicial. Manter uma cobertura de testes de 80%+ para novo código exige disciplina. Mas esta lentidão aparente é temporária, e o retorno é exponencial.
Considera os retornos compostos...
-
Código arquitetado corretamente desde o início não precisa de refactors massivos mais tarde
-
Uma cobertura de testes elevada evita bugs que, de outra forma, consumiriam semanas de debugging e hotfixes (vê 2023 até meados de 2024)
-
Abstrações corretas tornam a adição de novas funcionalidades dramaticamente mais rápida ao longo do tempo
-
Limites claros e DTOs evitam a erosão arquitetónica que acaba por exigir rewrites completos
A Cal.com trajetória mostra o que acontece quando otimizas para velocidade imediata. Velocidade inicial alta que se degrada gradualmente à medida que a dívida técnica se acumula, os atalhos arquitetónicos criam bloqueios e se gasta cada vez mais tempo a corrigir problemas em vez de construir funcionalidades (vê o gráfico anterior, onde estávamos a gastar 55-60% do esforço de engenharia em correções).
A trajetória da coss.com vai abraçar o poder de construir corretamente desde o primeiro dia. Velocidade inicial ligeiramente mais lenta enquanto se estabelecem padrões corretos, seguida de uma aceleração exponencial à medida que esses padrões trazem retorno e permitem um desenvolvimento mais rápido com maior confiança.
Princípios centrais
1. Sem qualidade adiada
-
Vamos minimizar o "faço isso num PR de follow-up" para pequenos refactors.
- PRs de follow-up para melhorias menores raramente se materializam. Em vez disso, acumulam-se como dívida técnica que nos sobrecarrega meses ou anos depois. Se um pequeno refactor pode ser feito agora, faze-o agora. Os follow-ups devem ser reservados para mudanças substanciais que realmente justifiquem PRs separados ou para casos excecionais e urgentes.
2. Padrões elevados na code review
-
Não deixes PRs passar com muitos nits só para evitar seres "a pessoa chata."
- É precisamente assim que as codebases ficam descuidadas ao longo do tempo. Code review não é ser simpático. É manter os padrões de qualidade que a nossa infraestrutura exige. Cada pormenor conta. Cada violação de padrão conta. Corrige-os antes do merge, não depois.
3. Usem-se uns aos outros para fazer o que é certo
-
Responsabilizamo-nos mutuamente pela qualidade
- Correr atalhos pode parecer mais rápido no momento, mas cria problemas que abrandam toda a gente mais tarde. Quando vires um colega prestes a fazer merge de um PR com problemas óbvios, fala. Quando alguém sugerir um hack rápido em vez da solução correta, contrapõe. Quando te tentares poupar a testes ou ignorar padrões arquitetónicos, espera que os teus colegas te desafiem.
-
Isto não é para ser difícil nem para abrandar as pessoas
- É sobre a responsabilidade coletiva pela nossa codebase e pela nossa reputação. Cada atalho que uma pessoa toma torna-se um problema de toda a gente. Cada canto cortado hoje significa mais sessões de debugging, mais hotfixes e mais clientes frustrados amanhã.
-
Torna normal questionar más decisões, com respeito
- Se alguém disser "vamos simplesmente hard-codear isto por agora", a resposta esperada deve ser "o que seria preciso para o fazer da forma correta à primeira?" Se alguém quiser commitar código sem testes, a equipa deve contrapôr. Se alguém sugerir copiar e colar em vez de criar uma abstração correta, assinala isso com respeito.
-
Estamos a construir algo que quase nunca pode falhar
- Esse nível de fiabilidade não acontece por acaso. Acontece quando cada engenheiro se sente responsável pela qualidade, não apenas pelo seu próprio código, mas pelo sistema inteiro. Ou vencemos como equipa ou falhamos como equipa.
4. Procura simplicidade
-
Prioriza clareza em vez de esperteza
- O objetivo é código que seja fácil de ler e perceber rapidamente, não complexidade elegante. Sistemas simples reduzem a carga cognitiva de cada engenheiro.
-
Faz-te as perguntas certas
-
Estou mesmo a resolver o problema em questão?
-
Estou a pensar demasiado em possíveis casos de uso futuros?
-
Considerei pelo menos 1 alternativa para resolver isto? Como é que se compara?
-
-
Simples não significa sem funcionalidades
- Só porque o nosso objetivo é criar sistemas simples, isso não quer dizer que devam parecer anémicos e sem funcionalidades óbvias.
5. Automatiza tudo
-
Aproveita a AI
-
Gera 80% do código boilerplate e do código não crítico usando IA, permitindo-nos concentrar apenas na lógica de negócio complexa e em arquiteturas críticas. As Teams que adotam workflows modernos assistidos por IA estão cada vez mais a recorrer a ferramentas como os melhores servidores MCP para melhorar a produtividade dos developers e a orquestração.
-
Constrói alertas sem ruído e tratamento inteligente de erros.
-
Os testes manuais são cada vez mais coisa do passado. A AI pode construir suites de testes gigantes para nós de forma rápida e inteligente.
-
-
A nossa CI é o boss final
-
Tudo neste documento de padrões é verificado antes de o código ser merged em PRs
-
Não entram surpresas em main
-
As verificações são rápidas e úteis
-
Padrões arquitetónicos
Estamos a transitar para um modelo arquitetónico rigoroso baseado em Vertical Slice Architecture e Domain-Driven Design (DDD). Os padrões e princípios seguintes serão aplicados com rigor nas PR reviews e através de linting.
Vertical Slice Architecture: packages/features
A nossa codebase está organizada por domínio, e não por camada técnica. O diretório packages/features é o coração desta abordagem arquitetónica. Cada pasta no seu interior representa uma fatia vertical completa da aplicação, guiada pelo domínio que toca.
Estrutura:
packages/features/
  availability/
  bookings/
  ooo/
  payments/
  routing/
  scheduling/
  ...
Cada pasta de feature é uma fatia vertical autónoma que inclui tudo o que é necessário para esse domínio:
-
Lógica de domínio: As regras de negócio centrais e as entidades específicas dessa feature
-
Serviços da aplicação: Orquestração de casos de uso para esse domínio
-
Repositórios: Acesso a dados específico das necessidades dessa feature
-
DTOs: Objetos de transferência de dados para atravessar fronteiras
-
Componentes de UI: Componentes frontend relacionados com esta feature (quando aplicável)
-
Testes: Testes unitários, de integração e e2e para esta feature
Porque é que as fatias verticais importam
A arquitetura tradicional em camadas organiza-se por preocupações técnicas:
// Bad: Organized by layer
src/
  controllers/
    AvailabilityController.ts
    BookingController.ts
    OOOController.ts
  services/
    AvailabilityService.ts
    BookingService.ts
    OOOService.ts
  repositories/
    AvailabilityRepository.ts
    BookingRepository.ts
    OOORepository.ts
Isto cria vários problemas:
-
Alterações numa feature obrigam a mexer em ficheiros espalhados por vários diretórios
-
É difícil perceber o que uma funcionalidade faz porque o seu código está fragmentado
-
As Teams atropelam-se mutuamente quando trabalham em funcionalidades diferentes
-
Não consegues extrair ou descontinuar facilmente uma funcionalidade
A arquitetura em fatias verticais organiza por domínio:
// Good: Organized by domain
packages/features/
  availability/
    services/
      AvailabilityApplicationService.ts
      AvailabilityDomainService.ts
    repositories/
      AvailabilityRepository.ts
    dto/
      AvailabilityDto.ts
bookings/
  services/
    BookingApplicationService.ts
    BookingDomainService.ts
  repositories/
    BookingRepository.ts
  dto/
    BookingDto.ts
Isto resolve estes problemas:
-
Tudo o que está relacionado com disponibilidade vive em
packages/features/availability -
Podes հասկender toda a funcionalidade de disponibilidade explorando uma única pasta
-
As Teams podem trabalhar em funcionalidades diferentes sem conflitos (se a equipa de engenharia da Cal.com crescer, mas muito provavelmente em coss.com teremos teams a assumir grandes pacotes)
-
As funcionalidades são fracamente acopladas e podem evoluir de forma independente
Diretrizes para a Organização de Funcionalidades
Em teoria, cada funcionalidade pode ser implantada de forma independente. Embora possamos não as implantar separadamente na prática, organizar assim obriga-nos a manter as dependências claras e o acoplamento ao mínimo. Este é o princípio e o sucesso dos microsserviços, embora ainda não estejamos a implantar microsserviços.
As funcionalidades comunicam através de interfaces bem definidas. Se bookings precisa de dados de availability, importa de @calcom/features/availability através de interfaces exportadas, e não a ir buscar detalhes internos da implementação.
O código partilhado vive nos sítios adequados:
-
Utilitários agnósticos ao domínio e preocupações transversais (auth, logging):
packages/lib -
Primitivos de UI partilhados:
packages/ui(e em breve coss.com ui)
Os limites do domínio são aplicados automaticamente. Vamos criar linting que impede ir às entranhas das funcionalidades onde não deves poder entrar. Se packages/features/bookings tentar importar de packages/features/availability/services/internal, o linter bloqueia. Todas as dependências entre funcionalidades têm de passar pela API pública da funcionalidade.
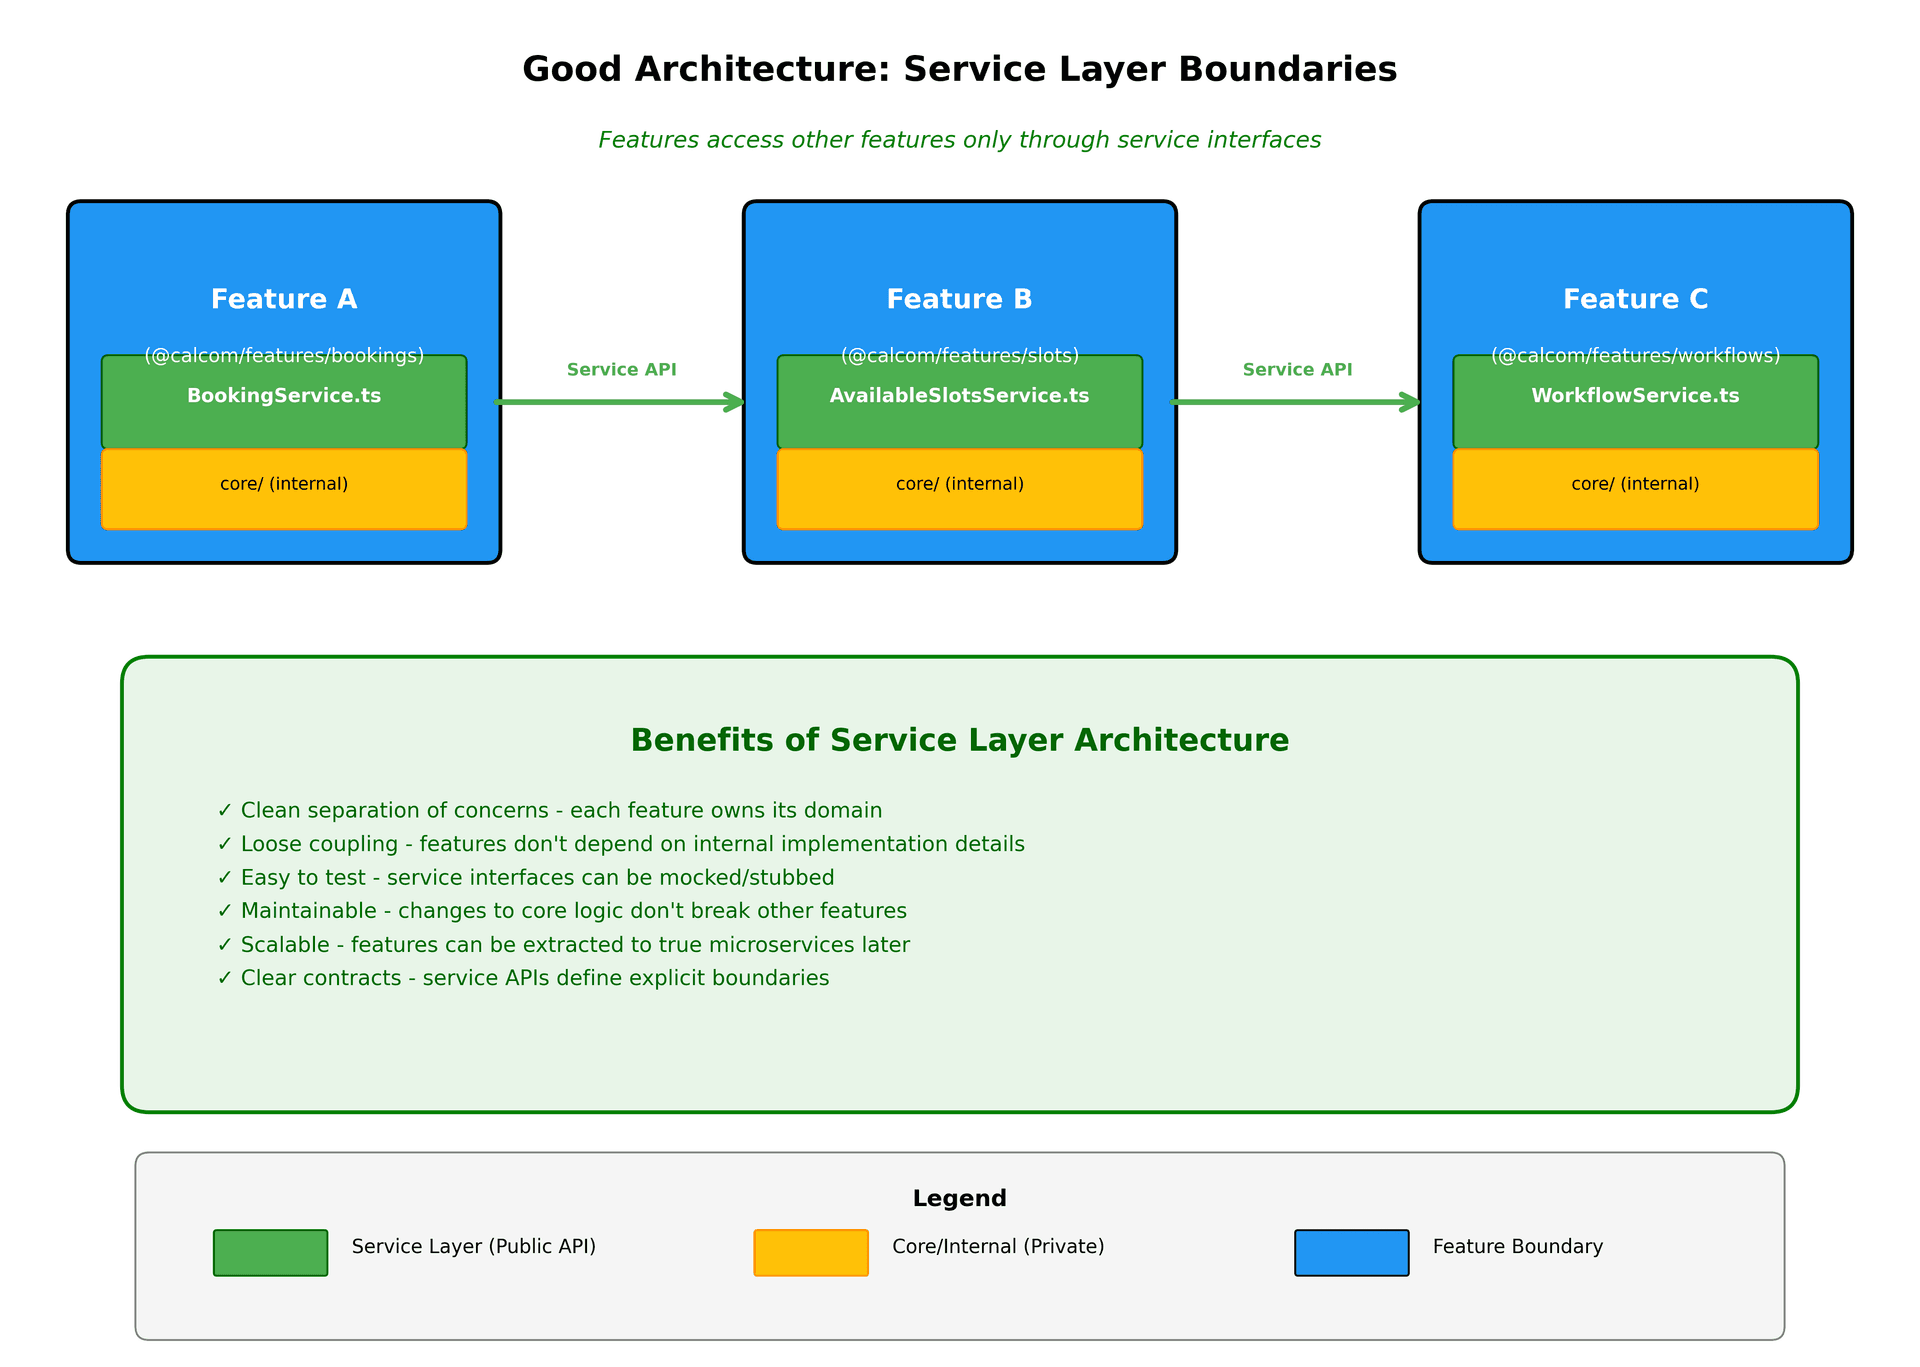
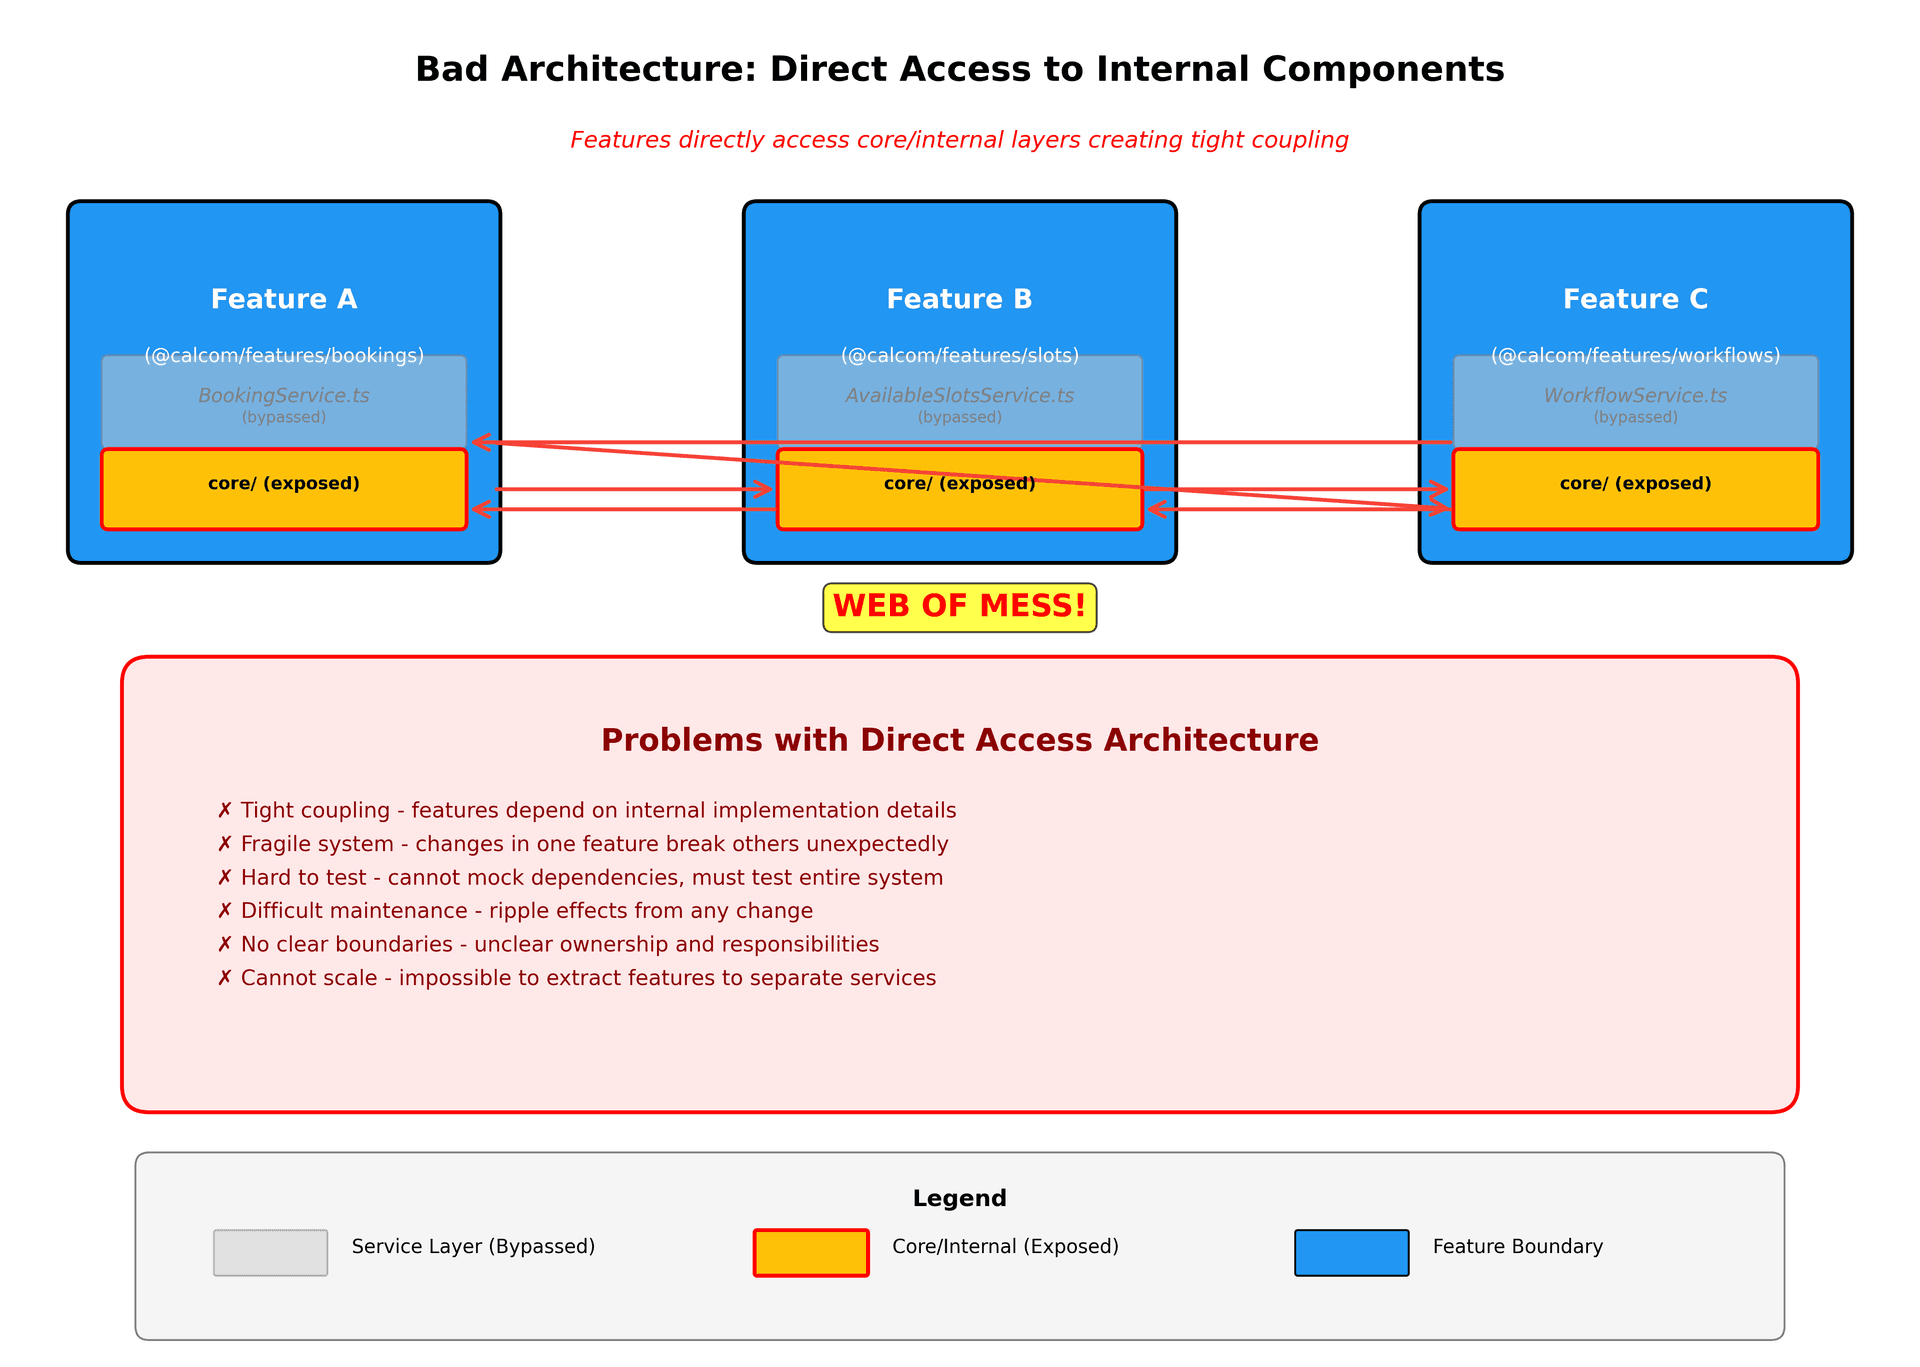
As novas funcionalidades começam como fatias verticais. Quando estiveres a construir algo novo, cria uma nova pasta em packages/features com a fatia vertical completa. Isto torna claro o que estás a construir e mantém tudo organizado desde o primeiro dia.
Benefícios
-
Facilidade de descoberta
- A procurar a lógica de booking? Está toda em
packages/features/bookings. Não precisas de andar à procura por controllers, services, repositories e utilities espalhados pela codebase.
- A procurar a lógica de booking? Está toda em
-
Testes mais fáceis
- Testa a funcionalidade inteira como uma unidade. Tens todas as peças no mesmo sítio, o que torna os testes de integração naturais e diretos.
-
Dependências mais claras
- Quando vês
import { getAvailability } from '@calcom/features/availability', sabes exatamente de que funcionalidade dependes. Quando as dependências ficam demasiado complexas, isso é óbvio e pode ser resolvido.
- Quando vês
Padrão de Repositório e Injeção de Dependências
As escolhas de tecnologia não devem infiltrar-se pela aplicação. O problema do Prisma ilustra isto na perfeição. Atualmente temos referências a Prisma espalhadas por centenas de ficheiros. Isto cria um acoplamento enorme e torna mudanças de tecnologia proibitivamente caras. Estamos a sentir agora a dor de atualizar o Prisma para v6.16. Algo que devia ter sido apenas uma refatoração localizada, por trás de repositórios protegidos, acabou por ser uma perseguição sinuosa, quase sem fim, de problemas por várias apps.
O padrão daqui para a frente:
-
Todo o acesso à base de dados tem de passar por classes Repository. Já temos uma boa vantagem inicial nisto.
-
Os repositories são o único código que conhece Prisma (ou qualquer outro ORM). Não deve haver lógica dentro deles.
-
Os repositories são injetados através de contentores de Dependency Injection
-
Se alguma vez mudarmos de Prisma para Drizzle ou outro ORM, as únicas alterações necessárias são:
-
Implementações dos repositories
-
Ligação do contentor de DI para os novos repositories
-
Mais nada na codebase deve importar-se ou mudar
-
Isto não é teórico. É assim que construímos sistemas mantíveis.
Data Transfer Objects (DTOs)
Os tipos da base de dados não devem vazar para o frontend. Isto tornou-se um atalho popular na nossa stack tecnológica, mas é um code smell que cria vários problemas.
-
Acoplamento tecnológico (os tipos do Prisma acabam em componentes React)
-
Riscos de segurança (vazamento acidental de campos sensíveis)
-
Contratos frágeis entre servidor e cliente (isto é particularmente problemático à medida que construímos muito mais APIs)
-
Incapacidade de evoluir o esquema da base de dados de forma independente
-
Todas as conversões de DTOs através de Zod, até mesmo para uma resposta de API, para garantir que todos os dados são validados antes de serem enviados ao utilizador. É melhor falhar do que devolver algo errado.
O padrão daqui para a frente:
Cria DTOs explícitos em cada fronteira arquitetónica.
-
Camada de dados → Camada de aplicação → API: Transforma os modelos da base de dados em DTOs da camada de aplicação, depois transforma os DTOs da aplicação em DTOs específicos da API
-
API → Camada de aplicação → Camada de dados: Transforma os DTOs da API através da camada de aplicação e em DTOs específicos dos dados
Sim, isto requer mais código. Sim, vale a pena. Fronteiras explícitas evitam a erosão arquitetónica que cria pesadelos de manutenção a longo prazo.
Padrões de Domain-Driven Design
Os seguintes padrões têm de ser usados corretamente e de forma consistente:
-
Application Services
- Orquestram casos de uso, coordenam entre domain services e repositories
-
Domain Services
- Contêm lógica de negócio que não pertence naturalmente a uma única entidade
-
Repositories
- Abstraem o acesso aos dados, isolam escolhas tecnológicas
-
Dependency Injection
- Permite baixo acoplamento, facilita testes, isola responsabilidades
-
Caching Proxies
-
Envolvem repositories ou serviços para adicionar comportamento de cache de forma transparente
-
Não é a única forma de fazer cache, claro, mas é um bom ponto de partida
-
-
Decorators
- Adicionam preocupações transversais (logging, metrics, etc.) sem poluir a lógica de domínio
Consistência da Codebase
As nossas codebases deviam dar a sensação de que uma só pessoa as escreveu. Este nível de consistência exige adesão rigorosa a padrões estabelecidos, regras de linting abrangentes que impõem padrões arquitetónicos, code reviews que rejeitam violações de padrões + a ajuda de revisores de código com IA.
Move as condicionais para o ponto de entrada da aplicação
As instruções if pertencem ao ponto de entrada, não espalhadas pelos teus services. Este é um dos princípios arquitetónicos mais importantes para manter código limpo e focado, que não descamba para uma complexidade impossível de manter.
É assim que o código se degrada ao longo do tempo: Um service é escrito para um propósito claro e específico. A lógica é limpa e focada. Depois surge um novo requisito de produto, e alguém acrescenta uma instrução if. Uns anos e mais alguns requisitos depois, esse service está cheio de verificações condicionais para diferentes cenários. O service tornou-se:
-
Complicado e difícil de ler
-
Difícil de compreender e raciocinar
-
Mais suscetível a bugs
-
A violar a responsabilidade única (a tratar de demasiados casos diferentes)
-
Quase impossível de testar de forma exaustiva
O service ultrapassou os seus limites em termos de responsabilidades e lógica.
Uma solução: padrão Factory com serviços especializados
Usa o padrão factory para tomar decisões no ponto de entrada e depois delega em serviços especializados que tratam da sua lógica específica sem condicionais.
Exemplo da nossa codebase:
BillingPortalServiceFactory determina se a faturação é para uma organização, equipa ou utilizador individual e depois devolve o service apropriado:
export class BillingPortalServiceFactory {
  static async createService(teamId: number): Promise<BillingPortalService> {
    const team = await teamRepository.findById({ id: teamId });
    if (!team) {
      throw new Error("Team not found");
    }
    // Decision made HERE at the entry point
    if (team.isOrganization) {
      return new OrganizationBillingPortalService();
    }
    return new TeamBillingPortalService();
  }

  static createUserService(): UserBillingPortalService {
    return new UserBillingPortalService();
  }
}
Cada service trata então da sua lógica específica sem precisar de verificar "sou uma org ou uma equipa?":
// OrganizationBillingPortalService handles ONLY organization logic
class OrganizationBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "organization.manageBilling",  // Organization-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more organization-specific logic
}

// TeamBillingPortalService handles ONLY team logic
class TeamBillingPortalService extends BillingPortalService {
  async checkPermissions(userId: number, teamId: number): Promise<boolean> {
    return await this.permissionService.checkPermission({
      userId,
      teamId,
      permission: "team.manageBilling",  // Team-specific
      fallbackRoles: [MembershipRole.ADMIN, MembershipRole.OWNER],
    });
  }
  // ... more team-specific logic
}
Porque é que isto importa
-
Os services mantêm-se focados
- Cada service tem uma responsabilidade e não precisa de saber sobre outros contextos. O
OrganizationBillingPortalServicenão contém instruções if a verificarif (isTeam)ouif (isUser). Só sabe como tratar organizações.
- Cada service tem uma responsabilidade e não precisa de saber sobre outros contextos. O
-
As mudanças ficam isoladas
- Quando precisares de modificar a lógica de faturação da organização, só tocas em
OrganizationBillingPortalService. Não riscas romper a faturação da equipa ou do utilizador. Não precisas de seguir condicionais aninhadas para perceber que caminho o teu código toma.
- Quando precisares de modificar a lógica de faturação da organização, só tocas em
-
Os testes são diretos
- Testa cada serviço de forma independente, com os seus cenários específicos. Não há necessidade de testar todas as combinações de condicionais entre contextos diferentes.
-
Os novos requisitos não poluem o código existente
- p.ex. Quando precisas de adicionar faturação enterprise com regras diferentes, crias
EnterpriseBillingPortalService. A fábrica ganha mais um condicional, mas os serviços existentes permanecem intocados e focados.
- p.ex. Quando precisas de adicionar faturação enterprise com regras diferentes, crias
Como conseguir
-
Empurra os condicionais para os controllers, fábricas ou lógica de routing. Deixa que estes pontos de entrada decidam que serviço usar.
-
Mantém os serviços puros e focados numa única responsabilidade. Se um serviço precisa de verificar "que tipo sou eu?", provavelmente precisas de vários serviços.
-
Prefere polimorfismo a condicionais
- As interfaces definem o contrato. As implementações concretas fornecem os detalhes.
-
Tem atenção à acumulação de if statements
- Durante a revisão de código, se vires um serviço a ganhar condicionais para cenários diferentes, isso é um sinal para refatorar em serviços especializados.
Design da API: Controllers leves e abstração HTTP
-
Os controllers são camadas leves que tratam apenas de questões HTTP.
- Recebem pedidos, processam-nos e mapeiam dados para DTOs que são passados para a lógica central da aplicação. Daqui para a frente, não deve haver lógica da aplicação nem lógica central visível em rotas da API ou handlers do tRPC.
-
Temos de desligar a tecnologia HTTP da nossa aplicação.
- A forma como transferimos dados entre cliente e servidor (seja REST, tRPC, etc.) não deve influenciar o funcionamento da nossa aplicação central. HTTP é um mecanismo de entrega, não um motor arquitetural.
Responsabilidades dos controllers (e SÓ estas):
-
Receber e validar pedidos recebidos
-
Extrair dados de parâmetros do pedido, corpo, headers
-
Transformar os dados do pedido em DTOs
-
Chamar os serviços de aplicação apropriados com esses DTOs
-
Transformar as respostas dos serviços de aplicação em DTOs de resposta
-
Devolver respostas HTTP com códigos de estado adequados
Os controllers NÃO devem:
-
Conter lógica de negócio ou regras de domínio
-
Aceder diretamente a bases de dados ou serviços externos
-
Executar transformações de dados complexas ou cálculos
-
Tomar decisões sobre o que a aplicação deve fazer
-
Saber detalhes de implementação do domínio
Exemplo de padrão de controller leve:
// Good: Thin controller
export async function createBookingHandler(req: Request, res: Response) {
  // Extract and validate request data
  const createBookingRequest = validateCreateBookingRequest(req.body);
  // Transform to DTO
  const createBookingDto = {
    userId: req.user.id,
    eventTypeId: createBookingRequest.eventTypeId,
    startTime: createBookingRequest.startTime,
    // ... other fields
  };
  // Delegate to application service
  const result = await bookingApplicationService.createBooking(createBookingDto);
  // Transform response and return
  const responseDto = mapBookingToResponseDto(result);
  res.status(201).json(responseDto);
}

// Bad: Fat controller with business logic
export async function createBookingHandler(req: Request, res: Response) {
  // This is wrong - business logic in controller
  if (req.body.startTime < new Date()) {
    return res.status(400).json({ error: "Cannot book in the past" });
  }

  // This is wrong - direct database access
  const existingBooking = await prisma.booking.findFirst({
    where: { eventTypeId: req.body.eventTypeId, startTime: req.body.startTime }
  });

  // This is wrong - complex business calculations
  const duration = calculateBookingDuration(req.body.eventTypeId);
  // ... more business logic
}
Versionamento da API e breaking changes
Sem breaking changes. Isto é crítico. Assim que um endpoint da API se torna público, tem de permanecer estável. Breaking changes destroem a confiança dos developers e criam pesadelos de integração para os nossos utilizadores.
Estratégias para evitar breaking changes:
-
Adiciona sempre novos campos como opcionais
-
Usa versionamento da API quando tens de mudar o comportamento existente
-
Descontinua endpoints antigos de forma gradual, com caminhos de migração claros
-
Mantém a compatibilidade retroativa durante pelo menos duas versões principais
Quando tens mesmo de fazer breaking changes:
-
Cria uma nova versão da API usando o versionamento específico por data em API v2 (talvez também venhamos a analisar o versionamento por nome que a Stripe introduziu recentemente)
-
Executa ambas as versões em simultâneo durante a transição (já fazemos isto em API v2)
-
Fornece ferramentas automatizadas de migração sempre que possível
-
Dá aos utilizadores tempo suficiente para migrar (mínimo de 6 meses para APIs públicas)
-
Documenta exatamente o que mudou e porquê
Desempenho e complexidade algorítmica
Construímos para grandes organizações e equipas. O que funciona bem com 10 utilizadores ou 50 registos pode colapsar sob o peso de escala enterprise. O desempenho não é algo que otimizamos mais tarde. É algo que construímos corretamente desde o início.
Pensa na escala desde o primeiro dia
Ao construir funcionalidades, pergunta sempre: "Como é que isto se comporta com 1.000 utilizadores? 10.000 registos? 100.000 operações?" A diferença entre algoritmos O(n) e O(n²) pode ser impercetível em desenvolvimento, mas catastrófica em produção.
Padrões comuns O(n²) a evitar:
-
Iterações aninhadas em arrays (
.mapdentro de.map,.forEachdentro de.forEach) -
Métodos de array como
.some,.findou.filterdentro de loops ou callbacks -
Verificar cada item contra todos os outros itens sem otimização
-
Filtros em cadeia ou mapeamento aninhado sobre listas grandes
Exemplo do mundo real: Para 100 intervalos disponíveis e 50 períodos ocupados, um algoritmo O(n²) faz 5.000 verificações. Leva isso para 500 intervalos e 200 períodos ocupados, e estás a fazer 100.000 operações. Isso é um aumento de 20x na carga computacional para apenas um aumento de 5x nos dados.
Escolhe as estruturas de dados e os algoritmos certos
A maioria dos problemas de desempenho resolve-se escolhendo melhores estruturas de dados e algoritmos:
-
Ordenação + saída antecipada: Ordena os teus dados uma vez e depois sai dos loops quando souberes que os itens restantes não vão corresponder
-
Pesquisa binária: Usa pesquisa binária para procuras em arrays ordenados em vez de varrimentos lineares
-
Técnicas de dois ponteiros: Para fundir ou intersectar sequências ordenadas, percorre ambas com ponteiros em vez de loops aninhados
-
Hash maps/sets: Usa objetos ou Sets para pesquisas O(1) em vez de
.findou.includesem arrays -
Árvores de intervalos: Para agendamento, disponibilidade e consultas de intervalos, usa estruturas de árvore adequadas em vez de comparação brute-force
Exemplo de transformação:
// Bad: O(n²) - checks every slot against every busy time
availableSlots.filter(slot => {
  return !busyTimes.some(busy => checkOverlap(slot, busy));
});

// Good: O(n log n) - sort once, break early
const sortedBusy = [...busyTimes].sort((a, b) => a.start - b.start);
availableSlots.filter(slot => {
  for (const busy of sortedBusy) {
    if (busy.start >= slot.end) break; // No more overlaps possible
    if (busy.end <= slot.start) continue; // This one doesn't overlap
    return false; // Overlap found
  }
  return true;
});
Verificações automáticas de desempenho
Vamos implementar várias camadas de defesa contra regressões de desempenho:
Regras de linting que assinalam:
-
Funções com loops aninhados ou métodos de array aninhados
-
Várias chamadas aninhadas de
.some,.findou.filter -
Recursão sem memoização
-
Anti-patterns conhecidos para o nosso domínio (agendamento, verificações de disponibilidade, etc.)
Benchmarks de desempenho em CI que:
-
Executam algoritmos críticos com dados realistas e em grande escala
-
Comparam tempos de execução com a baseline em cada PR
-
Bloqueiam merges que introduzam regressões de desempenho
-
Testam com dados à escala enterprise (milhares de utilizadores, dezenas de milhares de registos)
Monitorização em produção que:
-
Acompanha o tempo de execução dos caminhos críticos
-
Avisa quando os algoritmos abrandam à medida que os dados crescem
-
Deteta regressões antes de os utilizadores repararem
-
Fornece dados reais de desempenho para informar otimizações
O desempenho é uma funcionalidade
O desempenho não é opcional. Não é algo que "deixamos para mais tarde." Para clientes enterprise que reservam em equipas grandes, respostas lentas significam produtividade perdida e utilizadores frustrados (a nossa experiência com alguns clientes enterprise maiores pode ser uma prova disso).
Todos os engenheiros devem:
-
Perfila o teu código antes de otimizar, mas pensa na complexidade desde o início
-
Testa com dados realistas e em grande escala (não apenas 5 registos de teste). Já temos scripts de seed criados. Provavelmente precisamos de os estender.
-
Escolhe algoritmos e estruturas de dados eficientes desde o início
-
Presta atenção a iterações aninhadas na revisão de código
-
Questiona qualquer algoritmo que escale com o produto de duas variáveis
A realidade NP-difícil do agendamento
Os problemas de agendamento são, por natureza, NP-difíceis. Isto significa que, à medida que o número de restrições, participantes ou intervalos de tempo cresce, a complexidade computacional pode explodir exponencialmente. A maioria dos algoritmos ótimos de agendamento tem complexidade temporal exponencial no pior caso, o que torna a escolha do algoritmo absolutamente crítica.
Implicações no mundo real:
-
Encontrar a hora ideal para uma reunião com 10 pessoas em 3 fusos horários, com restrições individuais de disponibilidade, é computacionalmente caro
-
Adicionar deteção de conflitos, intervalos e uma infinidade de outras opções amplifica o problema
-
Más escolhas de algoritmos que funcionam bem para equipas pequenas tornam-se completamente inutilizáveis para grandes organizações
-
O que leva milissegundos para 5 utilizadores pode levar muitos segundos para organizações
Estratégias para gerir a complexidade NP-difícil:
-
Usa algoritmos de aproximação que encontrem soluções "boas o suficiente" rapidamente, em vez de soluções perfeitas lentamente
-
Implementa cache agressiva de horários e disponibilidade calculados
-
Pré-calcula cenários comuns durante horas de menor atividade
-
Divide problemas grandes de agendamento em partes mais pequenas e geríveis
-
Define limites de timeout razoáveis e recorre a algoritmos mais simples quando for preciso
É por isso que o desempenho não é apenas um extra agradável no software de agendamento. É a base que determina se o teu sistema consegue escalar para necessidades enterprise ou se colapsa sob padrões de utilização do mundo real.
Requisitos de cobertura de código
-
Acompanhamento global da cobertura
- Acompanhamos a cobertura global da codebase como uma métrica-chave que melhora ao longo do tempo. Isto dá-nos visibilidade sobre a maturidade dos testes e ajuda a identificar áreas que precisam de atenção. A percentagem global de cobertura é apresentada de forma destacada nos nossos dashboards.
-
Cobertura de 80%+ para novo código
- Todo PR tem de ter uma cobertura de testes próxima de 80%+ para o código que introduz ou modifica. Isto é imposto automaticamente no nosso pipeline de CI. Se adicionares 50 linhas de código novo, essas 50 linhas têm de ser cobertas por testes. Se modificares uma função existente, as tuas alterações têm de ser testadas. Isto é cobertura total de testes. A cobertura dos testes unitários precisa de estar próxima de 100%, especialmente com a possibilidade de aproveitar IA para ajudar a gerar estes testes.
A responder ao argumento de que "a cobertura não conta a história toda": Sim, sabemos que a cobertura não garante testes perfeitos. Sabemos que podes escrever testes sem sentido que acertam em todas as linhas, mas não testam nada de relevante. Sabemos que a cobertura é apenas uma métrica entre muitas. Mas, de certeza que é melhor apontar para uma percentagem alta do que não ter sequer uma noção de onde estás.
Medir o sucesso
-
"Velocidade" (roubei isto do Scrum mesmo sabendo que não vamos usar Scrum)
- Crescimento contínuo nas estatísticas mensais (funcionalidades, melhorias, refactors)
-
Qualidade
- Reduzir o esforço de PR gasto em correções dos atuais 35% para 20% ou menos até ao fim de 2026 (calculado com base em alterações e adições/remoções de ficheiros)
-
Saúde arquitetural
- Métricas de aderência a padrões, acoplamento tecnológico, violações de fronteira
-
Eficiência da revisão
- PRs mais pequenos, revisões mais rápidas, menos rondas de feedback
-
Tempo de atividade da aplicação e da API
- Quão perto estamos de 99.99%?